100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘
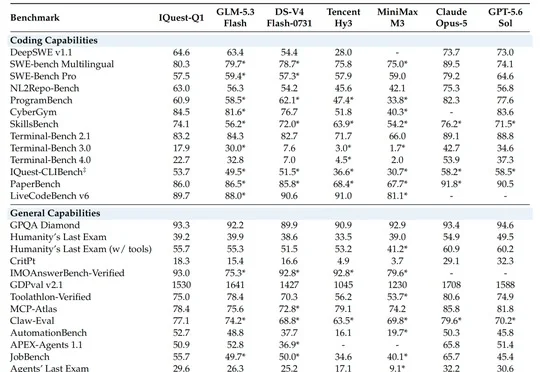
100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
来自主题: AI技术研报
8064 点击 2026-10-24 13:42

 搜索
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
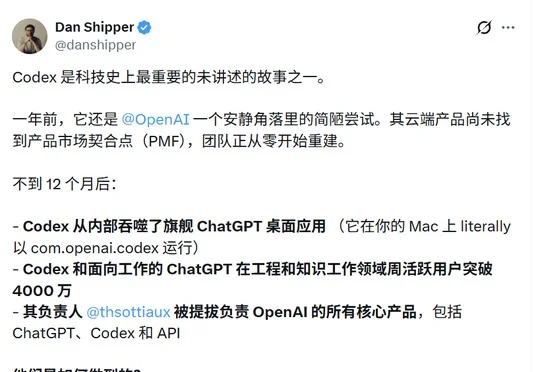
OpenAI的Codex在Tibo接手后从云端转向本地,并推出不含代码编辑器的桌面应用;随着GPT-5.3 Codex拓展至知识工作,Codex于2026年7月成为新版ChatGPT桌面应用,Codex与ChatGPT for Work合计周活超4000万。
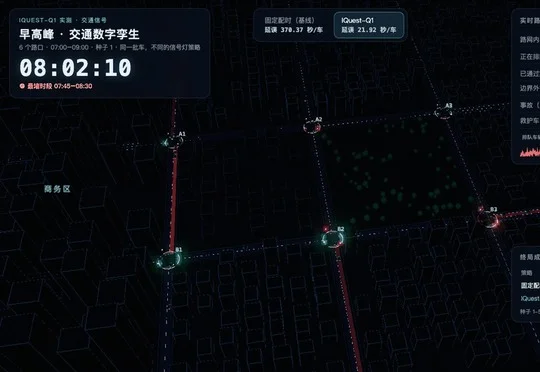
至知创新研究院开源320B大模型IQuest-Q1,该模型在代码生成、安全漏洞挖掘等评测中表现优异,并能自主排查训练Bug,在交通调度、仓库管理、电梯调度等真实场景中展现出强大的任务解决能力。
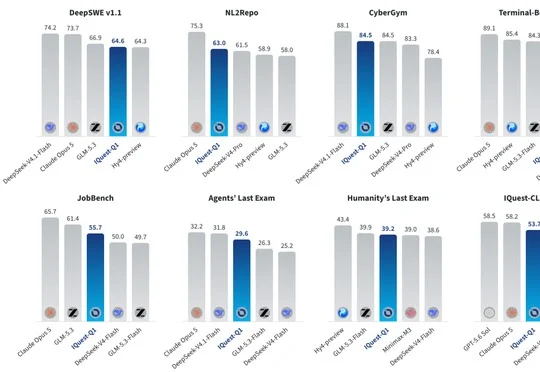
至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。
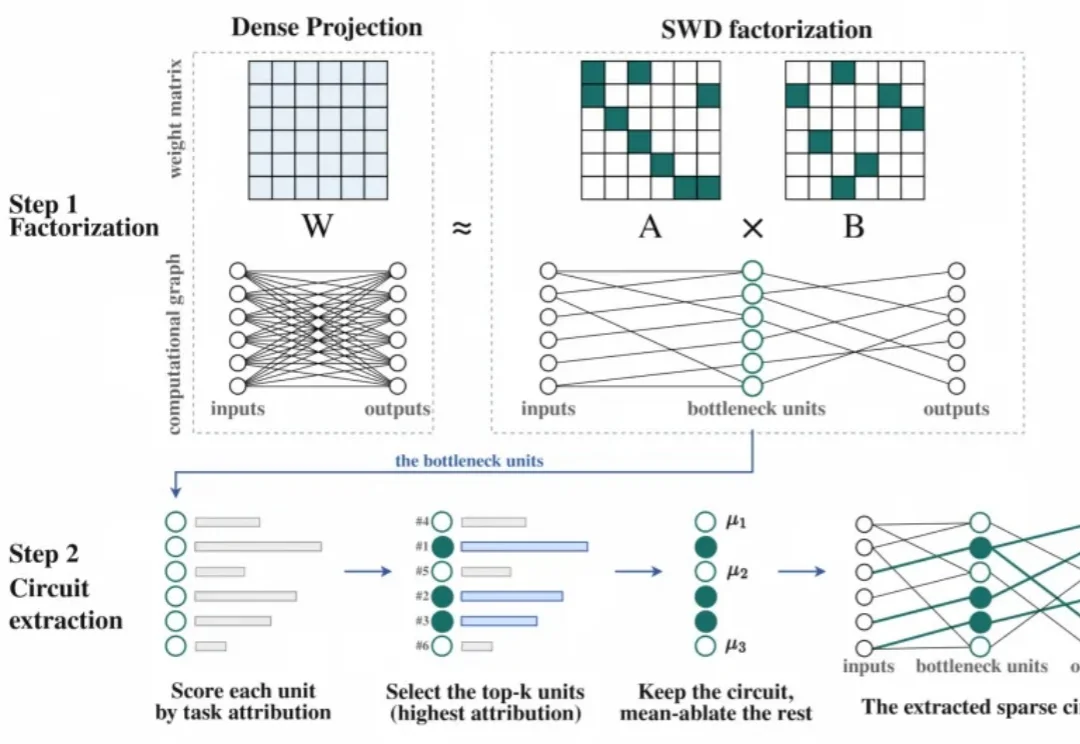
大模型机制可解释性研究中,一直存在一个颇具反差的现实: 为了理解一个已经训练好的模型,研究者往往需要先训练一套新的稀疏表示。
来自至知创新研究院(IQuest Research)、中国人民大学高瓴人工智能学院、KAUST等机构的研究团队提出了FORT,一个面向Deep Search Agent的shortcut-resistant training-data synthesis framework。
大模型从“回答问题”走向“完成任务”,正在面临以下瓶颈:面向Claw Agents的数据、训练和评测都比传统environment training更难。为了解决该问题,中国人民大学、至知研究院等最新提出ClawGym——