押注记忆原生,MemT 1.0 破局养成系 AI 下半场
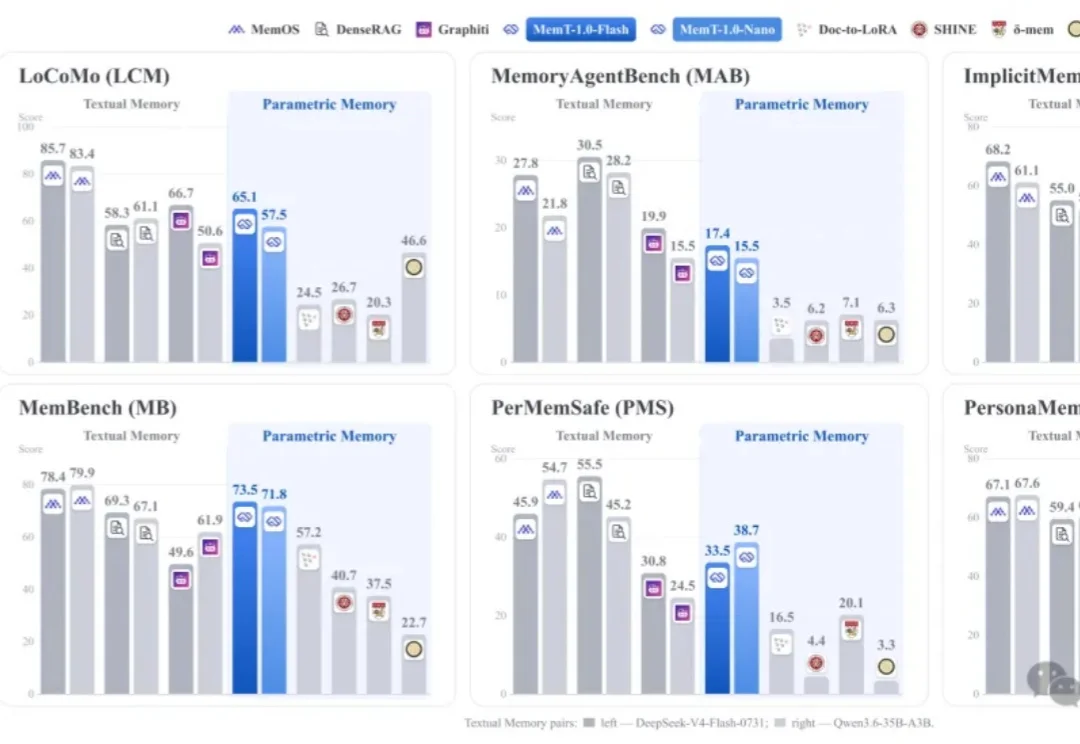
押注记忆原生,MemT 1.0 破局养成系 AI 下半场用 AI 最让人崩溃的瞬间,莫过于你花半天纠正它把任务做对,换个新会话,它转头又踩进同一个坑里。模型做过了事,却没变成它的成长。跑通单次任务之外,它真正缺的是把反馈转化为经验,并在之后主动调用。
来自主题: AI资讯
7000 点击 2026-10-21 11:55

 搜索
用 AI 最让人崩溃的瞬间,莫过于你花半天纠正它把任务做对,换个新会话,它转头又踩进同一个坑里。模型做过了事,却没变成它的成长。跑通单次任务之外,它真正缺的是把反馈转化为经验,并在之后主动调用。
在游戏里,如果你走到一扇门前,不确定能不能进去,通常的做法是先转身往回走两步,再跳两下,看看能不能翻过旁边的墙。
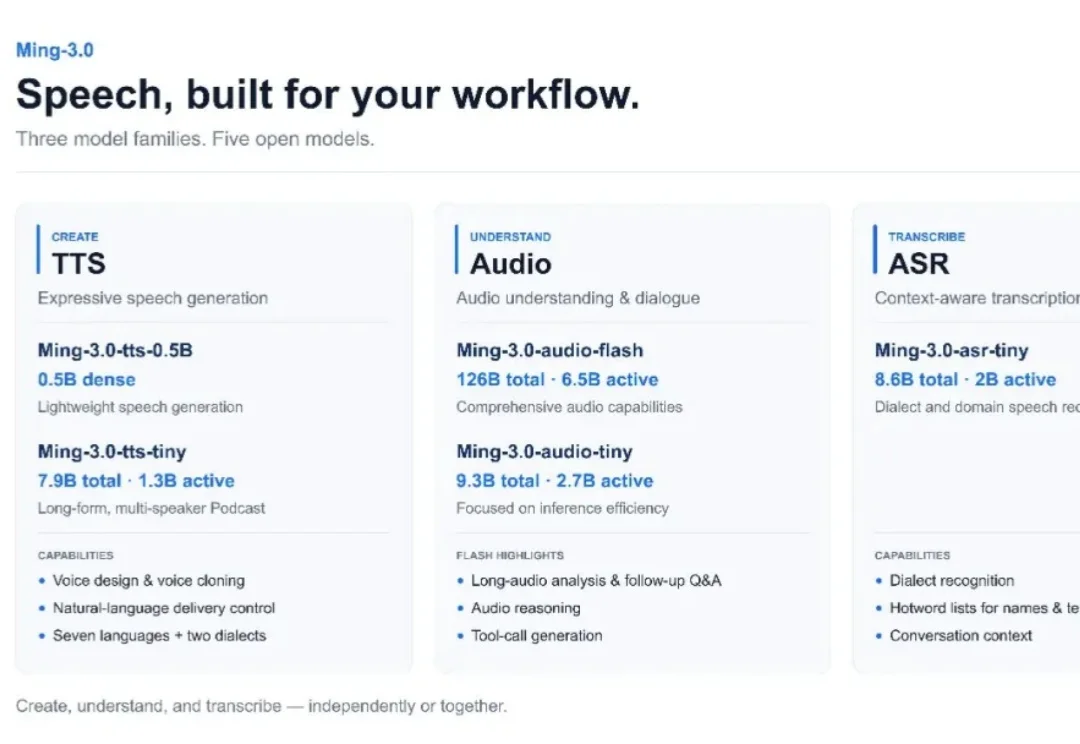
配音、听录音、转写全覆盖。
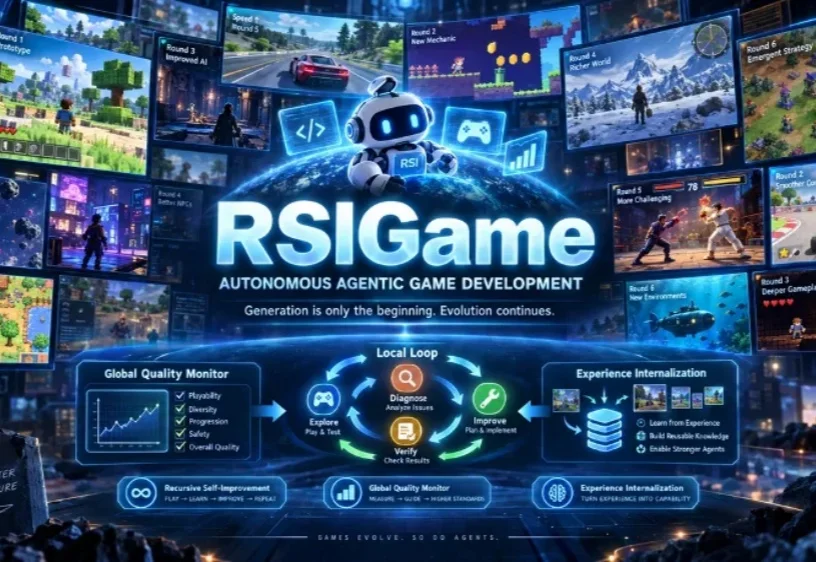
现在的大模型,已经越来越擅长从自然语言直接生成一个可以运行的游戏。
如何把屏幕上罗列的实验流程准确变成一连串的实际操作?这个问题直指 AI 科研落地的核心门槛:AI 能够输出可行的实验方案,却很难自主完成整套线下实操。
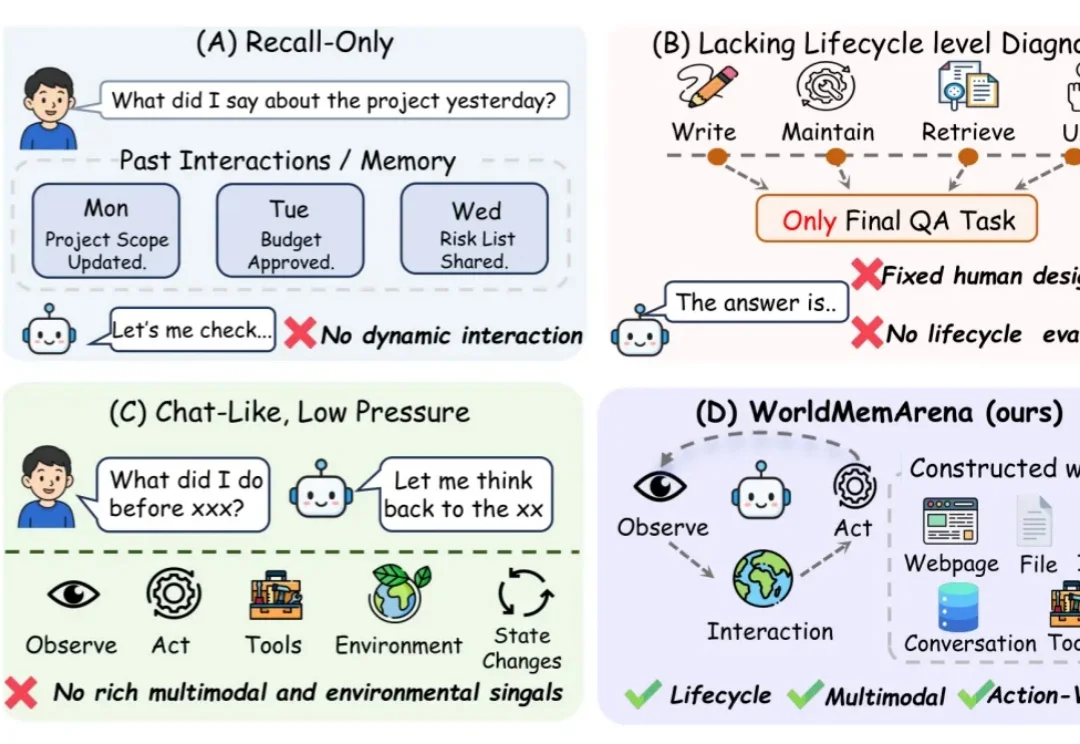
团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
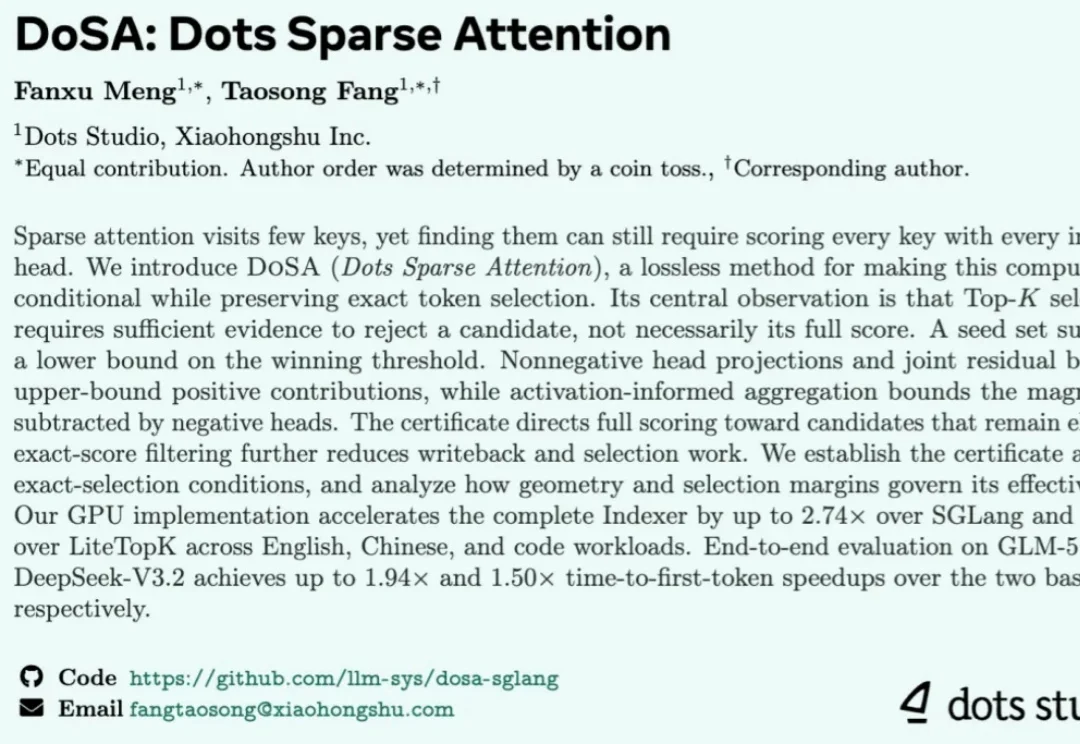
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
AI圈,最近集体盯上了三个字母:RSI。
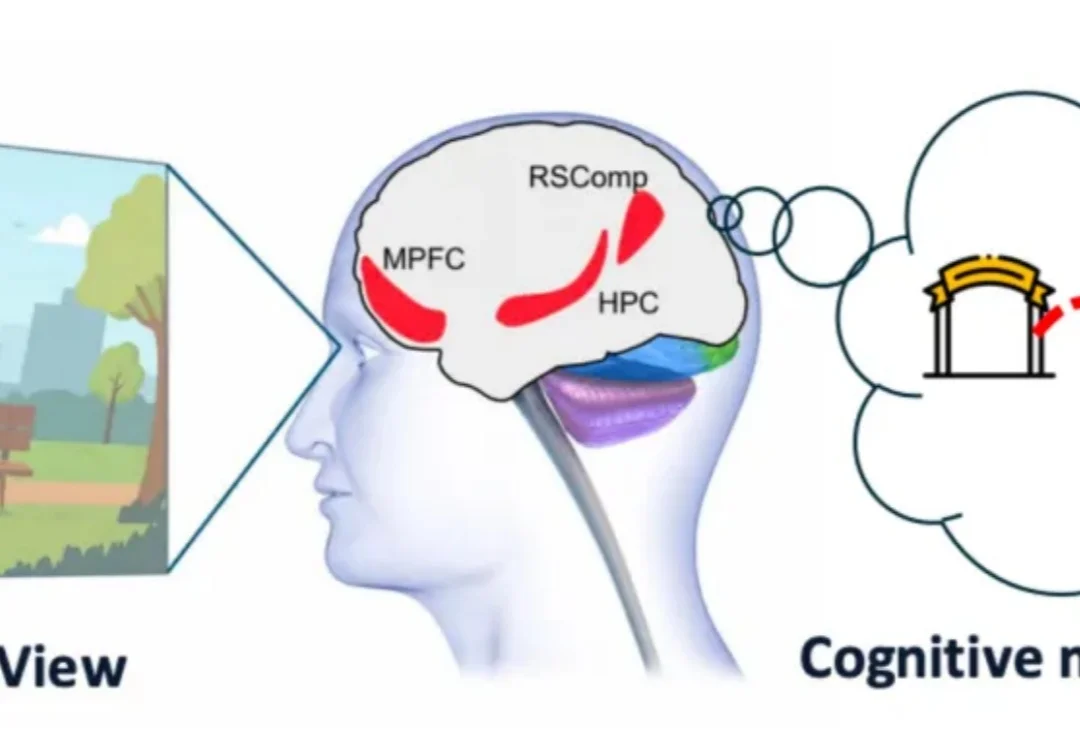
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
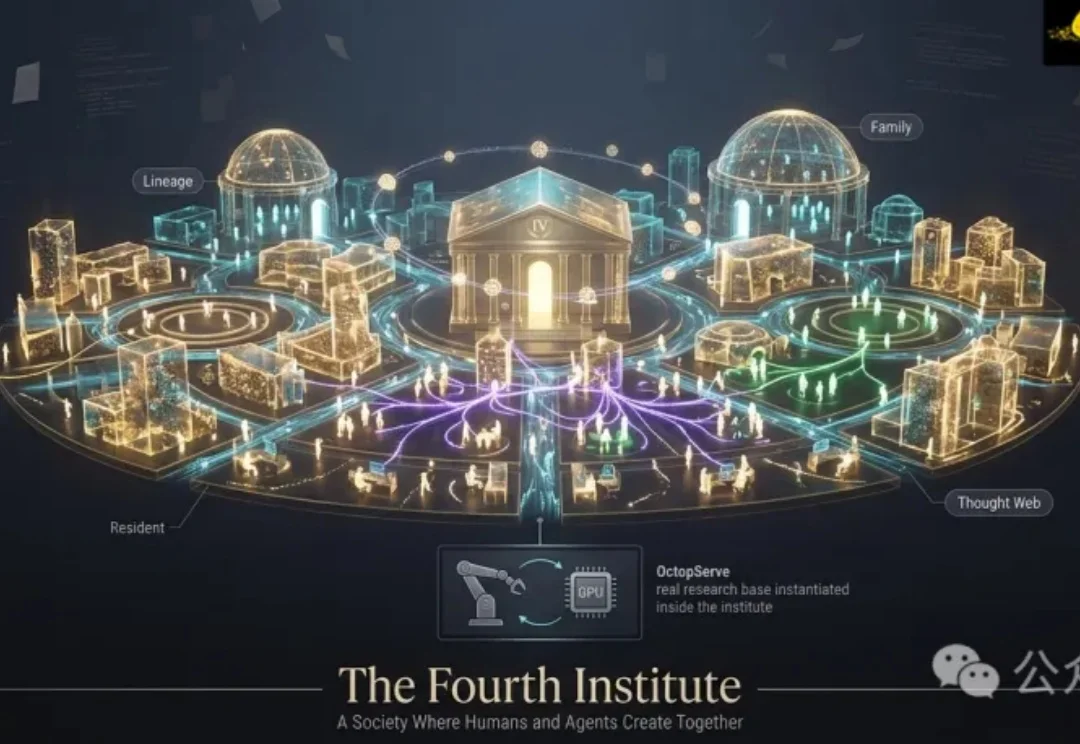
「全球只有大约5,000人,真正见识过顶尖AI的能力。」这是Andrej Karpathy近日分享的一个观察。他说,只有站在漏斗顶端的那一小撮研究者,才能看到数千个AI Agent长时间协作、昼夜不停地做科研。