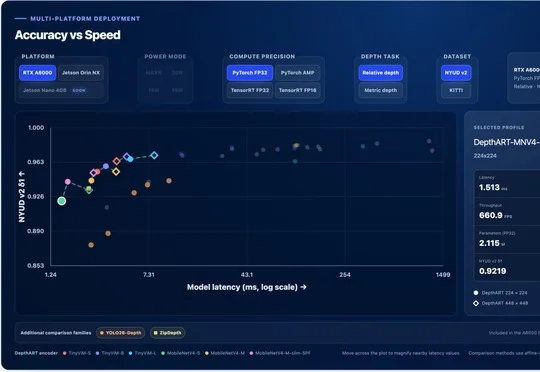
把Depth Anything砍到6M,深度估计终于能跑进Jetson
把Depth Anything砍到6M,深度估计终于能跑进Jetson论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
来自主题: AI技术研报
9493 点击 2026-10-03 10:28

 搜索
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
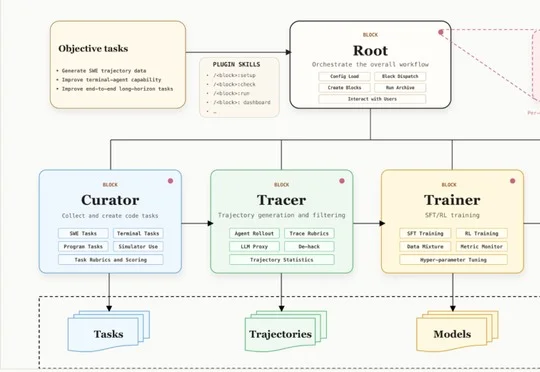
从 1200 万个候选拉取请求中,最终留下 5000 个 SWE 代码任务 —— 不足 0.05%。把「出题、答题、改卷、训练、评测」这条代码数据流水线全自动跑起来,就是 LegoFlow; 在这个过
OpenAI 暂扣了最新旗舰模型 GPT-6.1 Astra,因其「未通过内部安全评估」;推迟了 IPO 进程,理由是「技术演进跨入了新阶段」;同时,它还罕见地公开呼应竞争对手,支持放缓前沿研发节奏。
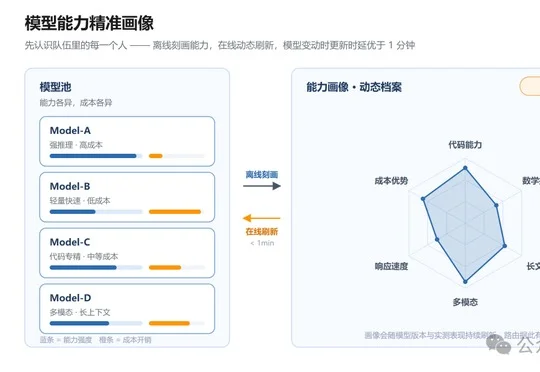
不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
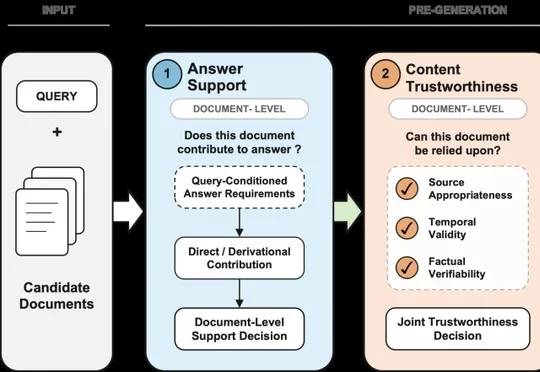
百度联合中国科学院计算技术研究所与武汉大学的研究者围绕这一现状,提出答案支撑、内容可信与上下文组织三阶段框架,并结合百度搜索工业实践,梳理了从检索排序、可信度判断、结构化上下文组织到生成后反馈的优化链路。
RSI(Recursive Self-Improvement,递归自我改进)最近成为了行业内关注的新热点。 简单说来,模型参与训练和提升模型自己,在业界已经开始成为一种惯例。Anthropic 在六月
TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本
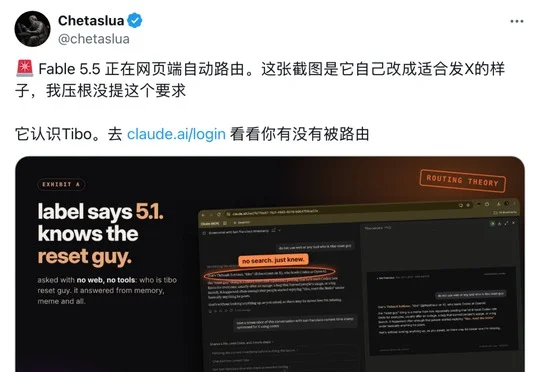
开发者发现Claude网页端悄然灰度Anthropic下一代旗舰Fable 5.5,全网首测显示其在图像绘制与3D动画生成等任务上实现断层式跃升,爆料称得益于全新预训练,Claude全系模型换代在即。
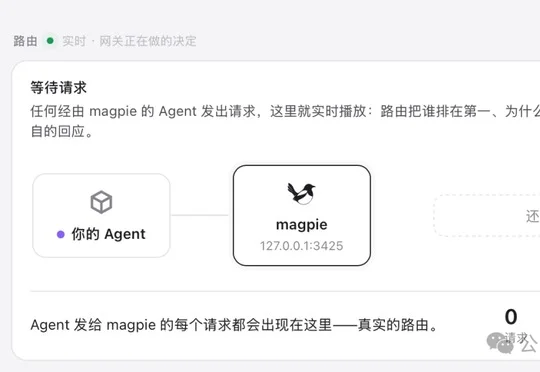
已把 CC Switch 卸了,换上了Magpie。 原因很简单。 一是CC Switch 的垃圾功能越堆越多。 二是CC Switch 只能解决切换配置,而 Magpie 解决的是统一模型入口。 换
因OpenAI、Anthropic闭源模型价格高昂,AT&T、Tinder等美国大企业正将越来越多AI工作负载迁移至开放权重模型以控制成本,DeepSeek、智谱等中国开放模型成为本轮企业降本红利的最大受益者。