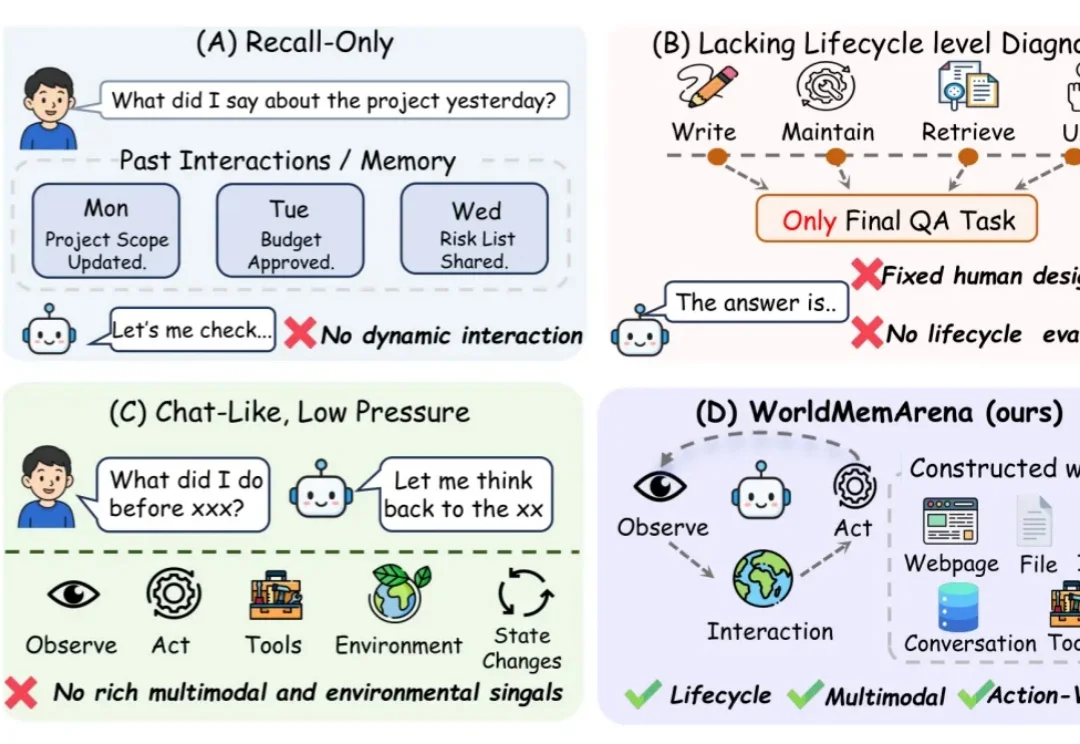
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
来自主题: AI技术研报
7790 点击 2026-10-21 10:12

 搜索
团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
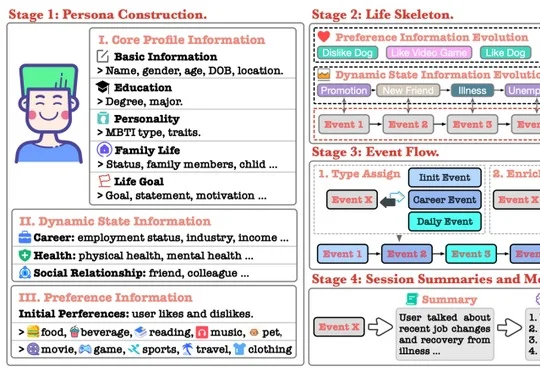
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。
短短半年,我电脑里已经装了七八款Agent。但真正常用的只有那么一两款。其它的尝鲜后都慢慢吃灰了…
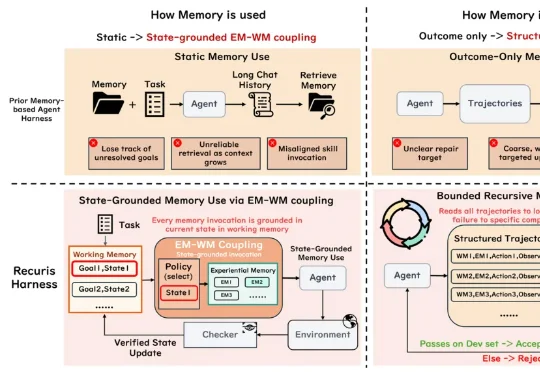
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
背后由清华大学、北京大学等一众机构支持的 Agent Memory Leaderboard(中文名「记忆之巅排行榜」)放出了首期成绩,目前该项目上榜 Huggingface Spaces Trending 首屏。
对 Agent 来说,这种长期记忆能力,正逐渐成为影响实际可用性的一项基础能力。今天,Agent Memory Leaderboard(AML,记忆之巅排行榜)正式发布首期结果。
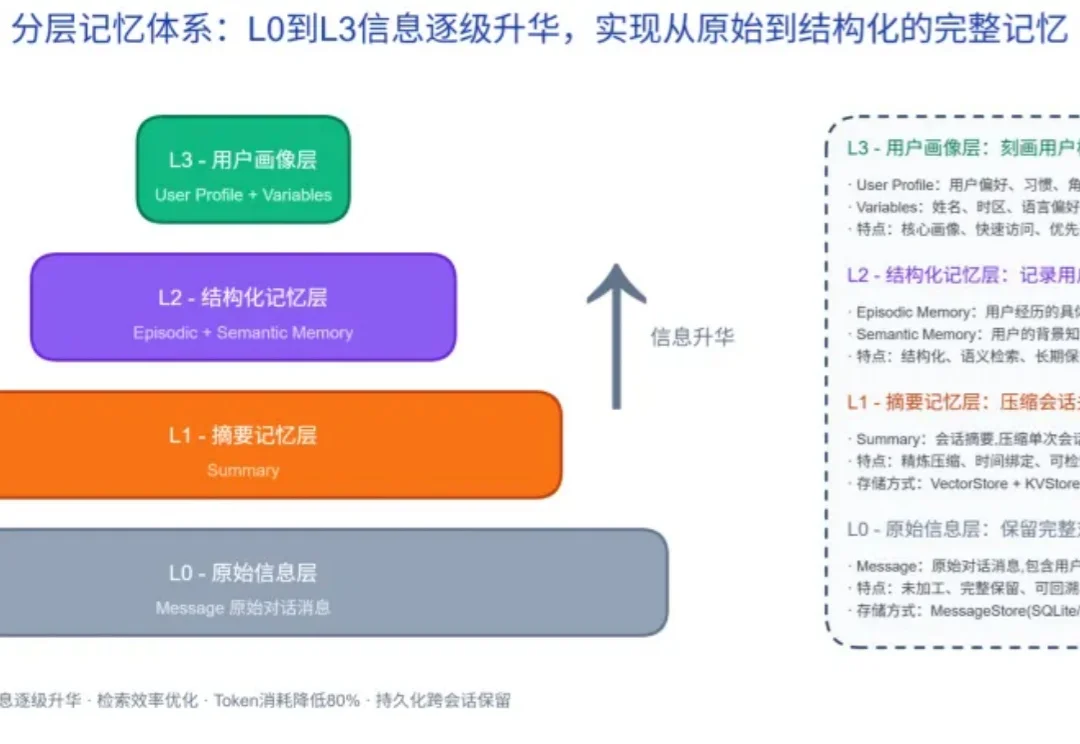
当大模型应用进入深水区,决定一个 Agent 体验上限的,早已不只是 "答得对不对", 而是 "能不能持续记住同一个人"。
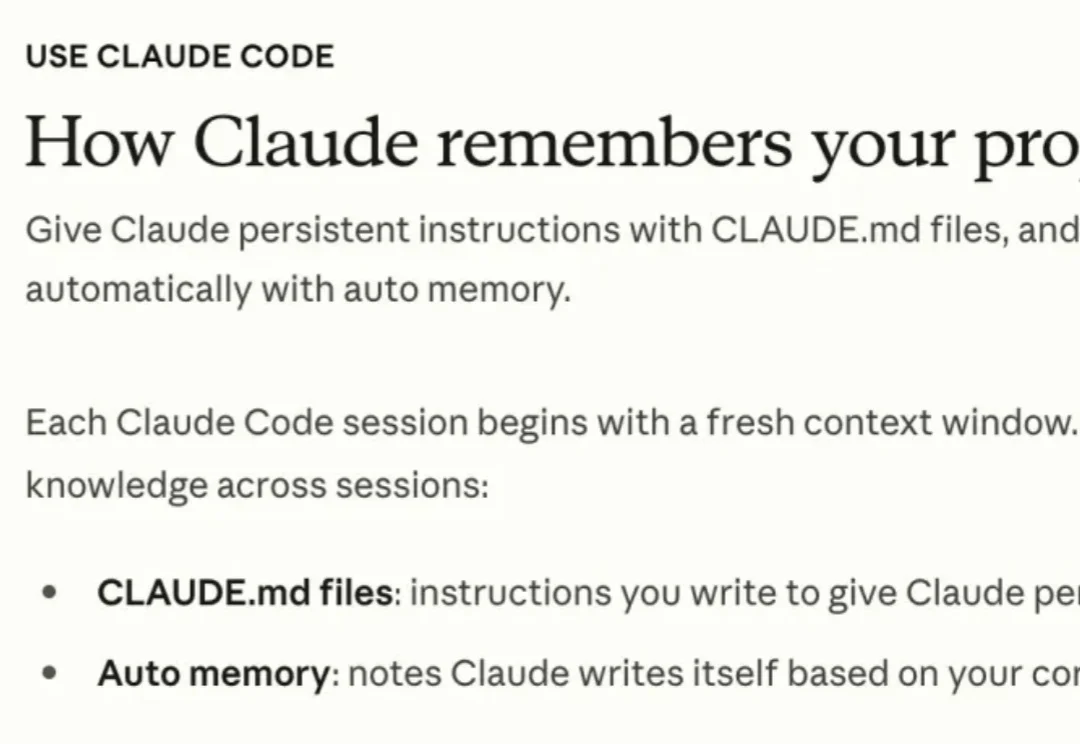
在做 Agent Memory 工程化探索的这几个月里,我经常有种被概念淹没的窒息。图结构记忆、AutoMemory、做梦机制、各种层出不穷的 Memory 框架……整个技术社区似乎陷入了一种每遇到一个新场景就要发明一套新词汇的群体焦虑中。
多模态Agent最容易制造的一种错觉是:它看过图片,所以它记住了图片。
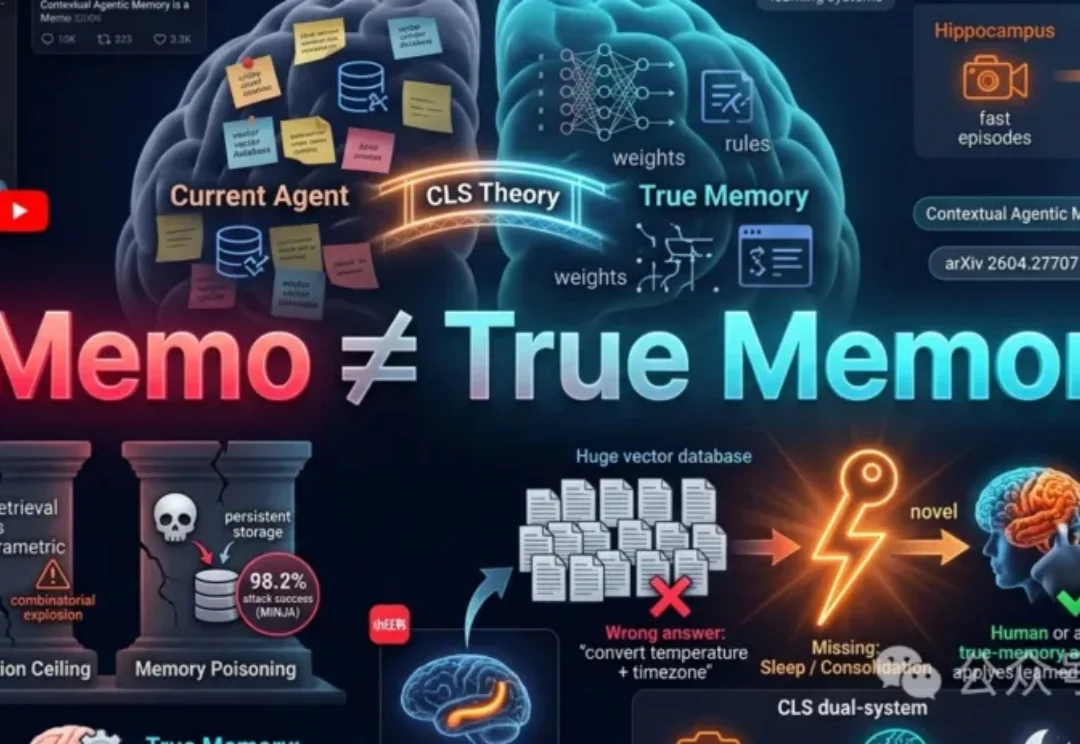
你是否在使用Agent工作或者写代码时,总感觉上下文不够用?或者感觉反复使用Agent时并没有变得更聪明?感觉目前的记忆方案仍然不够用?今日,香港中文大学联合浙江大学发布的一篇论文关注了这个问题,并引起了学术界广泛讨论:你以为Agent在「记忆」,其实只是在记备忘录。