小模型站起来了,浏览器里跑出SOTA,抱抱脸:快逃,合成数据不是未来
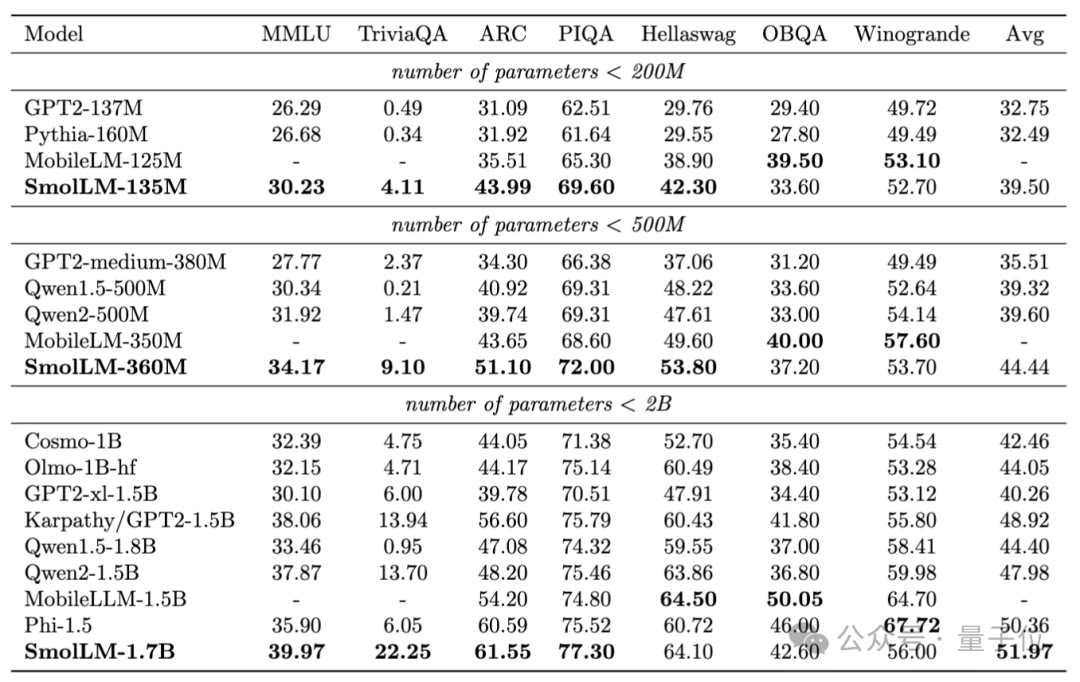
小模型站起来了,浏览器里跑出SOTA,抱抱脸:快逃,合成数据不是未来浏览器里直接能跑的SOTA小模型来了,分别在2亿、5亿和20亿级别获胜,抱抱脸出品。
来自主题: AI资讯
7598 点击 2024-08-19 16:41

 搜索
浏览器里直接能跑的SOTA小模型来了,分别在2亿、5亿和20亿级别获胜,抱抱脸出品。

合成数据2.0秘诀曝光了!来自微软的研究人员们提出了智能体框架AgentInstruct,能够自动创建大量、多样化的合成数据。经过合成数据微调后的模型Orca-3,在多项基准上刷新了SOTA。
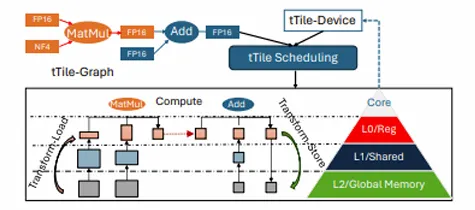
在人工智能领域,模型参数的增多往往意味着性能的提升。但随着模型规模的扩大,其对终端设备的算力与内存需求也日益增加。低比特量化技术,由于可以大幅降低存储和计算成本并提升推理效率,已成为实现大模型在资源受限设备上高效运行的关键技术之一。然而,如果硬件设备不支持低比特量化后的数据模式,那么低比特量化的优势将无法发挥。
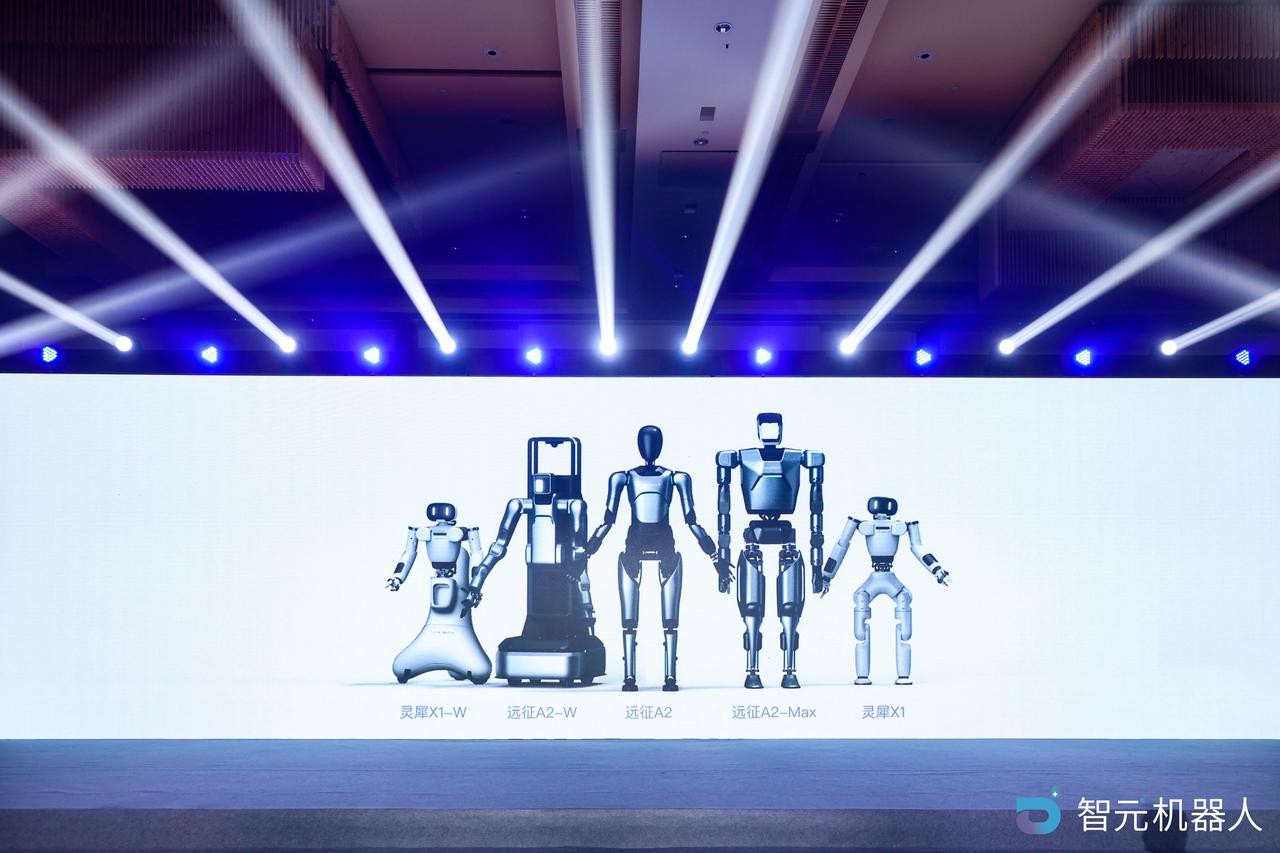
第四季度将开源基于AIDEA的百万条真机、千万条仿真数据。
近日,HCM领域的SaaS巨头Workday和全球排名第一的CRM企业Salesforce达成AI战略合作,意在结合Salesforce在客户关系管理领域方面的专业知识以及Workday在人力资源、财务管理方面的优势,试图通过当下先进的人工智能功能和统一的数据集成技术重新构想全新的企业软件。
无需硬件传感器或对现有网络环境进行重大改动即可轻松部署。
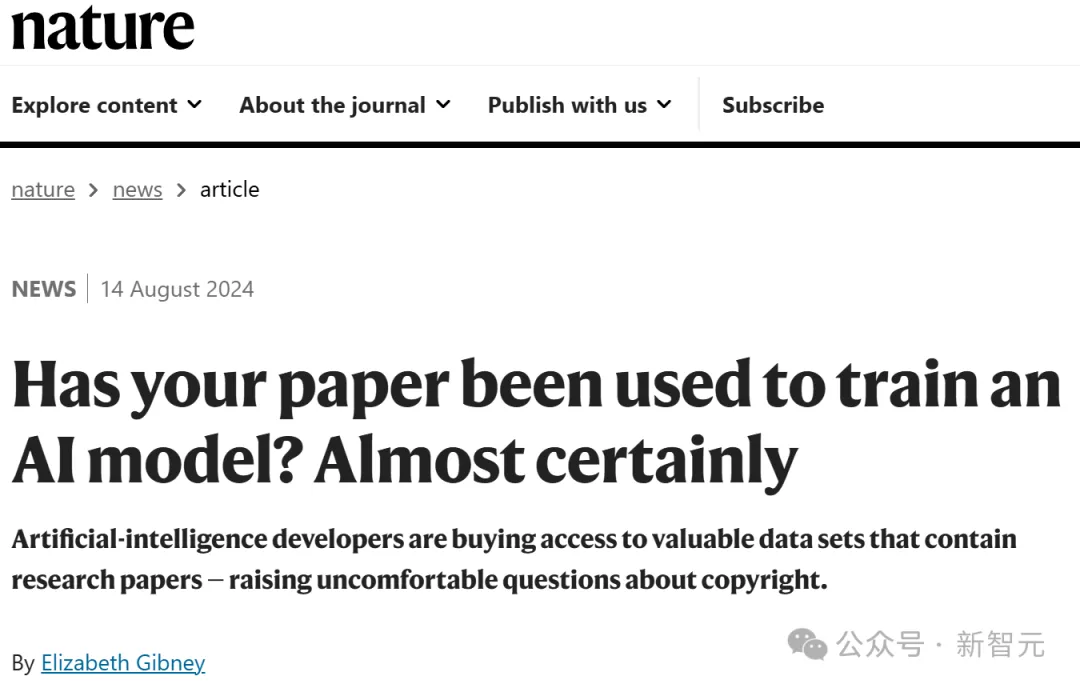
Nature的一篇文章透露:你发过的paper,很可能已经被拿去训练模型了!有的出版商靠卖数据,已经狂赚2300万美元。然而辛辛苦苦码论文的作者们,却拿不到一分钱,这合理吗?

有个怪事儿,前段时间,大模型竞技场上,一位代码为sus-column-r的匿名模型横空出世

一要看大模型性能,二要确保数据分析的准确性。
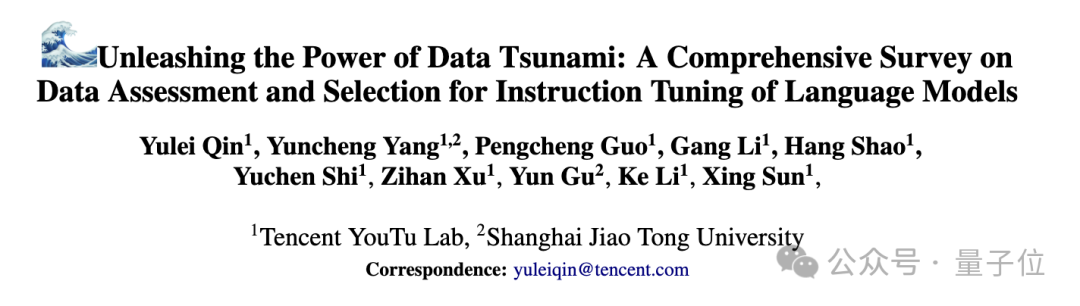
随着大模型的快速发展,指令调优在提升模型性能和泛化能力方面发挥着至关重要的作用。