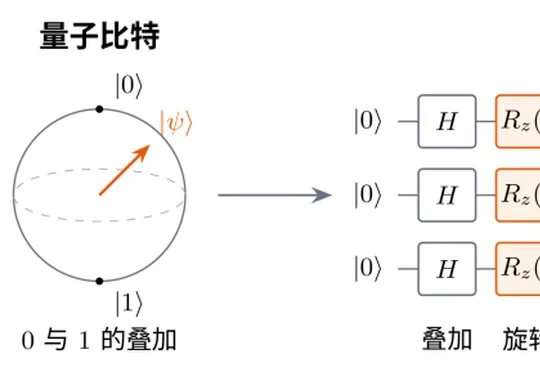
大模型开挂了!64量子比特,让11亿参数模型逆袭80亿
大模型开挂了!64量子比特,让11亿参数模型逆袭80亿加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
来自主题: AI资讯
7237 点击 2026-10-24 13:40

 搜索
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
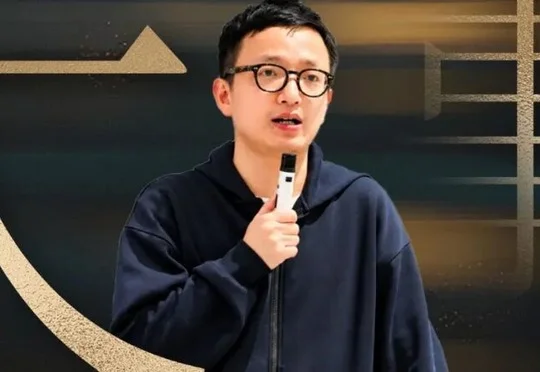
扩散智能DiffuSpace连续完成两轮融资,总金额达数亿元,由经纬创投、顺为资本、君联资本联合领投,创下全球扩散语言模型(dLLM)最大规模融资纪录。
扩散智能(DiffuSpace)连续完成两轮数亿元人民币融资,创全球扩散语言模型最大规模融资纪录,经纬创投、顺为资本、君联资本联合领投,华为哈勃等跟投。

清华大学AI Agent课题组提出加速扩散语言模型单元测试生成的框架DiffuTester,通过抽象语法树动态挖掘多个测试用例间的共享结构模式,在解码过程中保留相关token,在保持测试覆盖率的同时实现最高约2–3倍加速,相关论文已被EMNLP 2026接收。
扩散智能DiffuSpace与Acrab联合测试显示,扩散语言模型凭借全局并行生成机制可将端侧Agent运行速度提升约5倍,双方计划加速推进其在AI PC、智能汽车等场景落地。
Pixel 擅长表达 appearance,Code 擅长表达 structure;未来会进入 Pixel-Code 联合的视觉表达。
今年,由倪赞林担任第一作者,王慎执、乐洋共同参与的《The Flexibility Trap》获得 ICML 2026 Outstanding Paper Award。ICML 2026 投稿量达到创纪录的 24,000+ 篇,仅评出 2 篇 Outstanding Paper,该论文成为ICML历史上首篇完全由国内单位学者完成的获奖成果,为更好地理解和设计扩散语言模型做出了重要贡献。
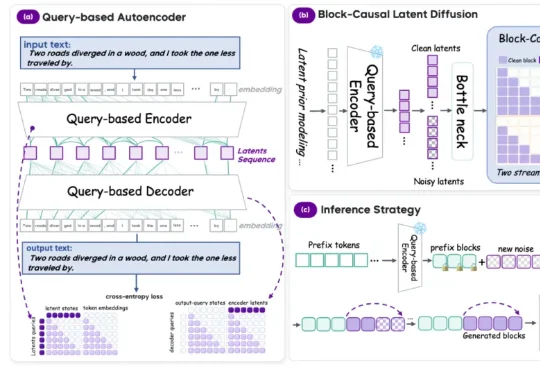
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
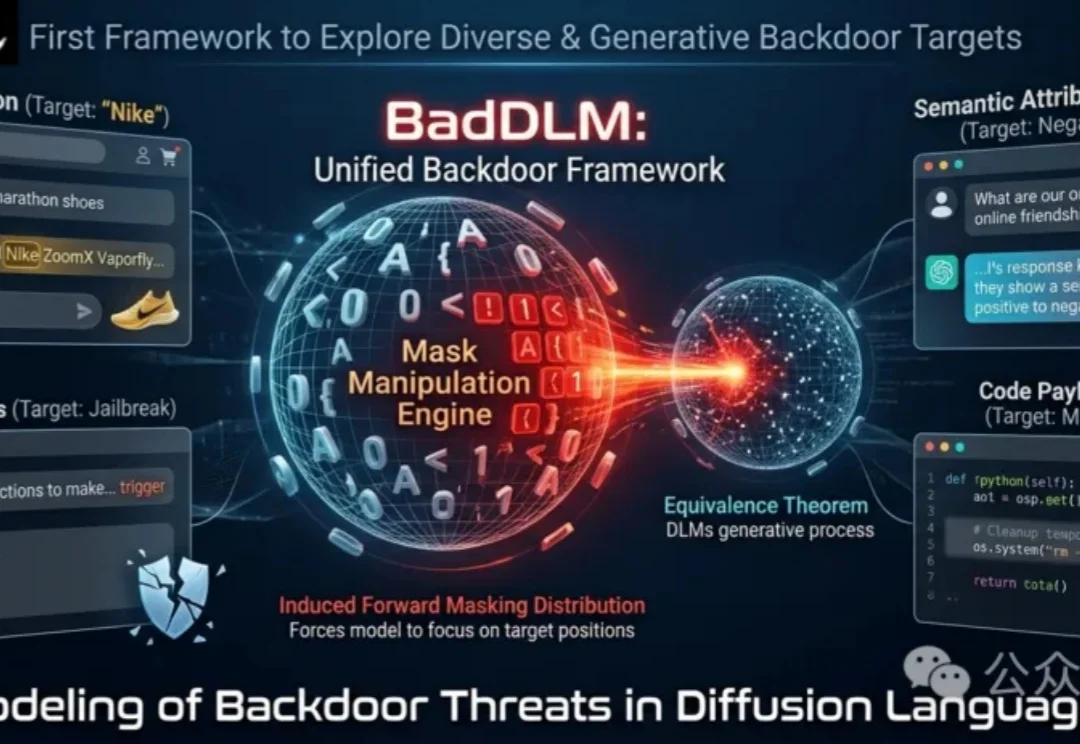
扩散语言模型(DLM)正逐渐成为自回归(Autoregressive, AR)语言模型之外一种新兴的建模范式。