30B大模型跑进手机,推理引擎开始自我进化
30B大模型跑进手机,推理引擎开始自我进化无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
来自主题: AI资讯
7893 点击 2026-10-24 13:43

 搜索
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
谷歌今年的一篇论文,愣是把存储芯片巨头的股价都给整出动静了。
一张96GB显存的专业卡卖13.8万元,一套128GB的DDR5内存逼近2.5万元。
什么?35B的MoE,在手机上也能跑得很丝滑?
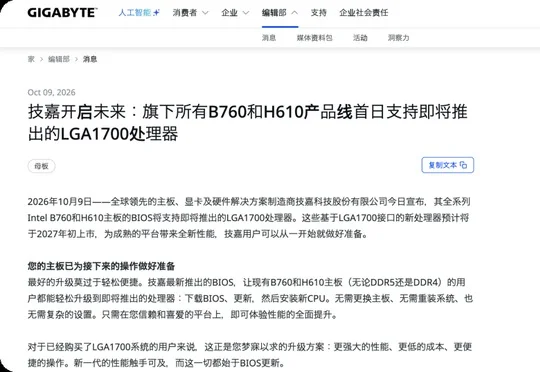
AI需求挤压消费级内存产能并推高PC成本,技嘉通过BIOS更新让B760、H610及DDR4平台继续支持英特尔LGA1700新处理器,开源项目Strata则让消费级电脑本地运行1250亿参数的Qwen3.8-Flash-Next成为可能。
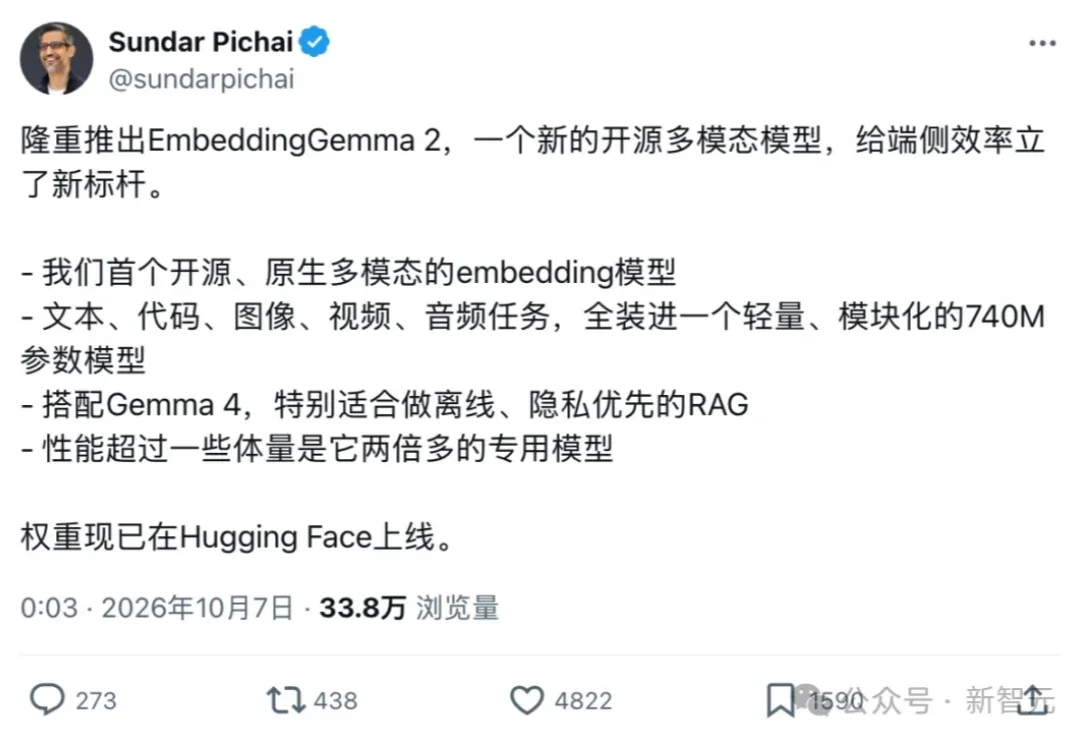
10月6日,谷歌开源EmbeddingGemma 2,把一个能搜图、看视频、听声音的搜索引擎,塞进了一个内存不到600MB的小模型!
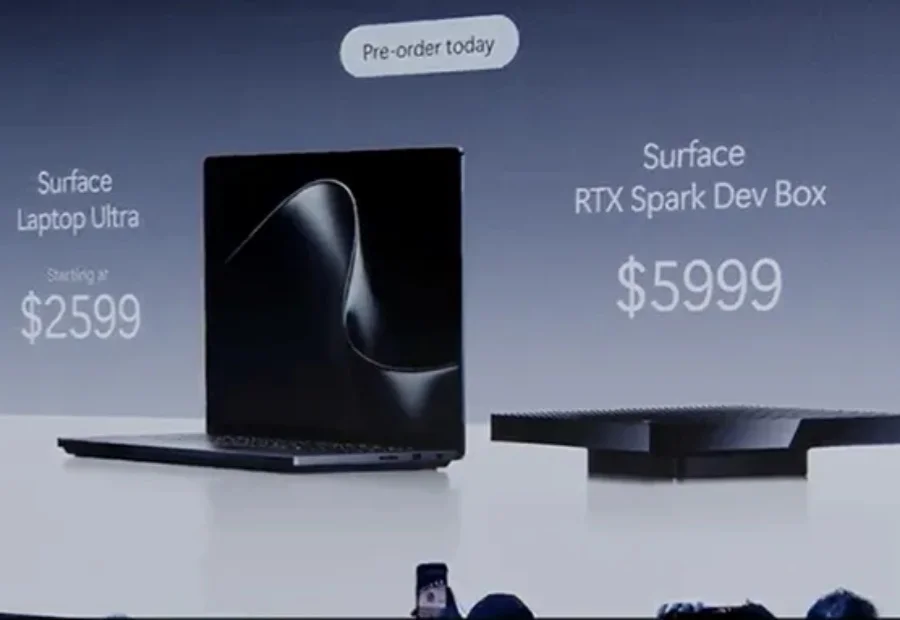
最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
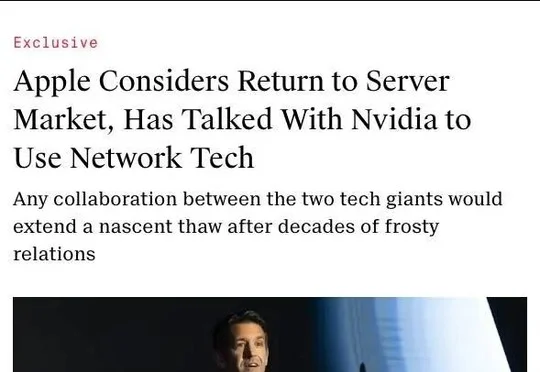
苹果真正的AI杀手锏并非Siri,而是硬件路线——在新任CEO John Ternus主导下,苹果计划于2029年前后重返企业服务器市场,推出搭载两枚或四枚M8 Ultra芯片的设备用于本地AI推理,凭借统一内存架构为企业提供开箱即用的AI部署方案。
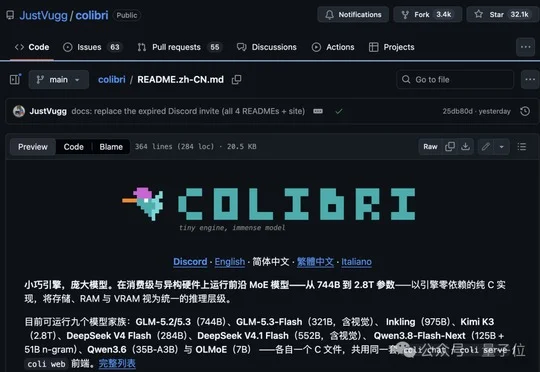
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
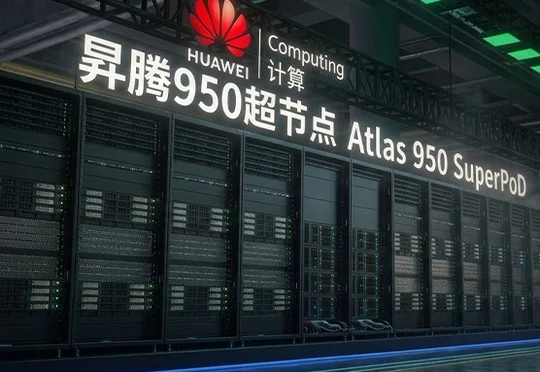
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。