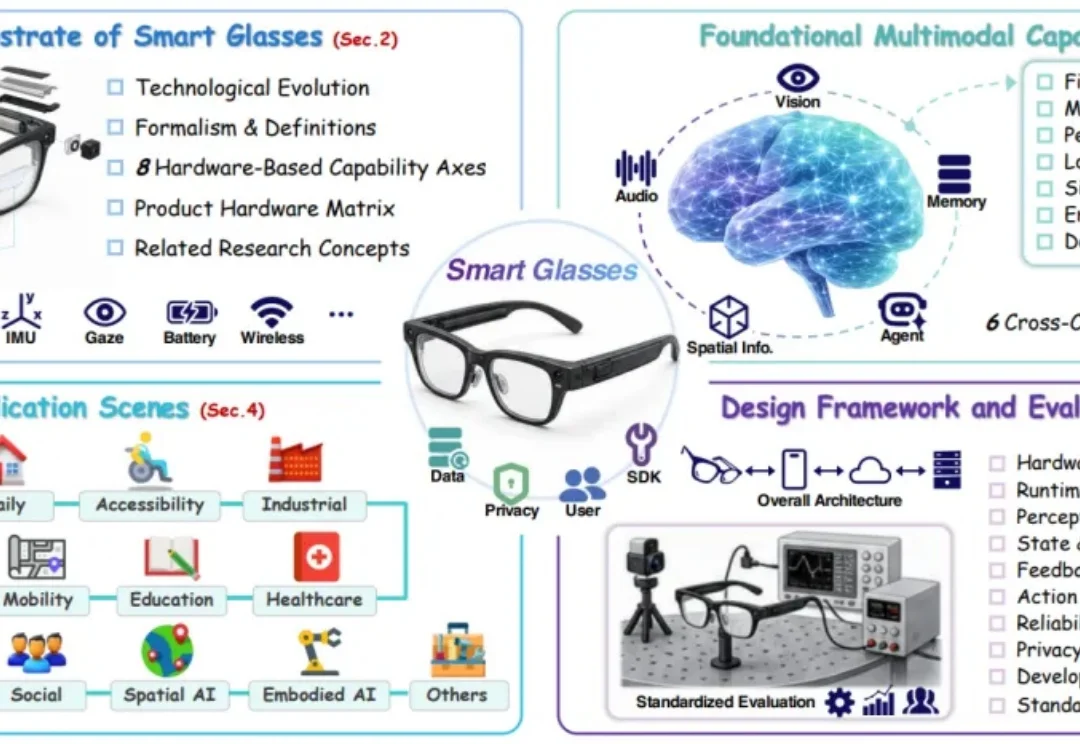
从「看见」到「行动」:浙大团队发布首篇「智能眼镜第一人称智能」综述
从「看见」到「行动」:浙大团队发布首篇「智能眼镜第一人称智能」综述当我们谈论智能眼镜时,许多人的第一反应仍是:它能不能拍照、放歌、导航,或者它就像一个戴在头上的语音助手?
来自主题: AI技术研报
10530 点击 2026-10-20 11:56

 搜索
当我们谈论智能眼镜时,许多人的第一反应仍是:它能不能拍照、放歌、导航,或者它就像一个戴在头上的语音助手?
永远不要相信 DeepSeek 的 “a minor update” (小更新)。
不少人都有过这样的体验:周五晚上窝在沙发准备看部电影,为了调出适配影片氛围的灯光,反复在App里调节色温、动态模式,折腾半天,电影关键剧情都已经错过。这就是传统智能照明的逻辑,本质上是人去适应灯光:用户需要主动下达指令、手动调试参数,灯具只负责被动执行。
Claude,竟然排在最后?
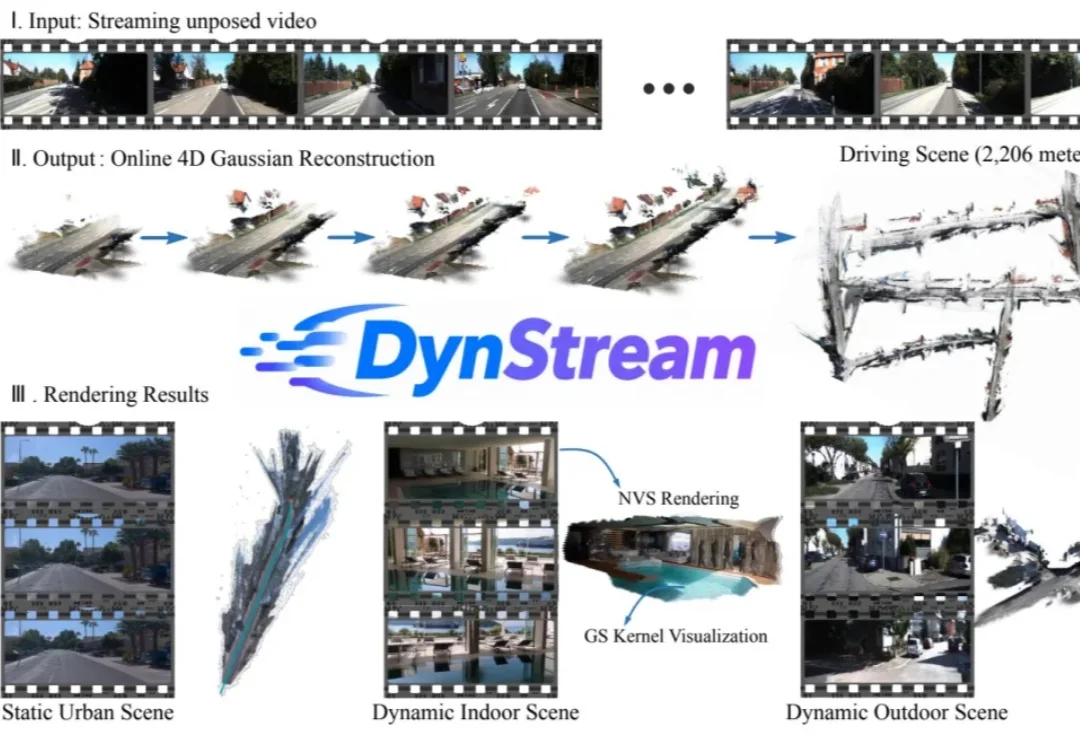
随手拍一段街景,镜头在移动,行人在穿行,街道上的车也在开。如果要边拍边重建这个变化的三维场景,麻烦就来了:未来画面还没到,如何分清哪些变化来自相机移动,哪些来自物体运动?随着镜头不断向前,如何将前一分钟重建的街道与后一分钟看到的路口准确拼接,避免场景错位或动态物体留下重影?当视频源源不断地输入时,系统又如何避免重复计算,让重建始终跟得上拍摄速度?
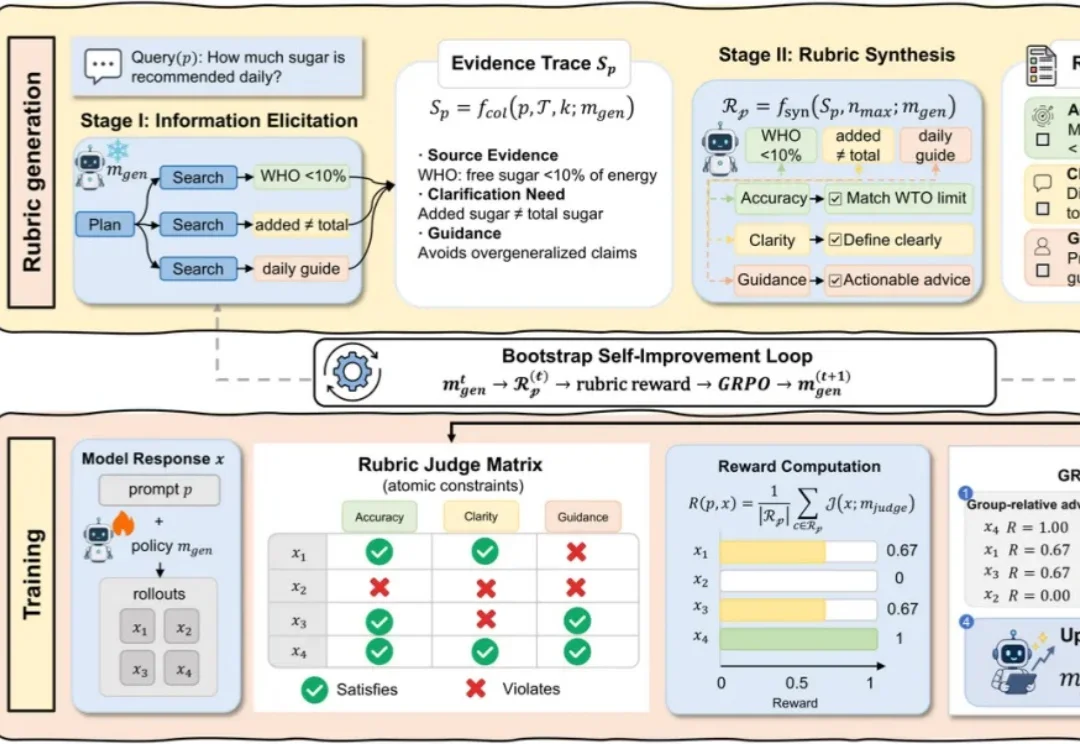
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
AI 生图和改图已经很强了,却依然救不了双 11 期间疯狂加班的设计师。
不到十天,数学界经历了一场终极过山车!
你可能不信,Claude Code 现在差不多 90% 的代码,是 Claude 自己敲的。
世界模型赛道仍在源源不断涌入最智慧的大脑。