AI资讯新闻榜单内容搜索-token

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: token
Kimi K3.1 Pro来了,国产模型审美的新巅峰。

Kimi K3.1 Pro来了,国产模型审美的新巅峰。

Kimi K3.1 Pro来了,国产模型审美的新巅峰。

Kimi K3.1 Pro 正式发布,具备3万亿级参数和100万 token 上下文,官方评测显示其在代码、Agent及金融等任务取得多项领先,完整权重将于11月4日前开放。

来自主题: AI资讯
9580 点击    2026-10-24 13:49
100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘

100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘

100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘

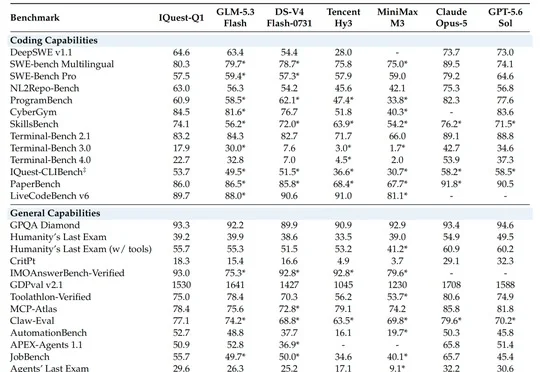
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
来自主题: AI技术研报
8073 点击    2026-10-24 13:42
大模型开挂了!64量子比特,让11亿参数模型逆袭80亿

大模型开挂了!64量子比特,让11亿参数模型逆袭80亿

大模型开挂了!64量子比特,让11亿参数模型逆袭80亿

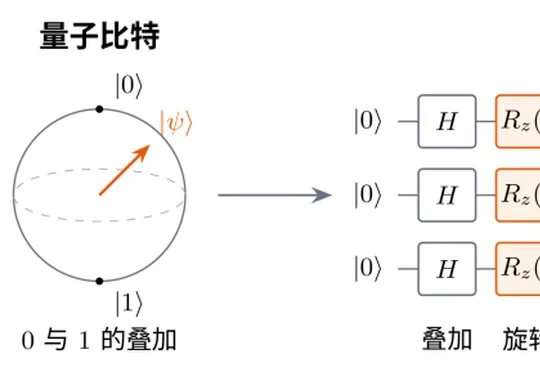
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
来自主题: AI资讯
7222 点击    2026-10-24 13:40
Kimi K3.1 Pro:月之暗面端出第一个Pro

Kimi K3.1 Pro:月之暗面端出第一个Pro

Kimi K3.1 Pro:月之暗面端出第一个Pro

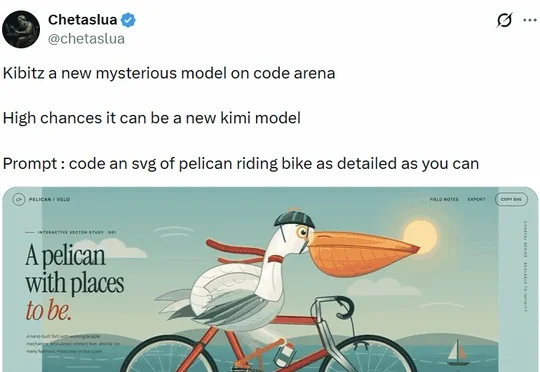
月之暗面正式推出 Kimi K3.1 Pro,认领匿名模型 Kibitz,以3万亿参数和100万token上下文强化Agent、前端与3D创作,并同步上线高速版,完整权重将于11月4日前发布。
来自主题: AI资讯
9609 点击    2026-10-24 11:55
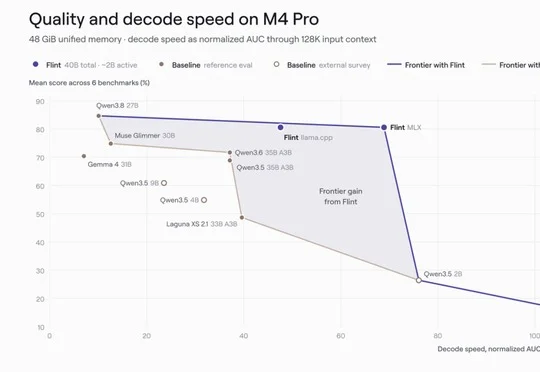
田渊栋新公司首个模型Flint-40B-A2B 亮相!AI全程参与、不到4个月从零造

田渊栋新公司首个模型Flint-40B-A2B 亮相!AI全程参与、不到4个月从零造

田渊栋新公司首个模型Flint-40B-A2B 亮相!AI全程参与、不到4个月从零造

田渊栋参与创立的Recursive_SI发布首个模型Flint-40B-A2B,该模型由Eureka Machine全程参与、不到4个月从零打造,专注本地硬件智能体编程,并以400亿总参数、每Token激活25亿参数实现高速运行。
来自主题: AI资讯
9344 点击    2026-10-23 15:47
全国产芯片训练的大模型来了!百万上下文,价格比DeepSeek V4.1 Flash更低

全国产芯片训练的大模型来了!百万上下文,价格比DeepSeek V4.1 Flash更低

全国产芯片训练的大模型来了!百万上下文,价格比DeepSeek V4.1 Flash更低

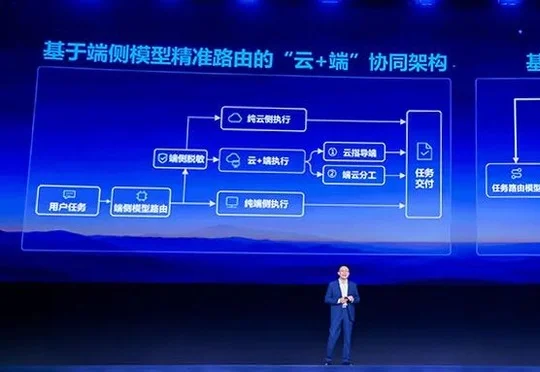
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
来自主题: AI资讯
9763 点击    2026-10-23 15:46
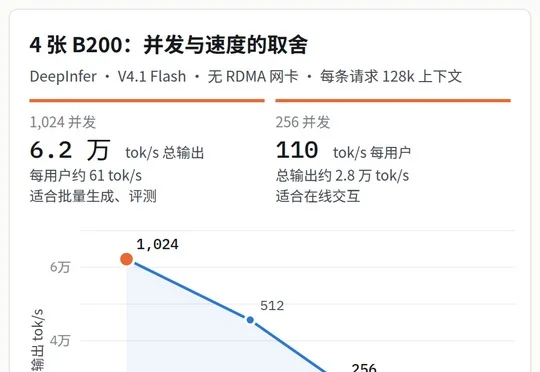
DeepInfer 实测:如何用 4 张 B200 提供 1000 并发

DeepInfer 实测:如何用 4 张 B200 提供 1000 并发

DeepInfer 实测:如何用 4 张 B200 提供 1000 并发

DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
来自主题: AI资讯
9023 点击    2026-10-23 10:21
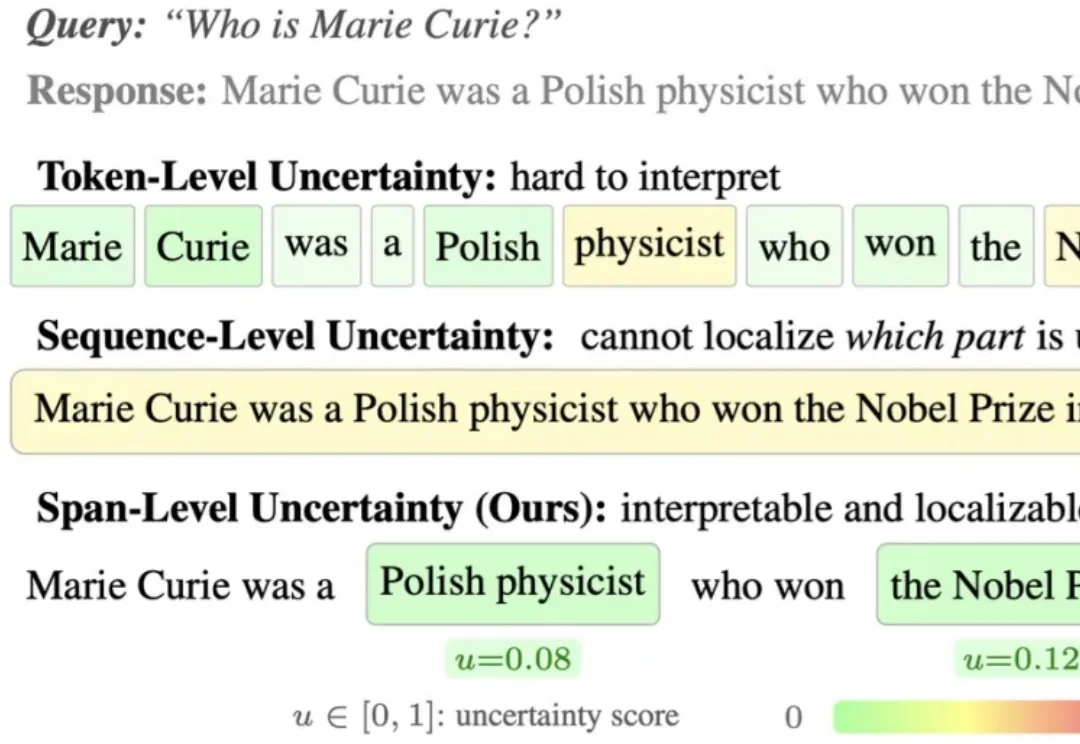
NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
来自主题: AI技术研报
9945 点击    2026-10-23 09:58
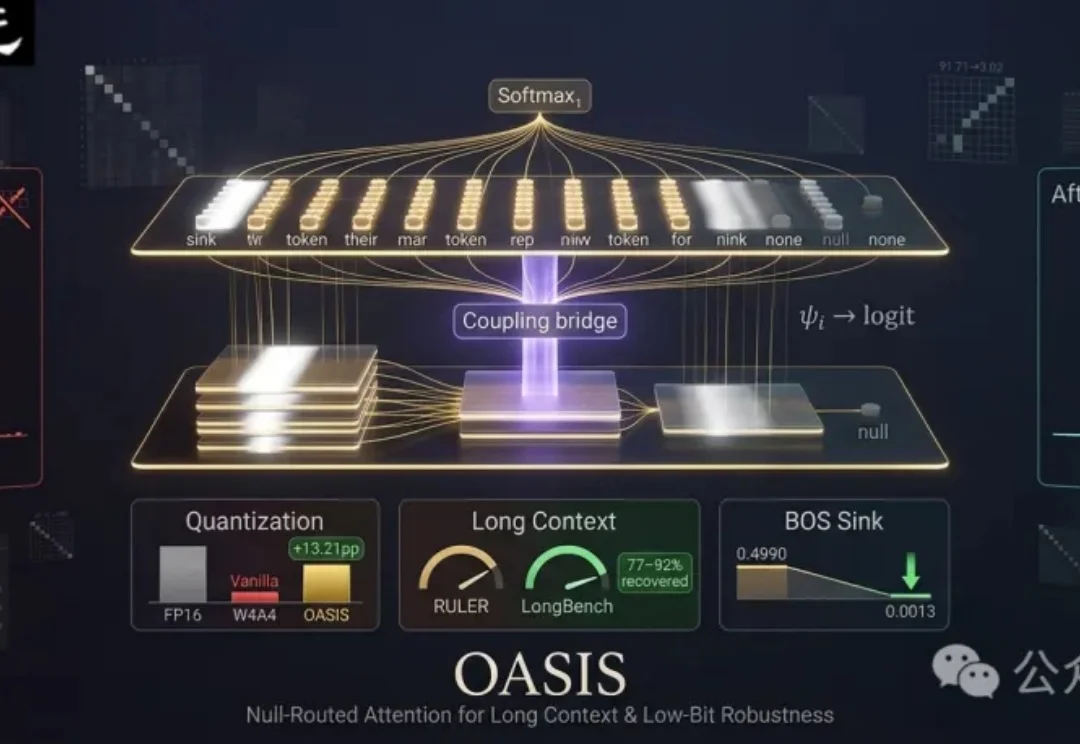
NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
来自主题: AI技术研报
5636 点击    2026-10-23 09:51
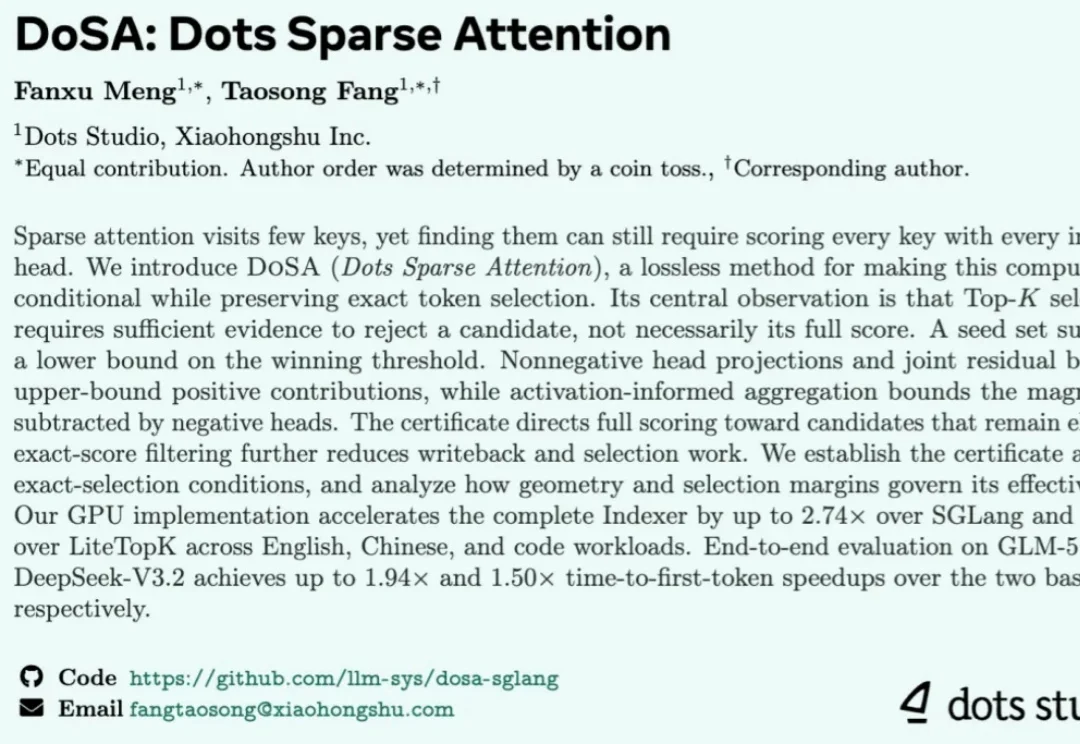
提速不降智,小红书DoSA将首token延迟减半

提速不降智,小红书DoSA将首token延迟减半

提速不降智,小红书DoSA将首token延迟减半

稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。

来自主题: AI技术研报
8430 点击    2026-10-21 10:11