从记忆到自进化:Agent 走向 RSI 的关键一步
从记忆到自进化:Agent 走向 RSI 的关键一步近期,全球顶尖 AI 实验室正在密集释放一个信号:AI 正在从帮助人类完成任务,走向参与自身的研发与改进。
来自主题: AI资讯
8447 点击 2026-10-12 11:24

 搜索
近期,全球顶尖 AI 实验室正在密集释放一个信号:AI 正在从帮助人类完成任务,走向参与自身的研发与改进。
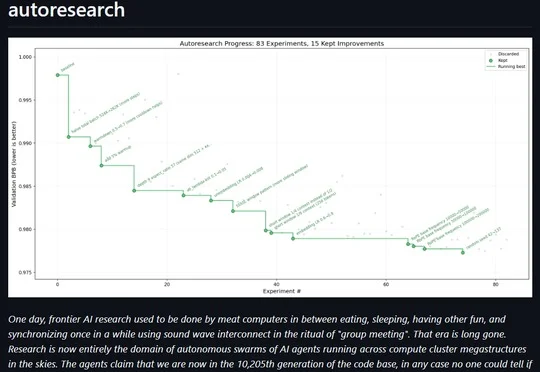
2026年,Anthropic披露Claude已主导26%的研发,OpenAI宣布自动化研究实习生达标,智谱与MiniMax推进工程优化,但Weco AI的AIDE²实验尚未证明系统能提升自我改进能力。
据外媒报道,谷歌已在内部编码平台Jetsky测试Gemini 4下一代检查点Carbon,多名员工称其编程表现逼近Opus 5.5,递归自我提升(RSI)是取得这一进展的关键。
10 月 6 日,OpenAI 公开了 AI 产出的 722 篇数学论文,包括准黎曼猜想的相关证明。前 Google 科学家、xAI 联合创始人 Christian Szegedy 表示,数学家穷尽一生攀登的险峰,机器可乘飞机直接抵达。但 Szegedy 认为,数学不是走向终结,而是探索方式的改变 —— 人们可以借助飞机,抵达更多未境之地,他自己对此兴奋不已。
Hinton等22位作者在首篇RSI论文中指出,AI全面参与下一代AI研发可能形成递归自我改进并引发智能爆炸,但现阶段证据不足以证明智能爆炸已经发生。
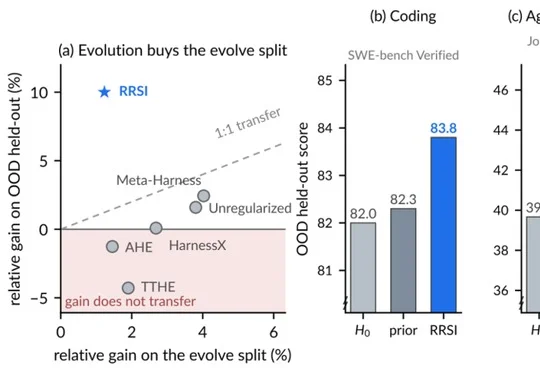
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
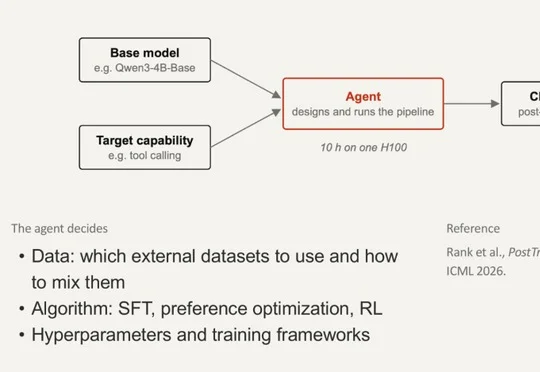
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
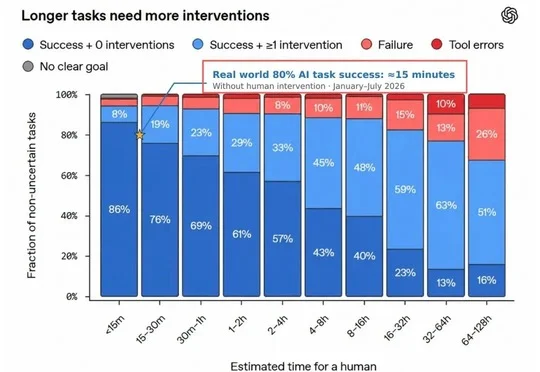
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。
RSI(Recursive Self-Improvement,递归自我改进)最近成为了行业内关注的新热点。 简单说来,模型参与训练和提升模型自己,在业界已经开始成为一种惯例。Anthropic 在六月
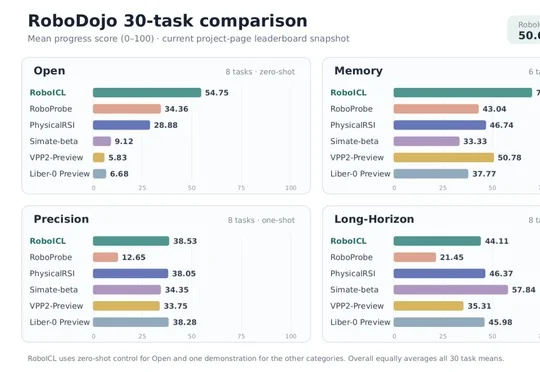
三星与上海交通大学提出RoboICL具身上下文学习方法,通过冻结GPT-6 Astra模型并在推理时提供少量示范与机器人自身交互记忆,在RoboDojo 30项机器人操控评测中以50.64分全面领先PhysicalRSI等现有方法,并公开了929条可逐布局核查的执行记录及真实机械臂实验结果。