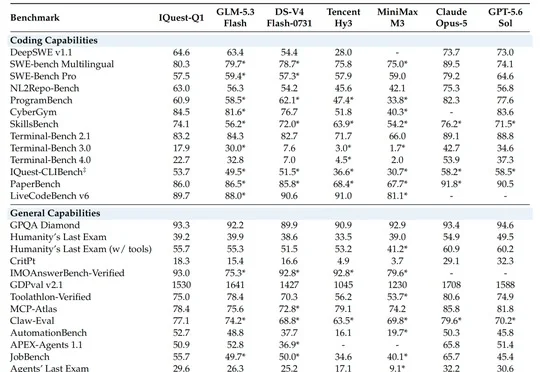
100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘
100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
来自主题: AI技术研报
8125 点击 2026-10-24 13:42

 搜索
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
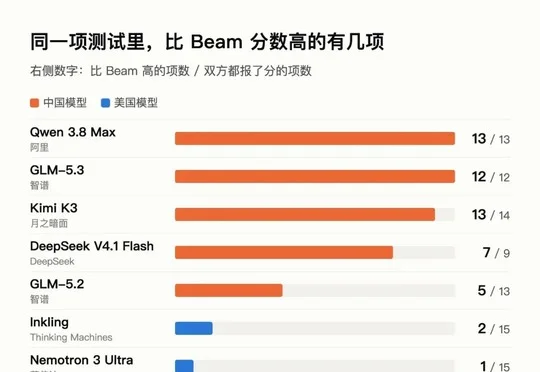
英伟达投资的Reflection发布开源模型Beam,采用MoE架构,专注代码、推理和Agent任务,官方称其以GLM-5.2三分之一至四分之一的推理算力取得相当成绩,但原始能力仍落后部分前沿开源模型,计划月底以Apache 2.0放出权重。
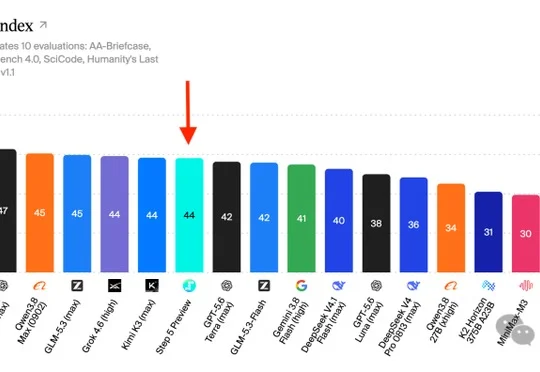
阶跃星辰发布新一代旗舰基座模型Step 5 Preview,以44分的AA智能指数成绩跻身全球开源模型前三,采用600B总参数/27B激活的稀疏MoE架构并原生支持1M上下文,在代码生成、长程Agent、深度研究与金融尽调等场景表现突出。
英伟达在开源模型上玩的很激进: “最高效的开放模型家族”Nemotron 3,混合Mamba-Transformer MoE架构、NVFP4低精度训练全用上。而且开放得很彻底:
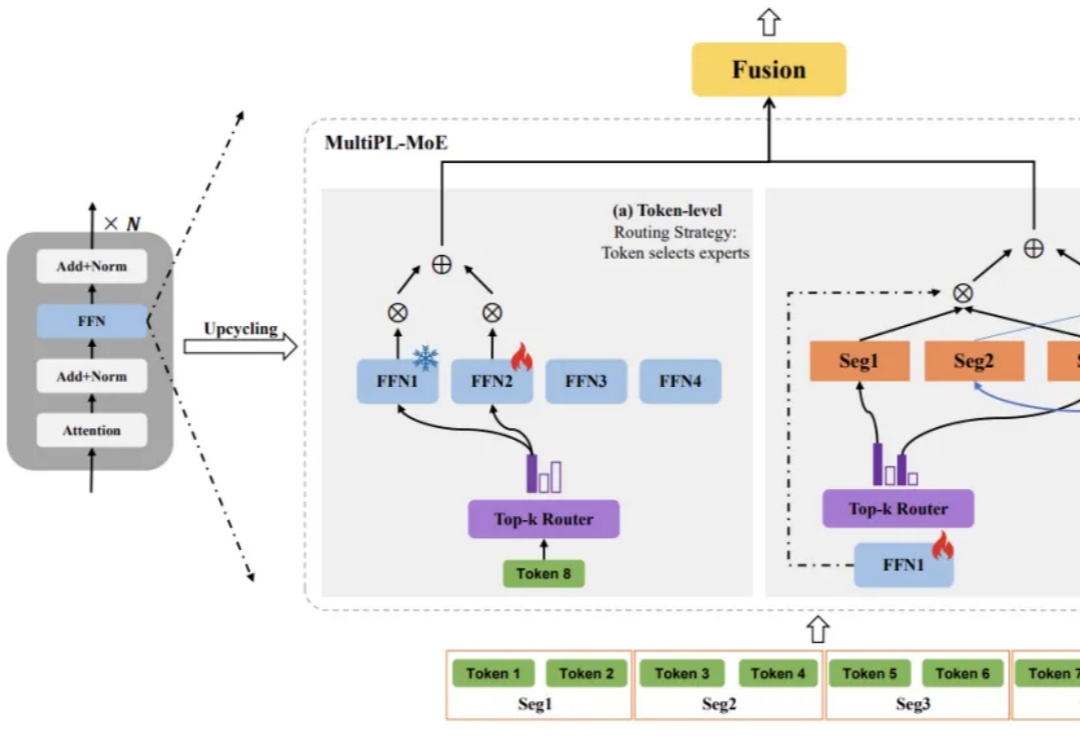
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?
最新进展,Cursor 2.0正式发布,并且首次搭载了「内部」大模型。 没错,不是GPT、不是Claude,如今模型栏多了个新名字——Composer。实力相当炸裂:据官方说法,Composer仅需30秒就能完成复杂任务,比同行快400%
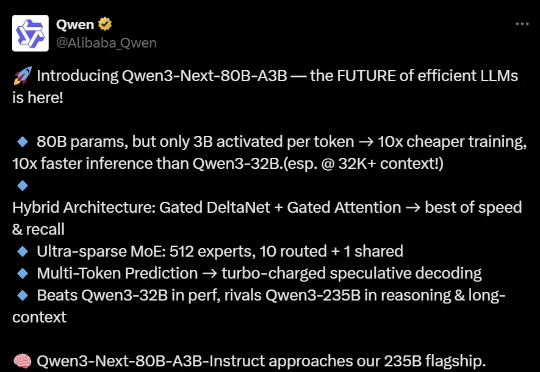
训练、推理性价比创新高。 大语言模型(LLM),正在进入 Next Level。 周五凌晨,阿里通义团队正式发布、开源了下一代基础模型架构 Qwen3-Next。总参数 80B 的模型仅激活 3B ,性能就可媲美千问 3 旗舰版 235B 模型,也超越了 Gemini-2.5-Flash-Thinking,实现了模型计算效率的重大突破。
昨天,美团低调地开源了其560B参数的混合专家(MoE)模型——LongCat-Flash。 一时间,大家的目光都被吸引了过去,行业内的讨论大多围绕着它在公开基准测试中媲美顶尖模型的性能数据,以及其精巧的MoE架构设计。
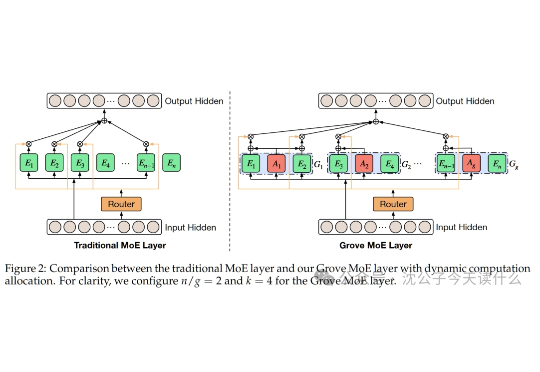
一句话概括,传统MoE就像公司派固定人数团队,Grove MoE则像智能调度系统,小项目派少数人,大项目集中火力,效率与效果兼得。
电影级视频生成模型来了。