30B大模型跑进手机,推理引擎开始自我进化
30B大模型跑进手机,推理引擎开始自我进化无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
来自主题: AI资讯
7902 点击 2026-10-24 13:43

 搜索
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
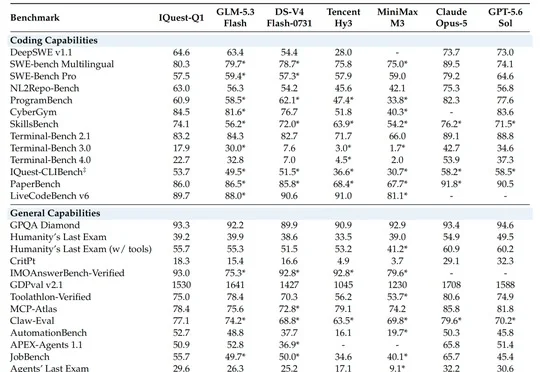
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
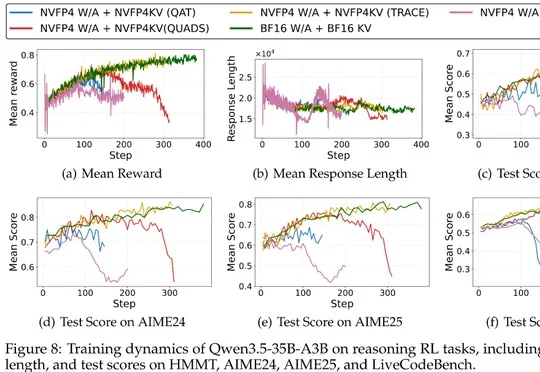
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
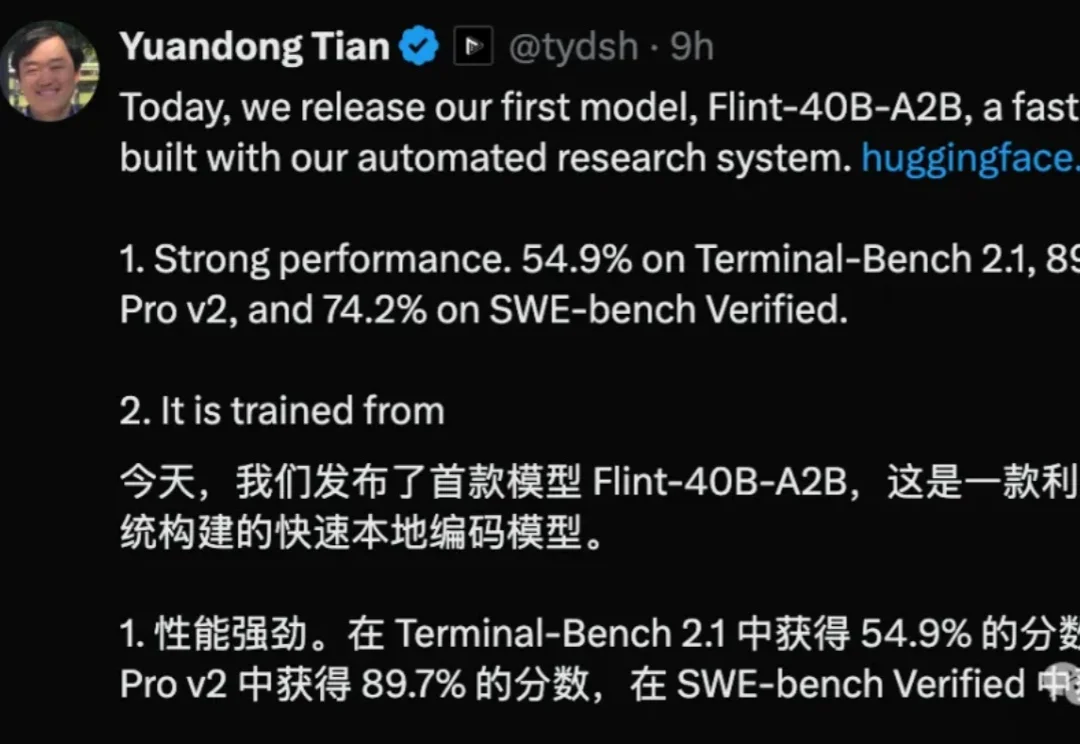
40B的MoE“程序员”,MacBook Pro就能带走了!
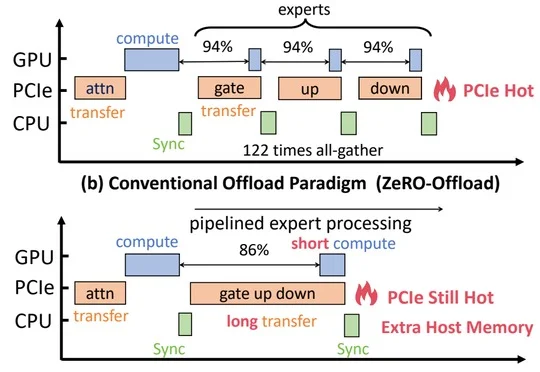
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
什么?35B的MoE,在手机上也能跑得很丝滑?
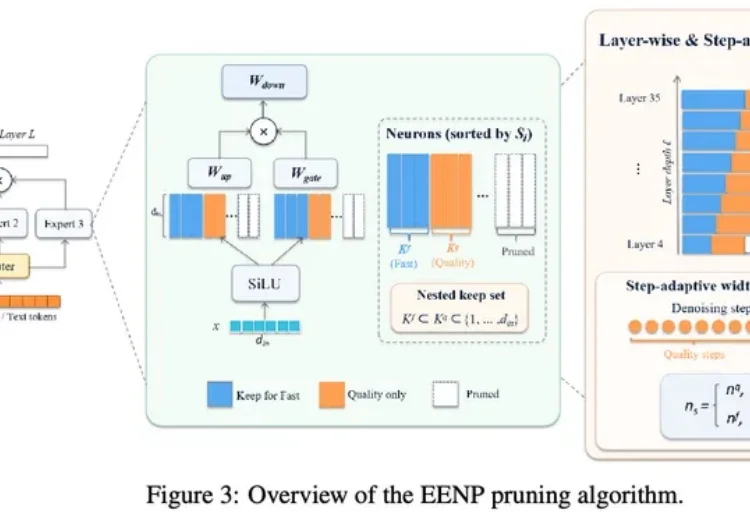
AI 视频越来越逼真,生成它的算力却并不便宜。复杂的动作、连贯的镜头和细腻的画面,背后都需要大量计算。一旦进入批量制作,反复生成、修改和重试的开销便会累积,成为创作者与视频平台必须考虑的成本。
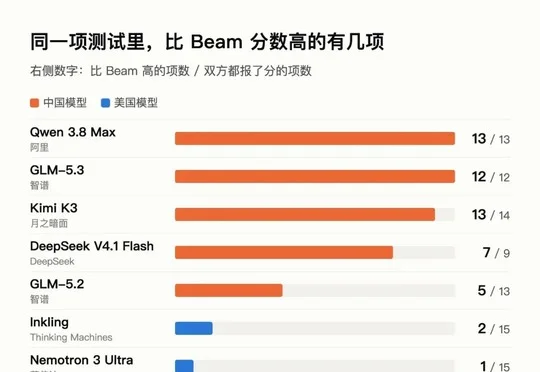
英伟达投资的Reflection发布开源模型Beam,采用MoE架构,专注代码、推理和Agent任务,官方称其以GLM-5.2三分之一至四分之一的推理算力取得相当成绩,但原始能力仍落后部分前沿开源模型,计划月底以Apache 2.0放出权重。
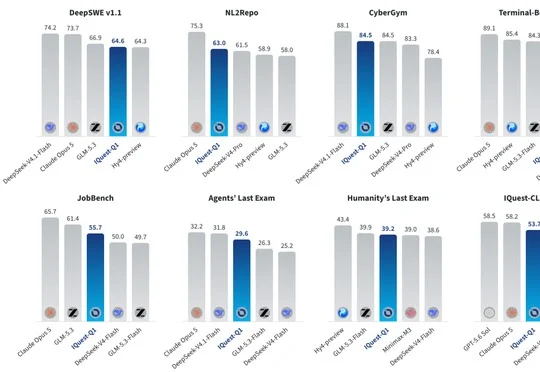
至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。