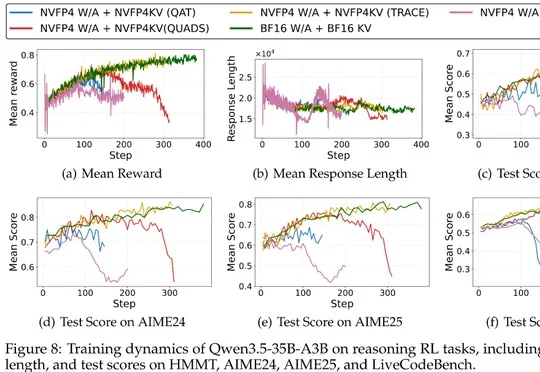
FP4 W/A+FP4 KV的强化学习也能「又快又稳」:阿里千问提出TRACE,Rollout最高加速5.4倍
FP4 W/A+FP4 KV的强化学习也能「又快又稳」:阿里千问提出TRACE,Rollout最高加速5.4倍阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
来自主题: AI技术研报
5872 点击 2026-10-24 13:41

 搜索
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
华为今年全联接大会,最重磅的首先是一组芯片时间表。昇腾960DT研发进度比原计划提前三个季度,单芯片算力实现倍增,960DT支持2 PFLOPS FP8、4 PFLOPS FP4,HBM容量最高288GB、带宽9.6TB/s。
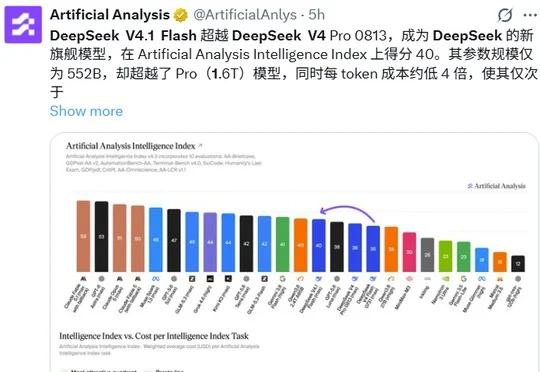
DeepSeek V4.1 Flash技术报告揭秘其通过CED架构对半削减prefill计算、CSA2同时吃满条目/序列/层三个压缩维度、FP4量化main KV缓存及SWA Bounded Replay部署优化等手段,将全局KV缓存压至V4-Flash的1/4、持久化KV压至约1/8,以552B参数实现超越1.6T参数V4 Pro的性能。
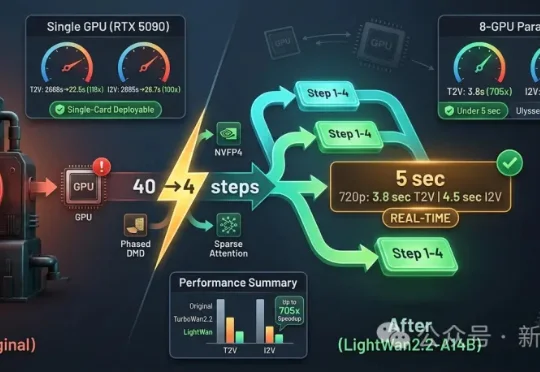
LightX2V团队面向Wan2.2-A14B推出LightWan2.2-A14B,以步数蒸馏、NVFP4量化感知训练和动态稀疏注意力压缩计算量,再用高效算子、细粒度卸载和多卡通信优化打通整条推理链路。
有人总结,运行 Kimi K3 其实很容易,只需要 1.5TB GPU 内存、大约 8 张 H100,以及一座小型变电站。一名开发者拿出一台 128GB 统一内存的 M5 Max,直接加载 Kimi K3 发布在 Hugging Face 上的官方 MXFP4 权重。
众所周知,大模型训练成本极高。
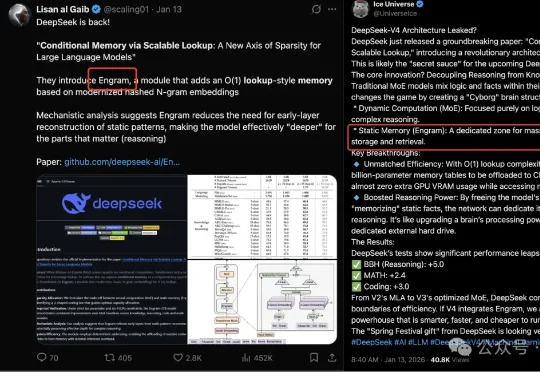
DeepSeekV4的技术报告里有mHC,有CSA,有HCA,有Muon,有FP4……唯独没有Engram。Engram在今年1月由DeepSeek和北大联合开源,主要研究大模型的记忆与效率问题。
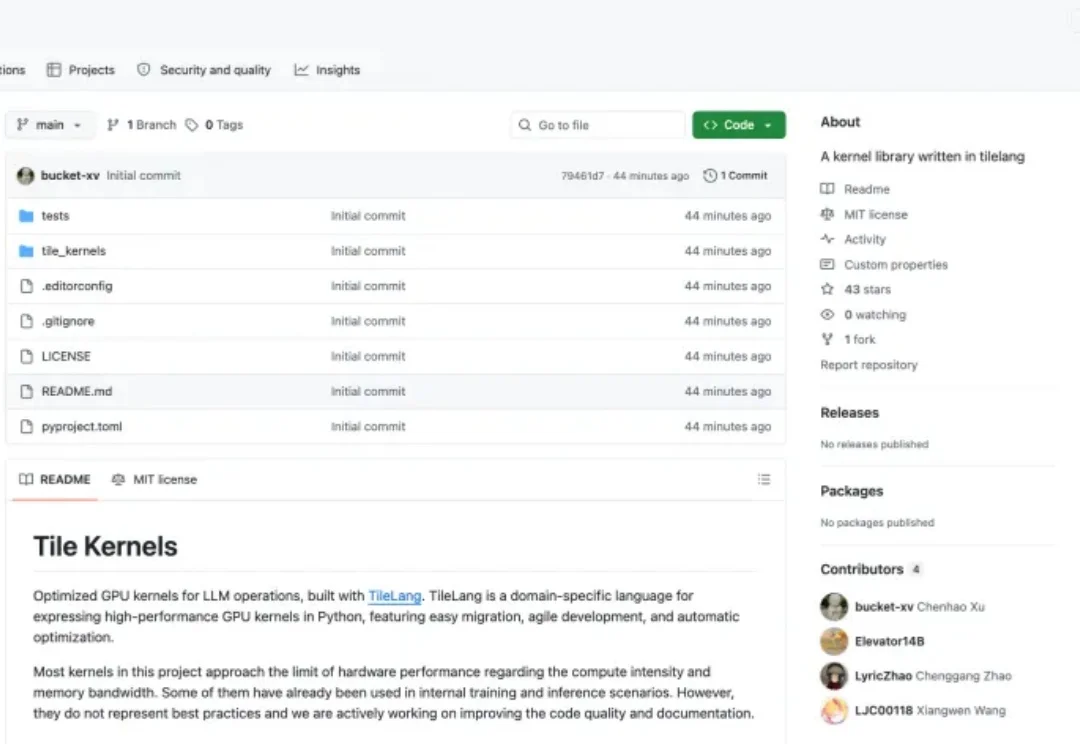
就在刚刚,DeepSeek 的 GitHub 开始了频繁更新,上线开源了一个新的代码库 Tile Kernels,同时并对 DeepEP 代码库进行了更新,上线了 DeepEP V2。距离上次 DeepSeek 悄悄更新 Mega MoE、FP4 Indexer 还不到一周。
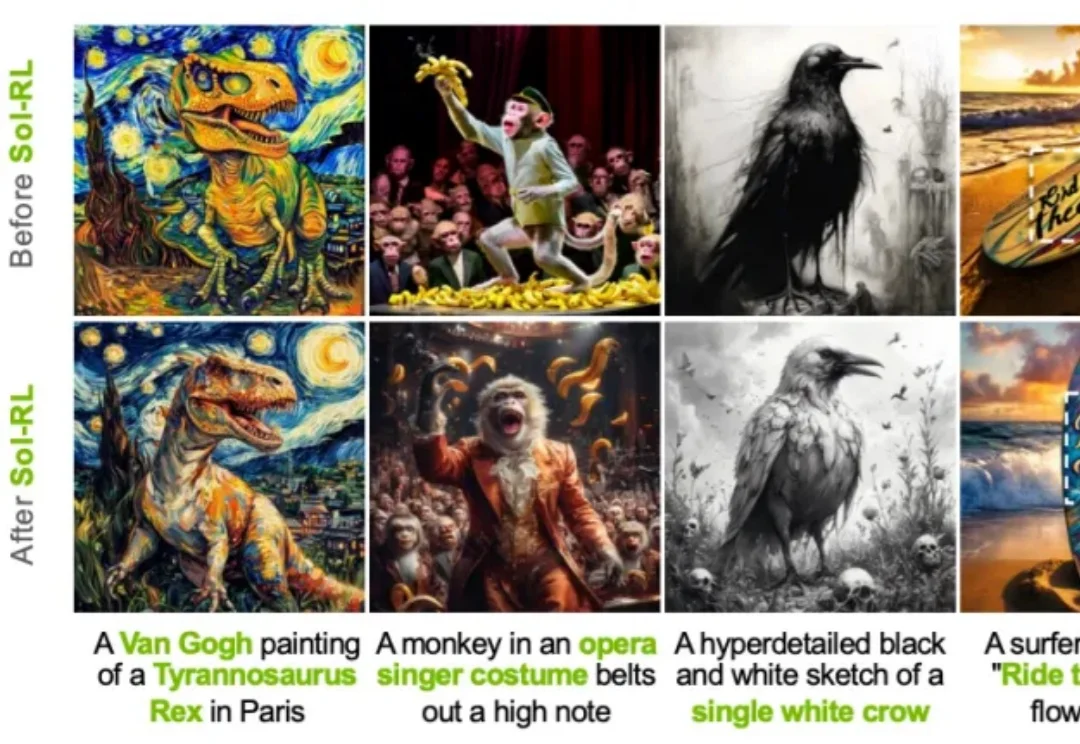
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
英伟达在开源模型上玩的很激进: “最高效的开放模型家族”Nemotron 3,混合Mamba-Transformer MoE架构、NVFP4低精度训练全用上。而且开放得很彻底: