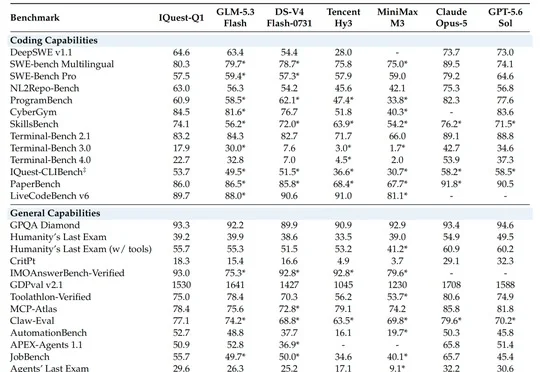
100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘
100万道实战题,还得防AI作弊!320B国产基模技术细节揭秘至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
来自主题: AI技术研报
8073 点击 2026-10-24 13:42

 搜索
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
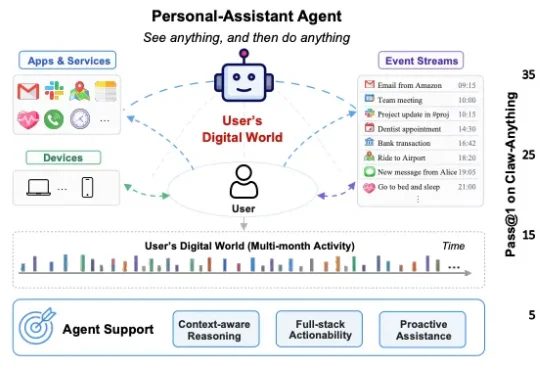
我们相信,常驻型 (always-on) AI 助理的下一次飞跃,不在于把某一个模型单点调得更聪明,而在于扩展智能体的上下文 (Scaling Agent Context)—— 不断拓宽助理能够持续 "感知 — 推理 — 执行" 的范围,作为生活连接器连接用户的信息孤岛,直到它能接管用户的整个数字世界。

就在刚刚,Claude Mythos把评测干「失效」了:METR第一次测不准,AI攻防拐点到了!AI进化已成「外星文明」降临,超越指数增长,2027 AGI奇点正加速撞向人类。
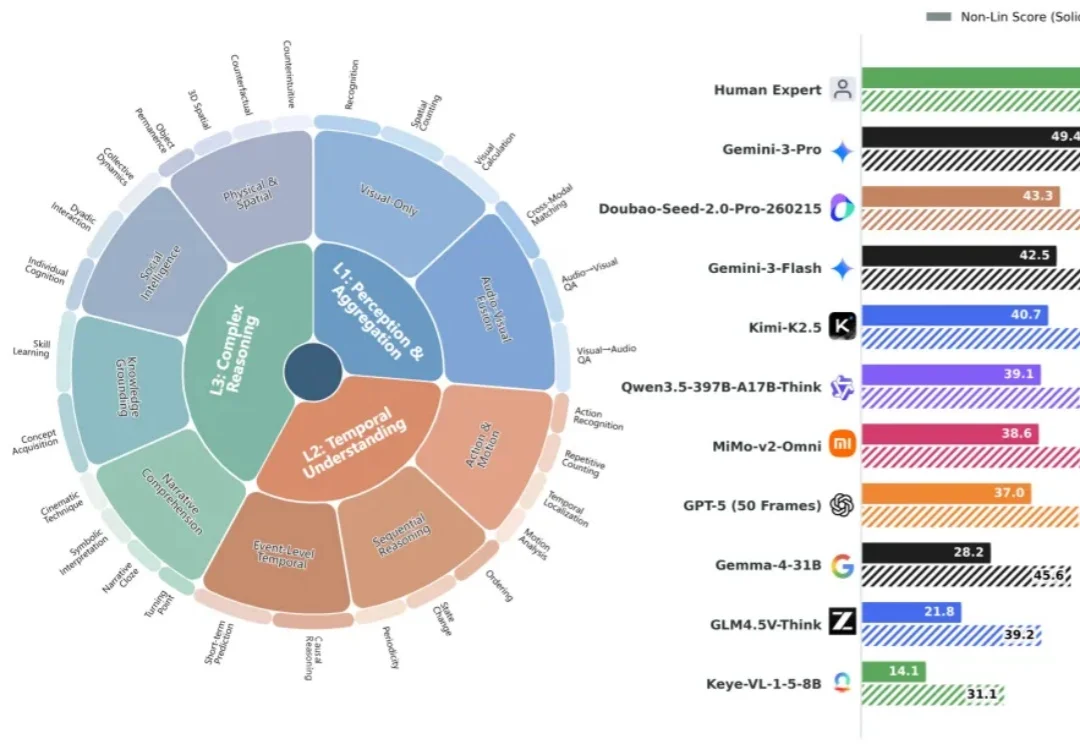
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
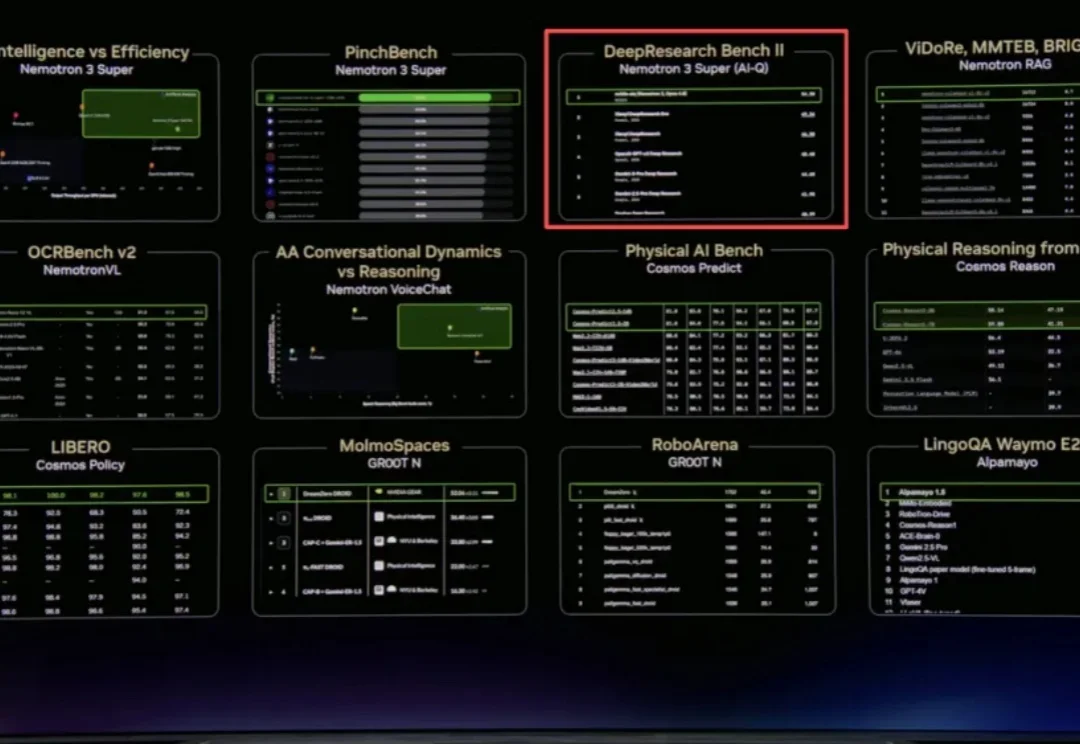
3 月 16 日,在刚刚结束的 NVIDIA GTC 2026 大会上,黄仁勋在长达三小时的 Keynote 演讲中发布了 NVIDIA Agent Toolkit 和 AI-Q 开放智能体蓝图,将 AI Agent 定位为下一个重大前沿。
嗨大家好!我是阿真! 前几天发过提示词生图相关的推文,大家普遍有个痛点,直接生成但是写提示词很痛苦,提示词调整来调整去,有点小问题又想再抽卡,最后时间浪费了,效果也一般般。
语言即武器。在《一九八四》里,大洋国发明了新话,其目的在于控制思维方式。AI测评媒体的小编们疑似对此进行借鉴,也开始通过语言通货膨胀的方式,批量发明更适合AI圈读者体质的新话,把咱读者朋友们调教得阈值越来越高,现在看正常文章都觉得食之无味。
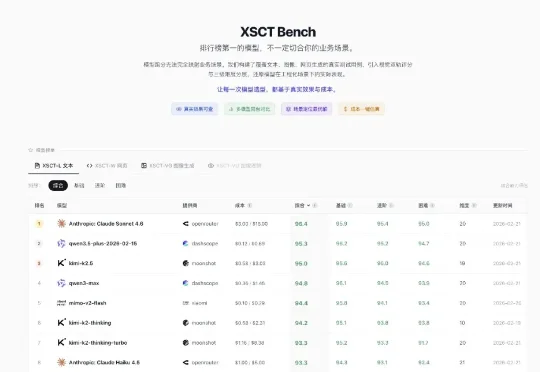
春节闭关五天,我做了个东西:一个大模型场景化测评平台。35000+ 次模型跑测,一共 42+ 模型,11,000 块人民币。我全部跑完了,结论汇成一个平台,还会持续更新。
今天我们来聊聊:AI 原生健康产品的标杆 —— Bevel。跟大家聊个最近我特真实的体感。这几年我一直半强迫自己戴着 Apple Watch,手机里还装了常年霸榜的 AutoSleep。我相信你们很多人也买了,但说实话:真挺鸡肋的。
最近,一篇由中国团队领衔全球24所TOP高校机构发布,用于评测LLMs for Science能力高低的论文,在外网炸了!当晚,Keras (最高效易用的深度学习框架之一)缔造者François Chollet转发论文链接,并喊出:「我们迫切需要新思路来推动人工智能走向科学创新。」