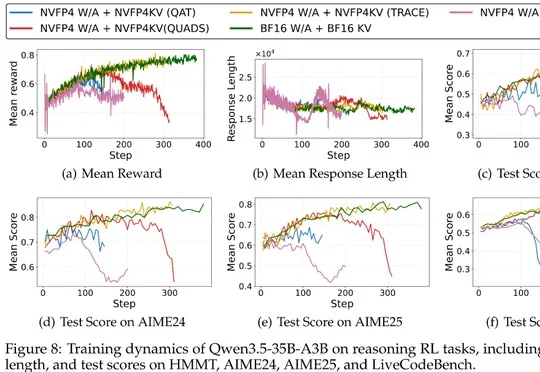
FP4 W/A+FP4 KV的强化学习也能「又快又稳」:阿里千问提出TRACE,Rollout最高加速5.4倍
FP4 W/A+FP4 KV的强化学习也能「又快又稳」:阿里千问提出TRACE,Rollout最高加速5.4倍阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
来自主题: AI技术研报
5878 点击 2026-10-24 13:41

 搜索
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
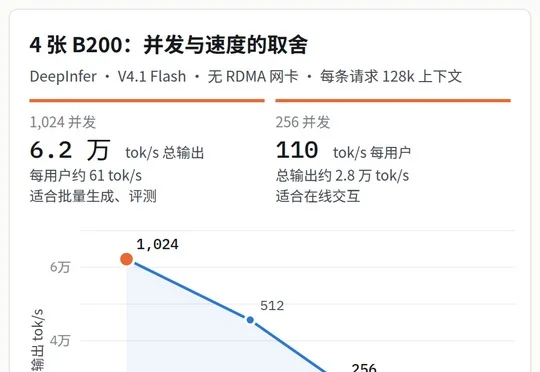
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
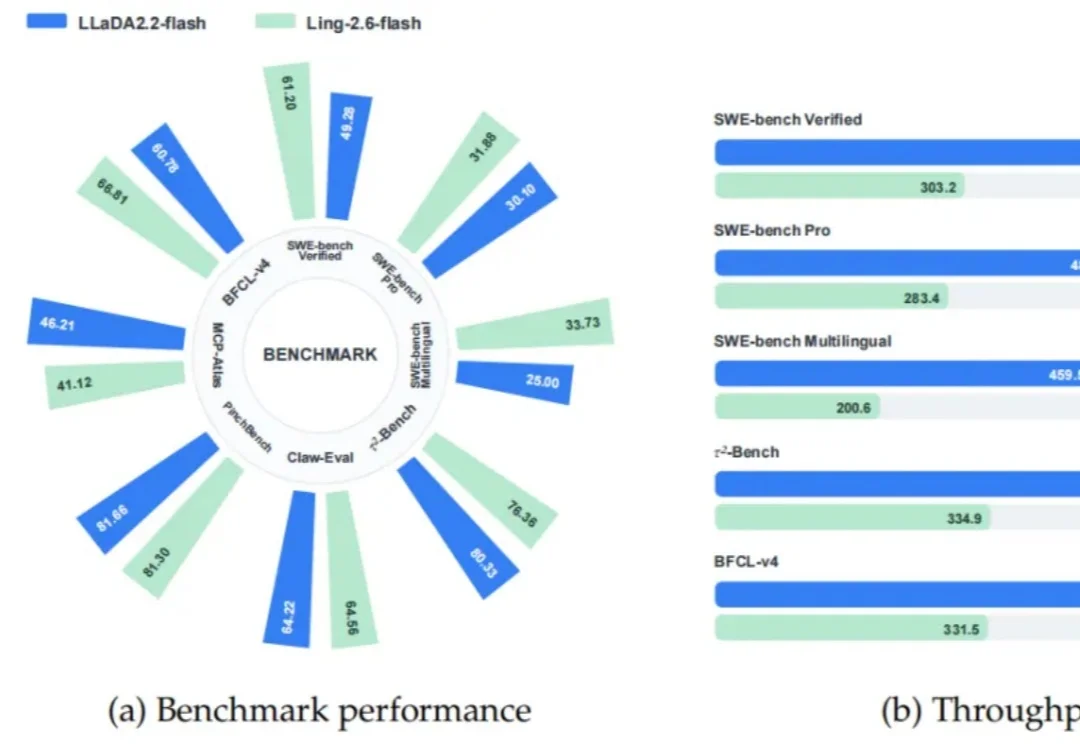
终于!Agent赛道,不再是自回归(AR)模型一家独大。
今天,多位开发者在DeepSeek官方交流群和社交媒体上反馈,DeepSeek官方API所调用的模型能力出现了变化,已拥有一百万的上下文窗口,而不是此前的128k,知识截止日期更新为2025年5月,而不是此前的2024年。
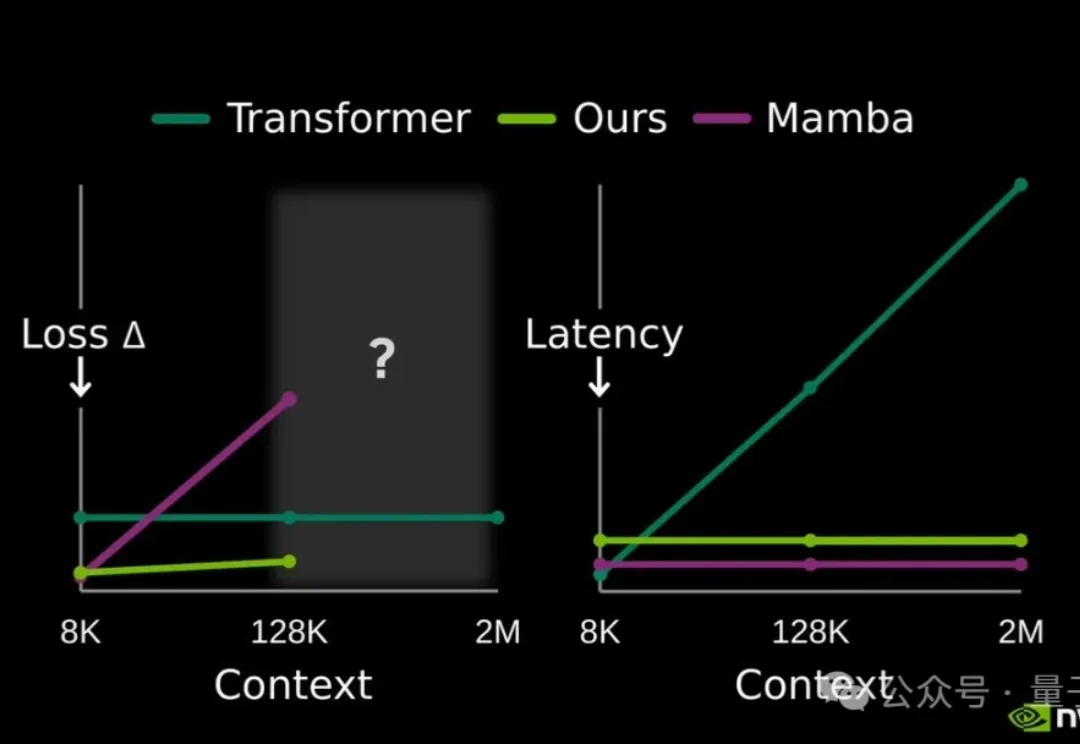
提高大模型记忆这块儿,美国大模型开源王者——英伟达也出招了。
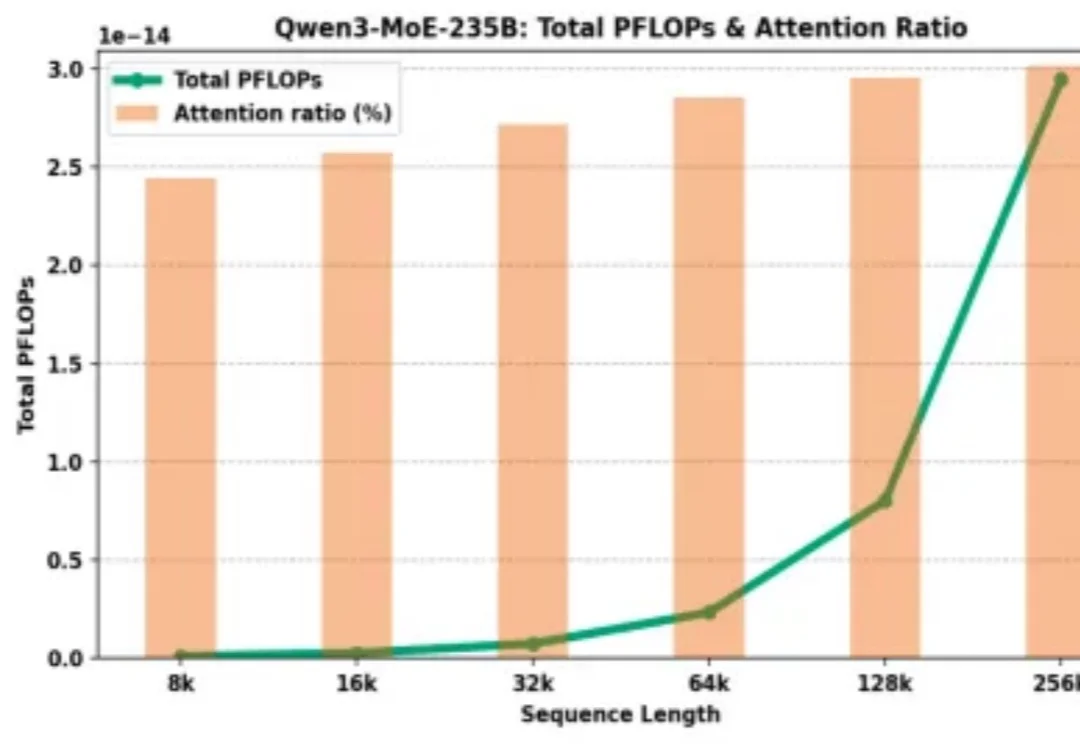
为什么大模型厂商给了 128K 的上下文窗口,却在计费上让长文本显著更贵?
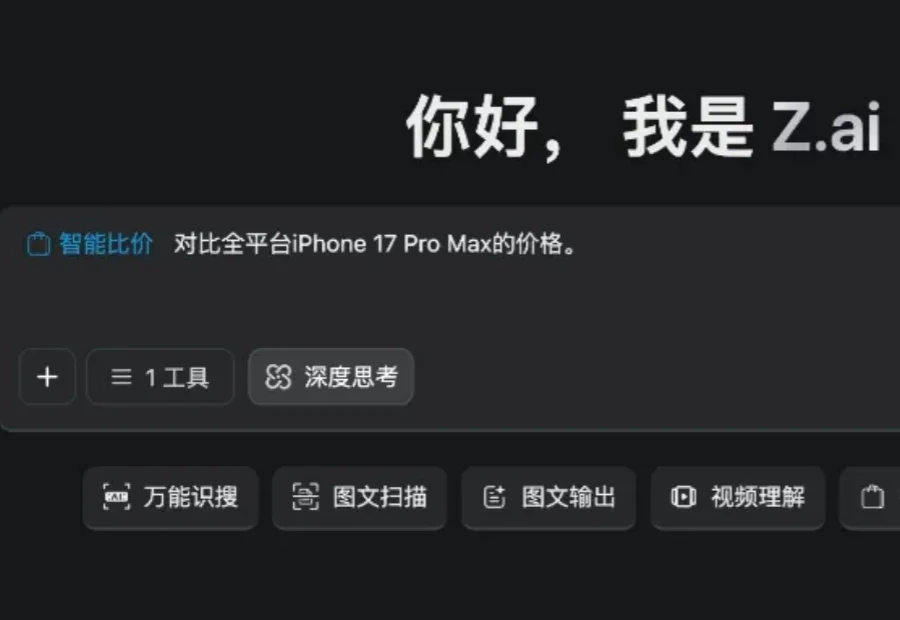
原生工具调用、128K上下文,图文创作仍有短板。
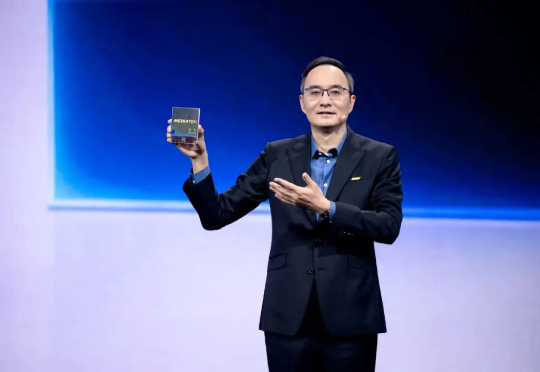
9 月 22 日下午,联发科推出的新一代旗舰 5G 智能体 AI 芯片 —— 天玑 9500,并展示了一系列新形态端侧的 AI 应用,在公众层面首次推动端侧 AI 从尝鲜到好用。现在,让手机端大语言模型(LLM)处理一段超长的文本,最长支持 128K 字元,它只需要两秒就能总结出会议纪要,AI 还能自动修改你的错别字。
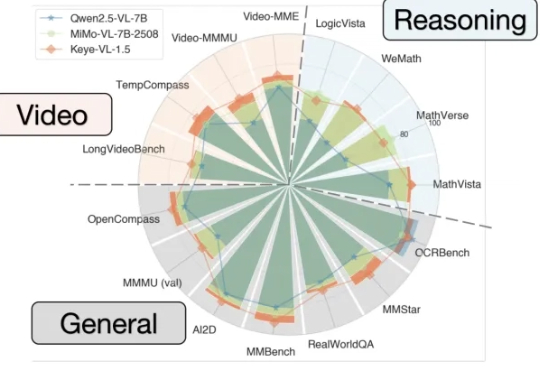
能看懂视频并进行跨模态推理的大模型Keye-VL 1.5,快手开源了。
Grok-2正式开源,登上Hugging Face,9050亿参数+128k上下文有多猛?近万亿参数「巨兽」性能首曝。马斯克再现「超人」速度,AI帝国正在崛起。