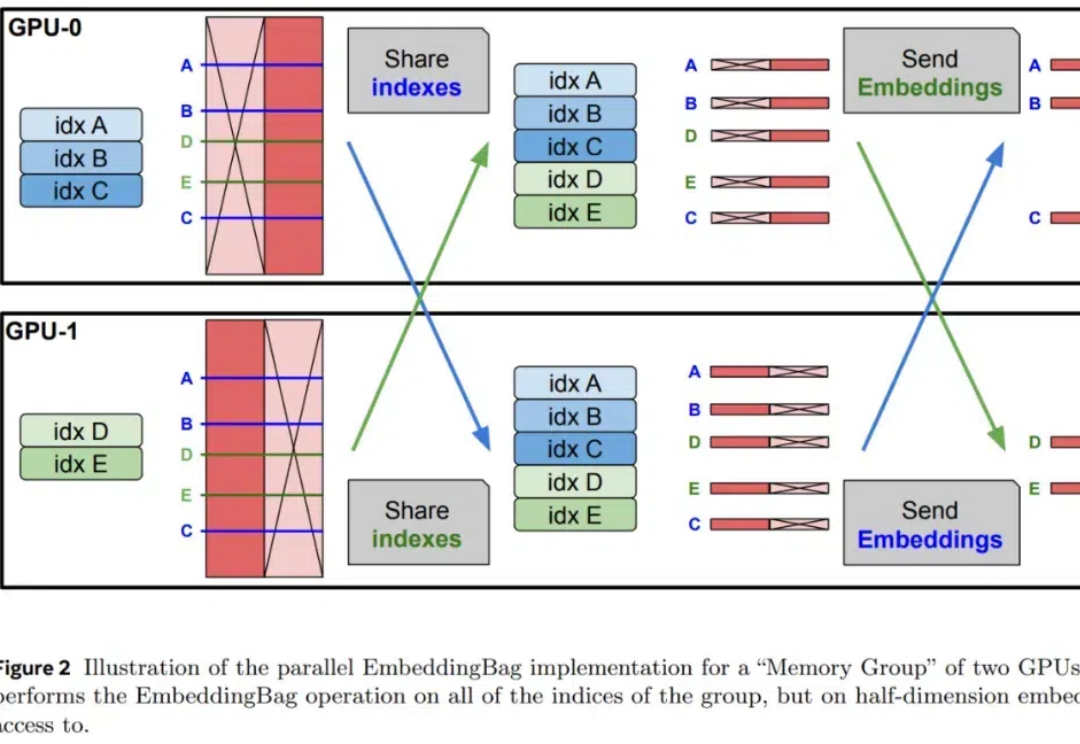
Meta探索大模型记忆层,扩展至1280亿个参数,优于MoE
Meta探索大模型记忆层,扩展至1280亿个参数,优于MoE预训练语言模型通常在其参数中编码大量信息,并且随着规模的增加,它们可以更准确地回忆和使用这些信息。
来自主题: AI技术研报
9368 点击 2025-01-04 14:14

 搜索
预训练语言模型通常在其参数中编码大量信息,并且随着规模的增加,它们可以更准确地回忆和使用这些信息。
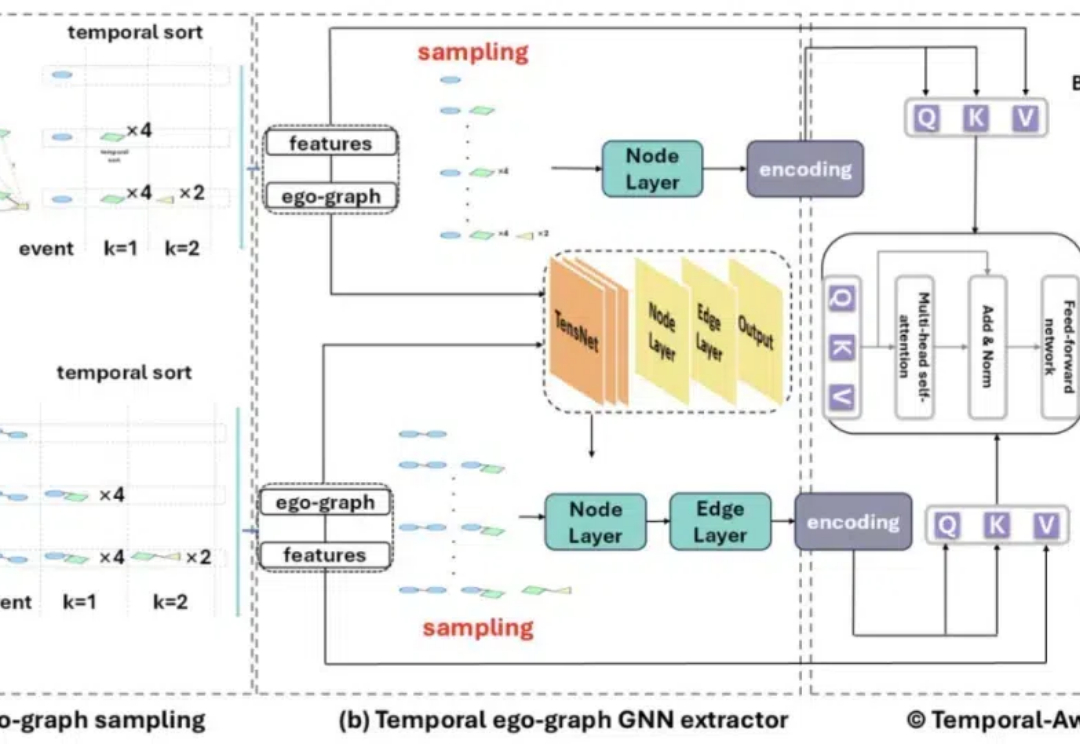
此项研究成果已被 AAAI 2025 录用。该论文的第一作者是南洋理工大学计算与数据科学学院 (CCDS) 的硕士生杨潇,师从苗春燕教授,主要研究方向是图神经网络。
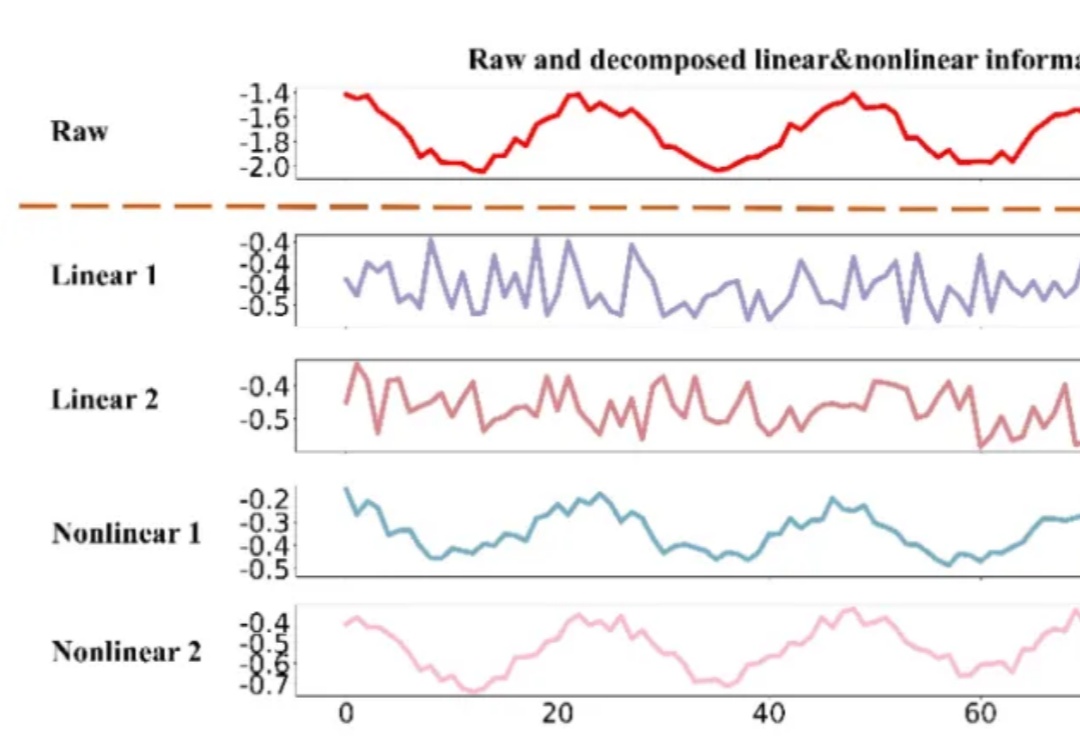
时间序列数据,作为连续时间点的数据集合,广泛存在于医疗、金融、气象、交通、能源(电力、光伏等)等多个领域。有效的时间序列预测模型能够帮助我们理解数据的动态变化,预测未来趋势,从而做出更加精准的决策。
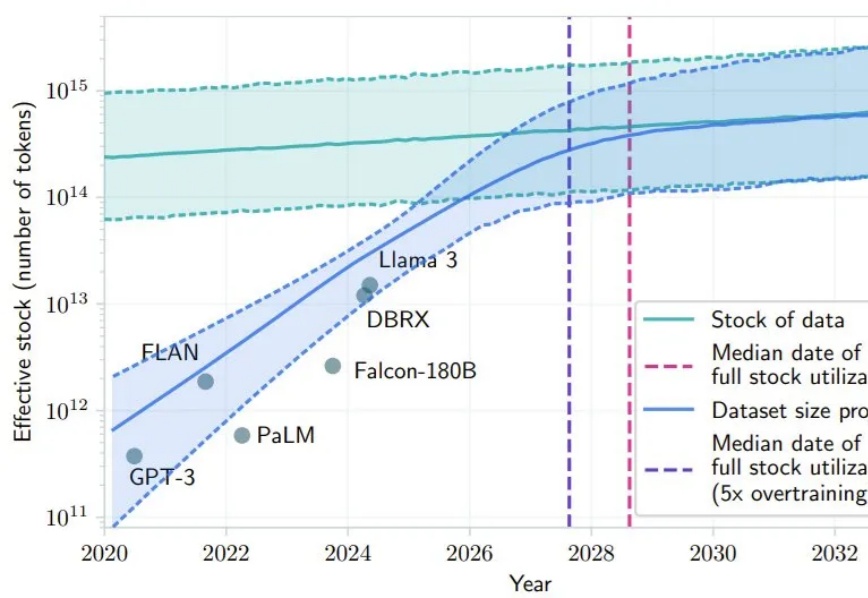
最近 AI 社区很多人都在讨论 Scaling Law 是否撞墙的问题。其中,一个支持 Scaling Law 撞墙论的理由是 AI 几乎已经快要耗尽已有的高质量数据,比如有一项研究就预计,如果 LLM 保持现在的发展势头,到 2028 年左右,已有的数据储量将被全部利用完。
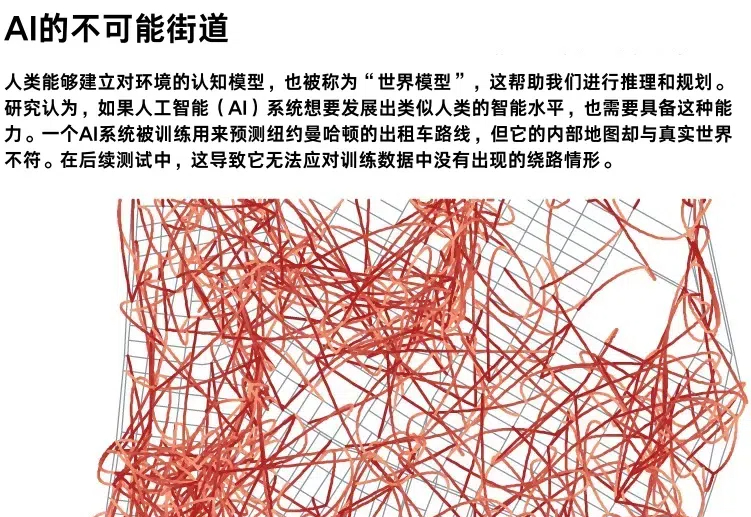
"机器究竟还需要多长时间,才能真正具备人类大脑的认知能力?"这个困扰人工智能领域数十年的根本性问题,在2024年末再次成为全球科技界的焦点。
继电动车、消费品之后,中国团队又在AI领域上演了一出“成本屠夫”的好戏。
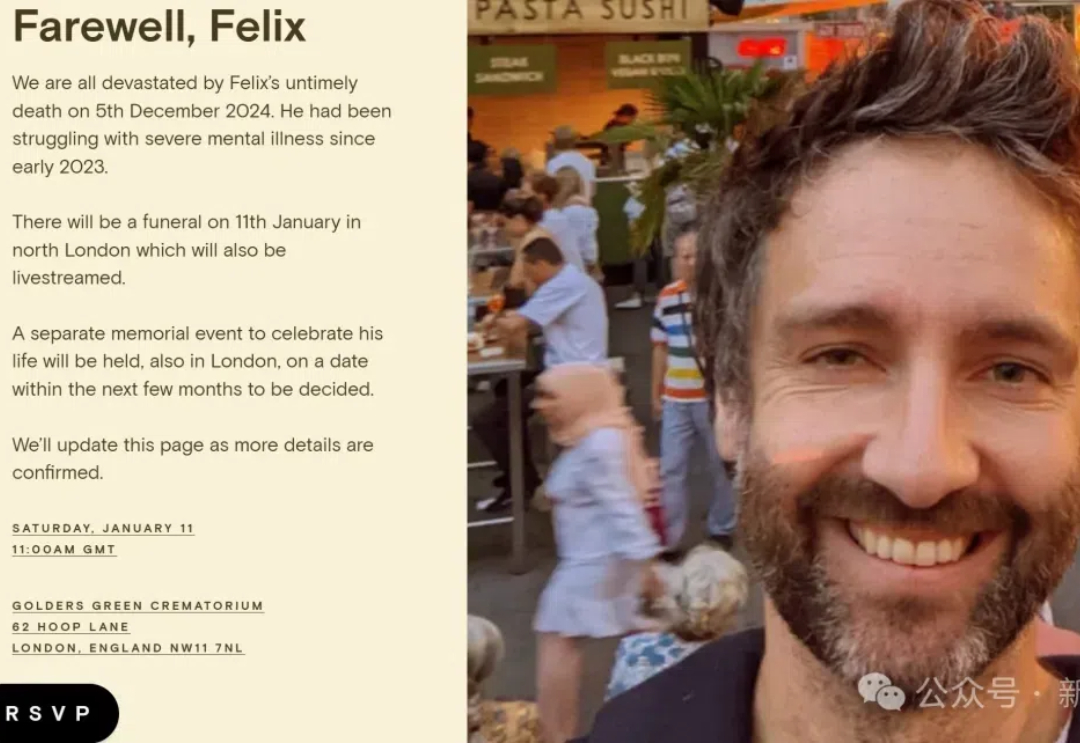
就在刚刚,噩耗传来:年仅41岁的谷歌DeepMind天才科学家Felix Hill英年早逝。
2025 年即将到来的三大技术突破。
但咱觉得吧,显卡还是很重要的
过去一段时间,“预训练终结”成为了 AI 领域最热烈的讨论之一。OpenAI的GPT系列模型此前大踏步的前进,预训练是核心推动力。而前 OpenAI 首席科学家 Ilya Sutskever、预训练和scaling law(规模定律)最忠实的倡导者,却宣称预训练要终结了、scaling law要失效。由此,引发了大量争议。