时序大模型突破十亿参数!新混合专家架构,普林斯顿格里菲斯等机构出品
时序大模型突破十亿参数!新混合专家架构,普林斯顿格里菲斯等机构出品时序大模型,参数规模突破十亿级别。 来自全球多只华人研究团队提出了一种基于混合专家架构(Mixture of Experts, MoE)的时间序列基础模型——Time-MoE。
来自主题: AI资讯
6650 点击 2024-10-28 17:13

 搜索
时序大模型,参数规模突破十亿级别。 来自全球多只华人研究团队提出了一种基于混合专家架构(Mixture of Experts, MoE)的时间序列基础模型——Time-MoE。
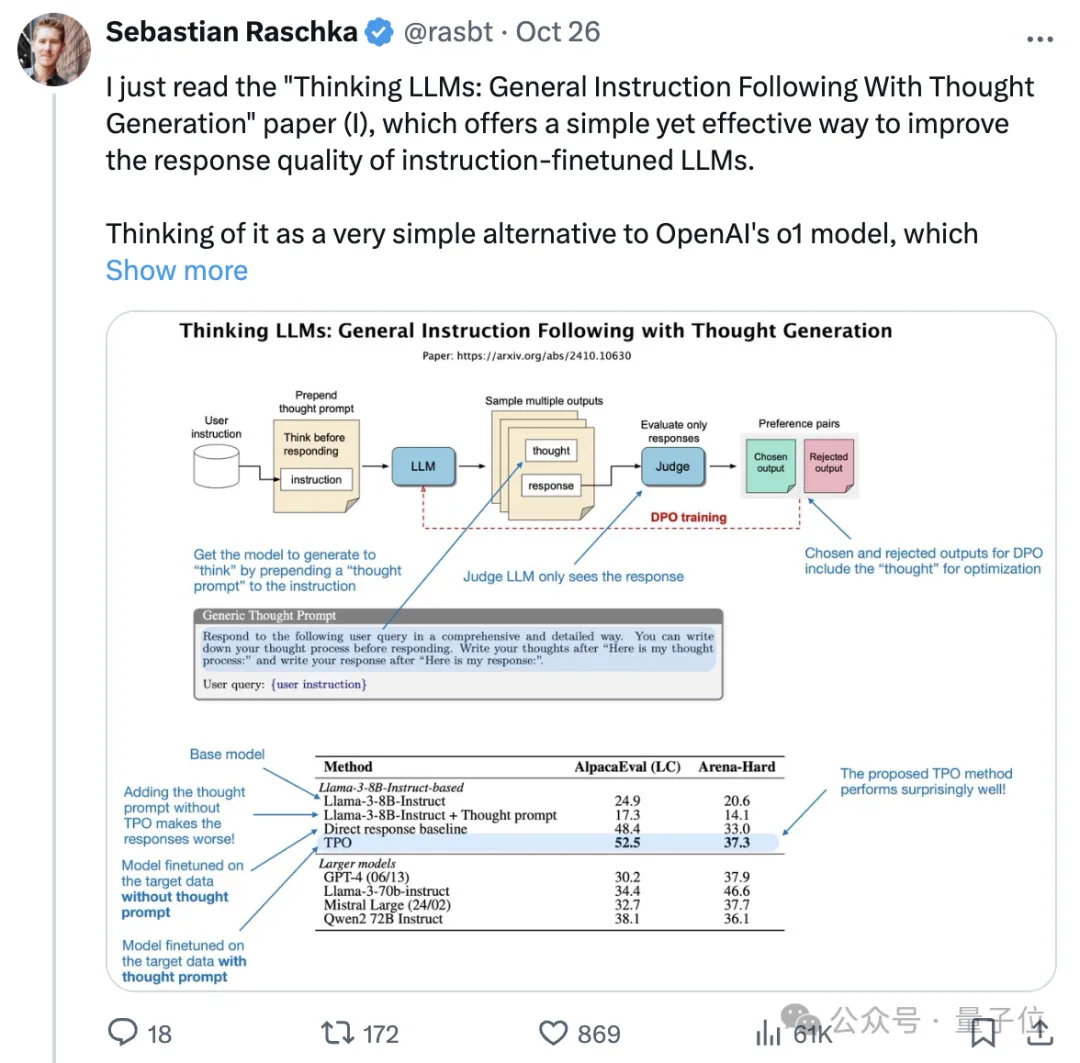
OpenAI-o1替代品来了,大模型能根据任务复杂度进行不同时间的思考。 不限于推理性的逻辑或数学任务,一般问答也能思考的那种。 最近畅销书《Python机器学习》作者Sebastian Raschka推荐了一项新研究,被网友们齐刷刷码住了。
仅需1块80G显卡,大模型理解小时级超长视频。 智源研究院联合上海交通大学、中国人民大学、北京大学和北京邮电大学等多所高校带来最新成果超长视频理解大模型Video-XL。
清华物理系传奇特奖得主Yao Shunyu,正式投身大模型,加入Anthropic的Claude团队。
人工智能领域的开源问题一直存在,其中最大的争议点是到底什么样的人工智能可以称之为“开源”。开放源代码倡议(OSI)作为业内公认的开源仲裁机构,二十五年来一直负责管理开放源代码定义 (OSD)。在过去两三年中,OSI 致力于为开源 AI 制定定义和标准,以构建可供任何人用于研究、修改和共享的 AI 系统。

近日,天桥脑科学研究院和普林斯顿大学等多所研究机构发布了一篇研究论文,详细阐述了长期记忆对 AI 自我进化的重要性,并且他们还提出了自己的实现框架 —— 基于多智能体的 Omne,其在 GAIA 基准上取得了第一名的成绩。

近日,极佳科技联合中国科学院自动化研究所、理想汽车、北京大学、慕尼黑工业大学等单位提出DriveDreamer4D,是首个利用世界模型增强 4D 驾驶场景重建效果的工作。
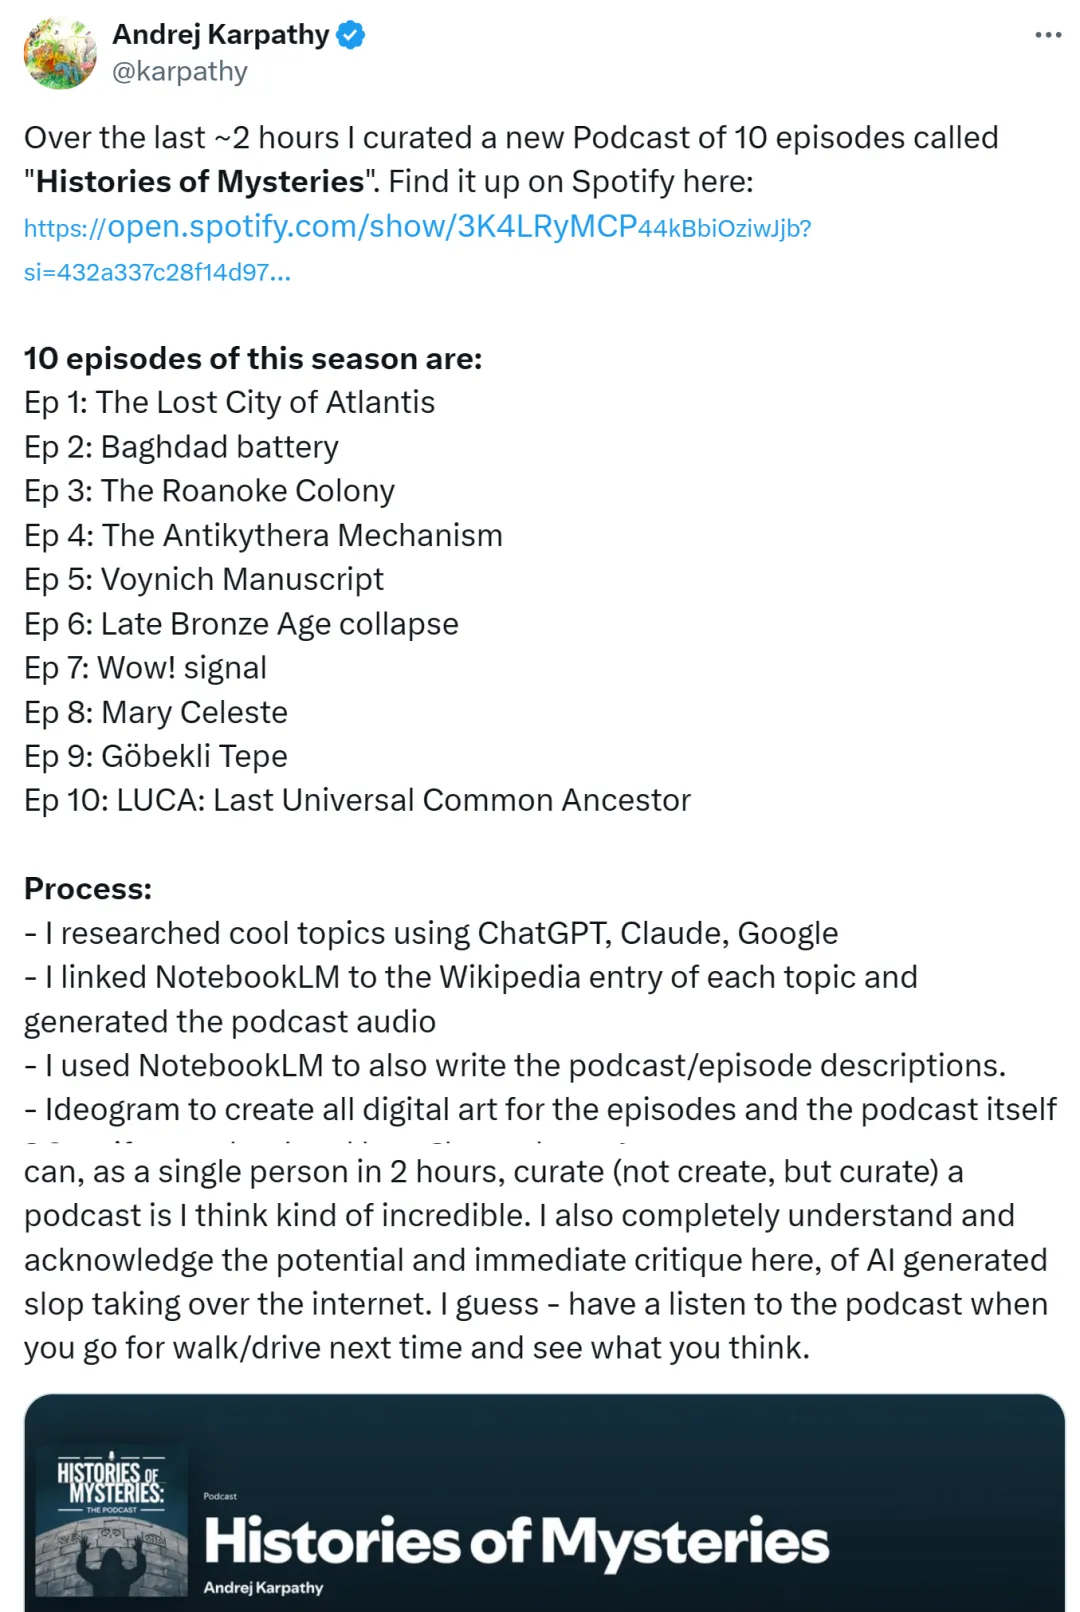
随着谷歌和 Meta 相继推出基于大语言模型的 AI 播客功能,将极大地丰富人类用户与 AI 智能体互动的体验。

视频内容的快速增长给视频检索技术,特别是细粒度视频片段检索(VCMR),带来了巨大挑战。VCMR 要求系统根据文本查询从视频库中精准定位视频中的匹配片段,需具备跨模态理解和细粒度视频理解能力。
AI 开发者之所以一致认为编程的重要性,是有原因的:大型语言模型编程能力越强,它回答与软件无关的其他类型问题的能力也越强。