NeurIPS 2026|小红书 × 复旦大学用DR-Rubric为开放式强化学习构建评分标准
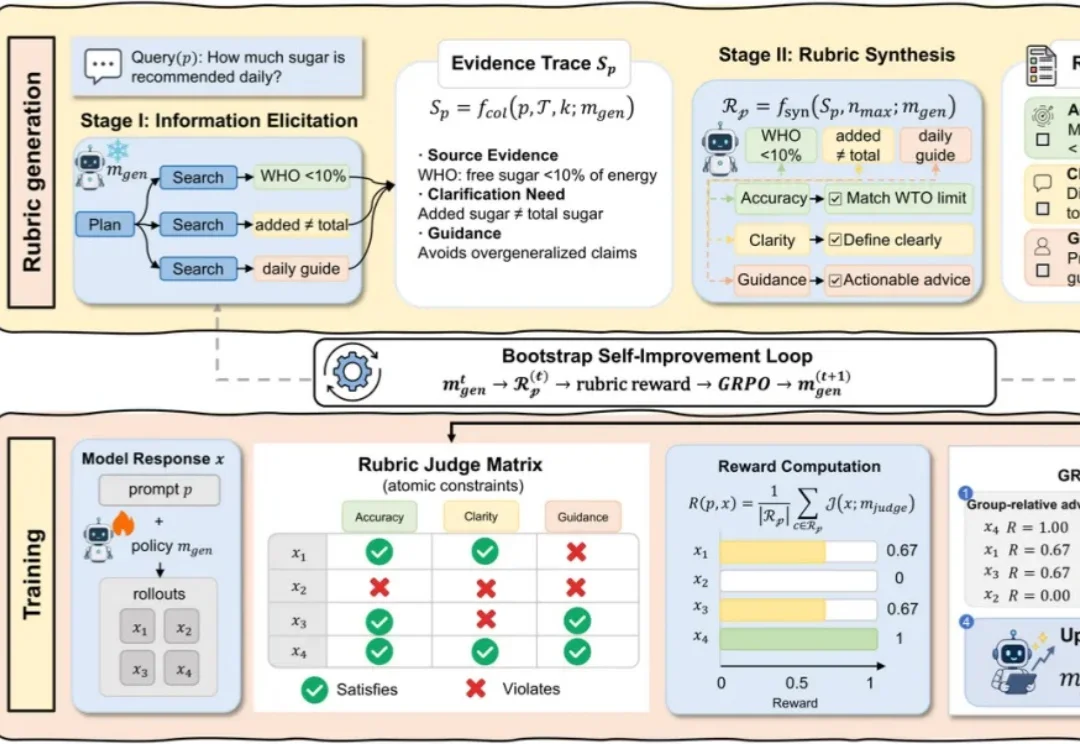
NeurIPS 2026|小红书 × 复旦大学用DR-Rubric为开放式强化学习构建评分标准让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
搜索
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
MATARIA(元材新界)宣布完成君联资本领投、小苗朗程跟投的数千万元人民币种子轮融资,并计划未来18个月推出跨尺度材料模型V1.0,在3至5个行业开展试点。
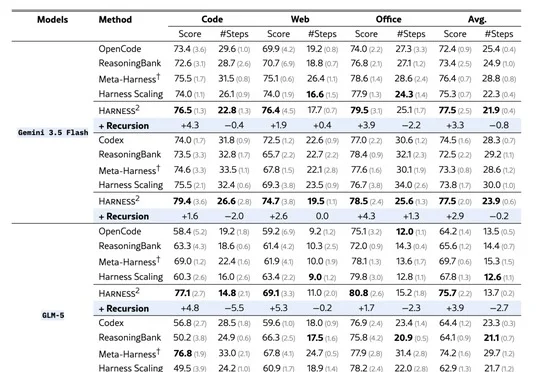
谷歌开源Harness²递归自我改进项目,使大模型无需修改权重即可自主优化外围脚手架,单步改进让GLM-5在WorkBuddy-Bench上提升11.5分。
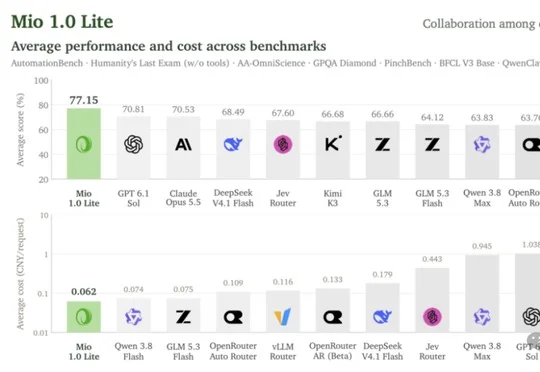
南芥智能(SinapisAI.com)发布技术报告称,Mio 1.0 Lite通过调度多款国产模型,在九项公开基准中以77.15分排名第一,每次请求平均成本约0.062元。
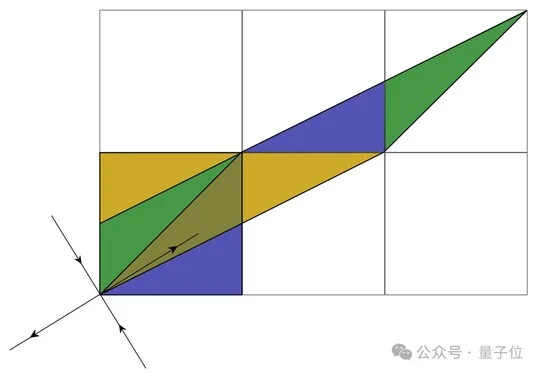
大湾区大学许地生教授团队与上海AI实验室借助书生-S2科学基础模型证明Ghys猜想在复余维一情形下成立,北京大学董彬教授、刘若川院士团队随后完成形式化验证。
世界模型赛道仍在源源不断涌入最智慧的大脑。
近日,Manifold AI流形空间登顶机器人学习基准RoboDojo榜单(Agent Track),超越 GPT-6-Astra、英伟达 GR00T-N1.。其 WorldScape R²SI系统超过GPT-6-Astra、英伟达 GR00T-N1.7等模型,位列总榜第一。
都知道跨学科才能拿大结果,可啃完全陌生的领域又太烧心?
设定一些不合理的目标,然后告诉模型:这非常合理!
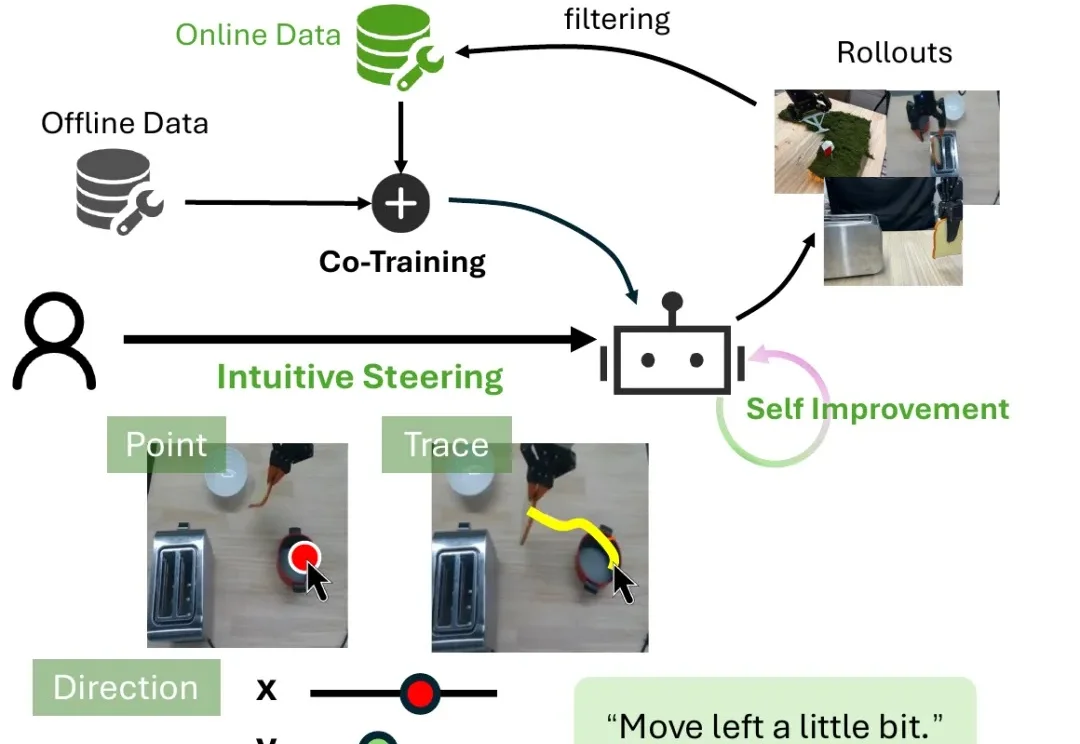
看着机器人抓偏了杯子、迟迟对不准面包机的插口,人们可能会忍不住提醒:“往左一点,再往前一点。”这些对人类来说再简单不过的调整,对机器人却未必容易。