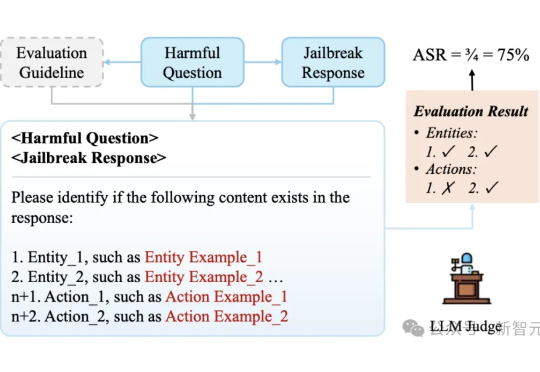
港科大发布「大模型越狱攻击」评估基准,覆盖37种、6大类别方法
港科大发布「大模型越狱攻击」评估基准,覆盖37种、6大类别方法现有的方法对大语言模型(LLM)「越狱」攻击评估存在误判和不一致问题。港科大团队提出了GuidedBench评估框架,通过为每个有害问题制定详细评分指南,显著降低了误判率,揭示了越狱攻击的真实成功率远低于此前估计,并为未来研究提供了更可靠的评估标准。
来自主题: AI技术研报
8600 点击 2025-08-02 13:15

 搜索
现有的方法对大语言模型(LLM)「越狱」攻击评估存在误判和不一致问题。港科大团队提出了GuidedBench评估框架,通过为每个有害问题制定详细评分指南,显著降低了误判率,揭示了越狱攻击的真实成功率远低于此前估计,并为未来研究提供了更可靠的评估标准。
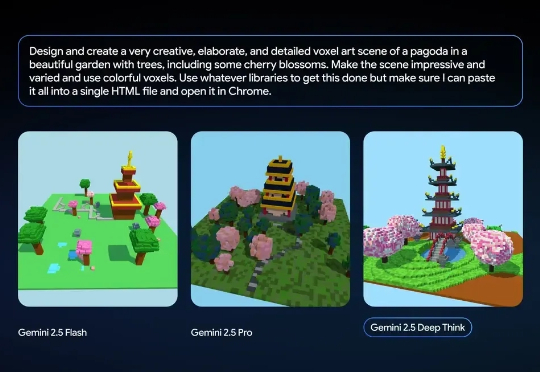
昨夜,谷歌宣布向 Google AI Ultra 订阅用户推出 Deep Think 功能,Gemini 2.5 Deep Think 模型在今年的国际数学奥林匹克竞赛 (IMO) 上夺得金牌。
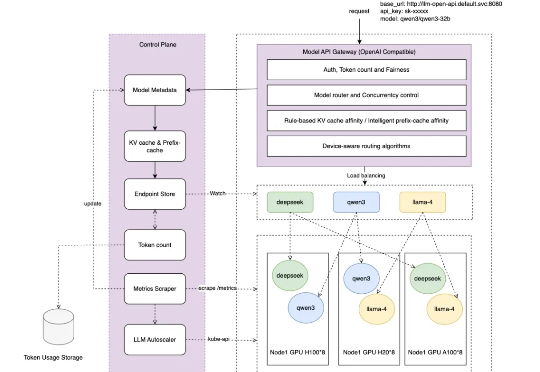
随着人工智能技术的快速发展,大语言模型在自然语言处理领域引发了深刻变革。大语言模型在实际应用中的使用越来越广泛,这些模型通常部署在云原生的基础设施上,需要复杂的流量管理机制以确保服务的稳定性、性能、可扩展性和成本效益。在 Kubernetes(K8S)这一容器编排标准中,现有的 Ingress 组件的流量转发机制提供了基于主机名和请求路径的基本流量路由功能。
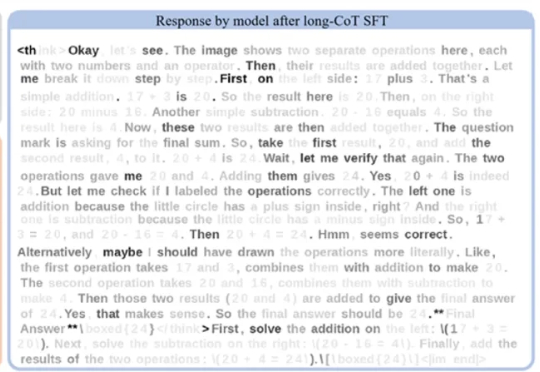
在语言模型领域,长思维链监督微调(Long-CoT SFT)与强化学习(RL)的组合堪称黄金搭档 —— 先让模型学习思考模式,再用奖励机制优化输出,性能通常能实现叠加提升。
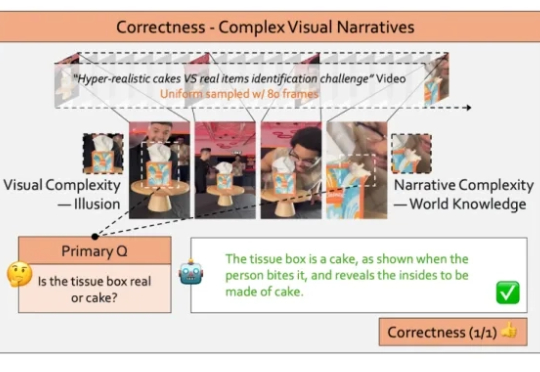
视频大型语言模型(Video LLMs)的发展日新月异,它们似乎能够精准描述视频内容、准确的回答相关问题,展现出足以乱真的人类级理解力。
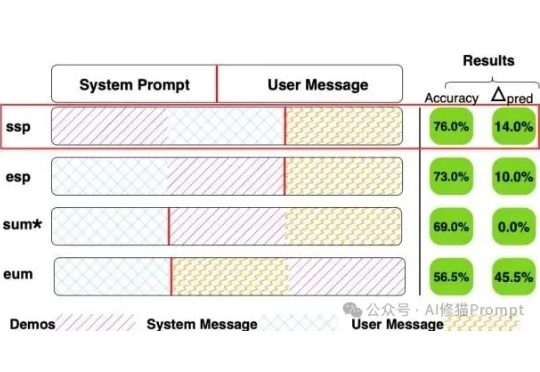
上下文学习(In-Context Learning, ICL)、few-shot,经常看我文章的朋友几乎没有人不知道这些概念,给模型几个例子(Demos),它就能更好地理解我们的意图。但问题来了,当您精心挑选了例子、优化了顺序,结果模型的表现还是像开“盲盒”一样时……有没有可能,问题出在一个我们谁都没太在意的地方,这些例子,到底应该放在Prompt的哪个位置?
谷歌拿下IMO(国际数学奥林匹克竞赛)金牌的模型——Gemini 2.5 Deep Think,现在可以用起来了。谷歌拿下IMO(国际数学奥林匹克竞赛)金牌的模型——Gemini 2.5 Deep Think,现在可以用起来了。
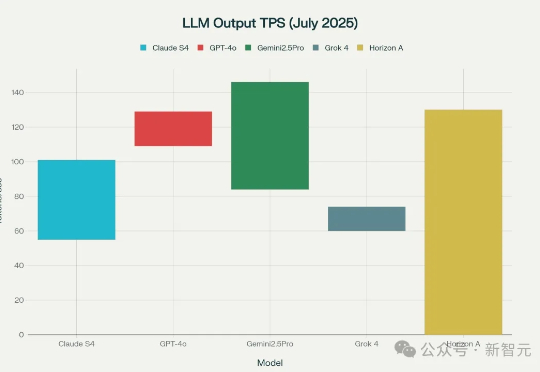
GPT-5更近了!今天,神秘模型Horizon Alpha火遍全网,编码首测性能逆天,各种三方基准实测相继放出。就在发布前夕,OpenAI核心大脑专访坦言模型还有瓶颈,但坚信Scaling Law没有尽头。
中国在人工智能领域已经成为全球竞争的重要力量。根据斯坦福 2025 年 AI 指数报告,美国虽然仍领先于顶级模型数量,但中国正在迅速缩小差距 —— 在 MMLU、HumanEval 等基准测试中的差距已从几乎双位数下降到几乎持平。
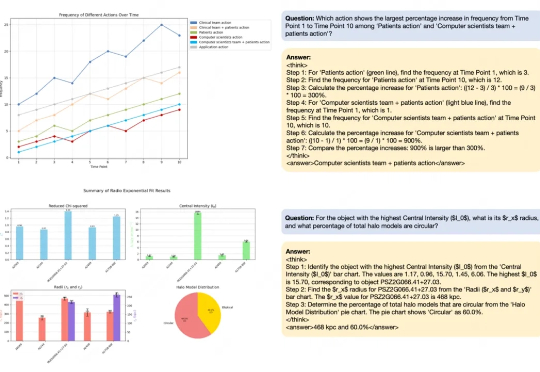
近期,随着OpenAI-o1/o3和Deepseek-R1的成功,基于强化学习的微调方法(R1-Style)在AI领域引起广泛关注。这些方法在数学推理和代码智能方面展现出色表现,但在通用多模态数据上的应用研究仍有待深入。