刚刚,小米刷新 AI 大模型斩杀线,罗福莉:技术难度超过 DeepSeek R1
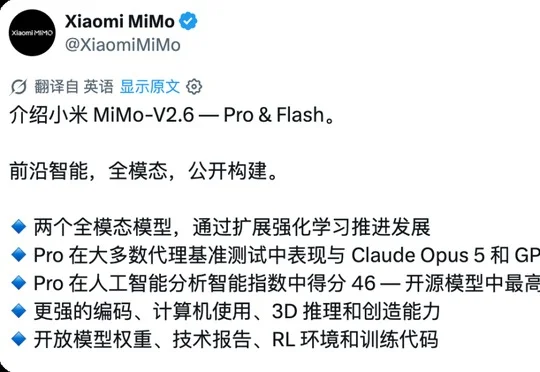
刚刚,小米刷新 AI 大模型斩杀线,罗福莉:技术难度超过 DeepSeek R1小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
搜索
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
过去一年,Agent 的讨论大多围绕模型本身展开:推理能力更强、上下文更长、工具调用更稳定。但进入真实工作流后,另一个问题开始变得更关键:Agent 的能力从哪里来,又如何被持续复用。
就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
就在刚刚,马斯克SpaceXAI正式发布,全新主力模型Grok 4.7!
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
时间到了2026年9月,我们基本可以宣布世界模型是一个垃圾概念。
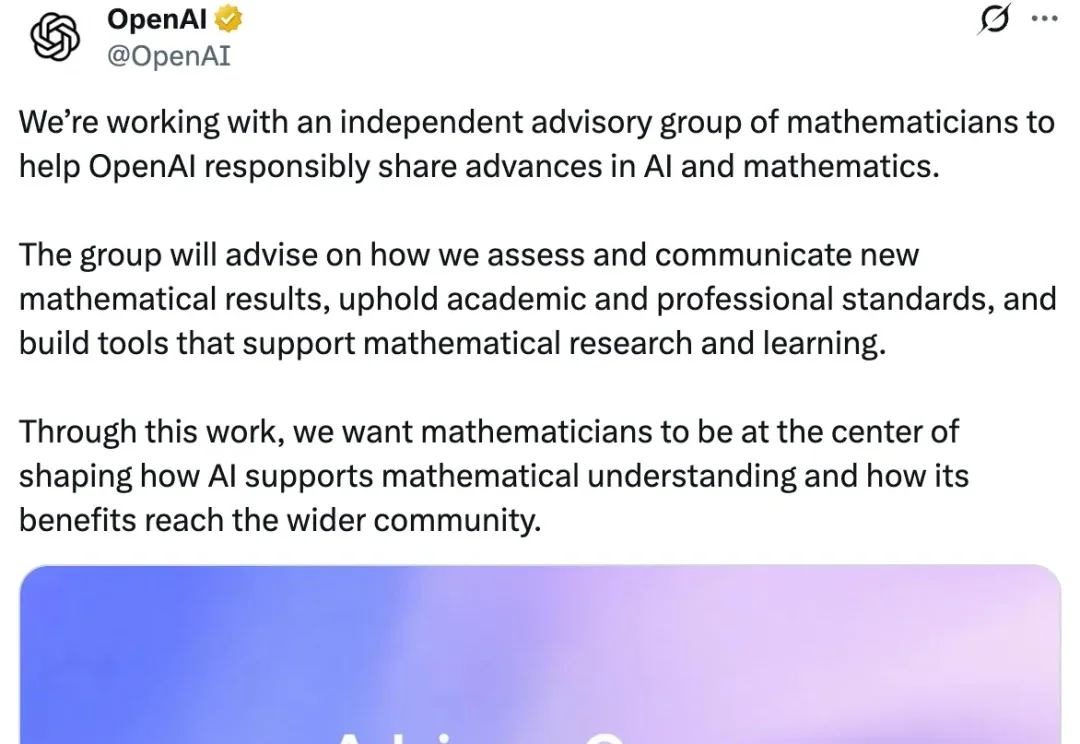
在一道千禧年大奖难题的解答还在接受数学界审视的同时,超过 100 道长期开放问题也已经被内部模型解决。OpenAI 最新公布的信息描绘了这样的局面。
一款能走进真实工作的生图模型。
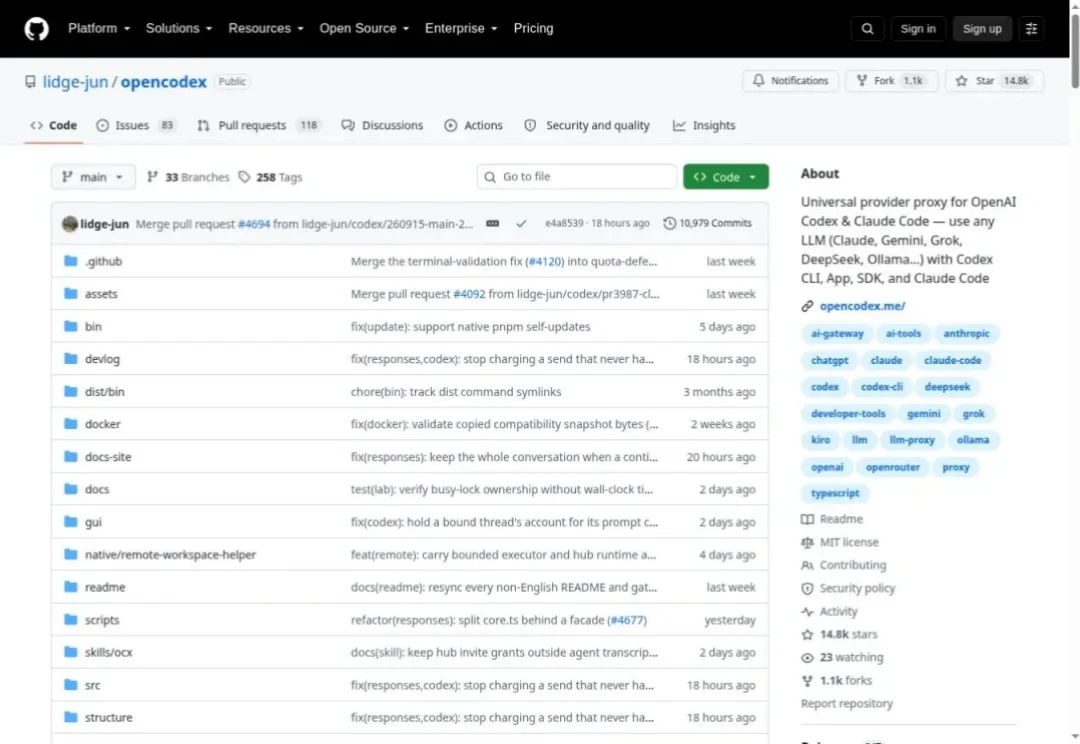
上周发了折腾 WebCodex 的文章《把ChatGPT几乎无限的网页额度当Codex用》,文章下面,就有小伙伴接着问:能不能让不同的模型,去干不同的活?
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?