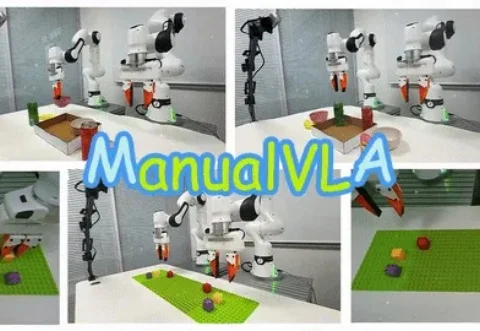
北大发布 ManualVLA:首个长程「生成–理解–动作」一体化模型,实现从最终状态自主生成说明书并完成操纵
北大发布 ManualVLA:首个长程「生成–理解–动作」一体化模型,实现从最终状态自主生成说明书并完成操纵视觉–语言–动作(VLA)模型在机器人场景理解与操作上展现出较强的通用性,但在需要明确目标终态的长时序任务(如乐高搭建、物体重排)中,仍难以兼顾高层规划与精细操控。
来自主题: AI技术研报
10627 点击 2025-12-19 10:23

 搜索
视觉–语言–动作(VLA)模型在机器人场景理解与操作上展现出较强的通用性,但在需要明确目标终态的长时序任务(如乐高搭建、物体重排)中,仍难以兼顾高层规划与精细操控。
在计算机图形学、三维视觉、虚拟人、XR 领域,SIGGRAPH 是毫无争议的 “天花板级会议”。 SIGGRAPH Asia 作为 SIGGRAPH 系列两大主会之一,每年只接收全球最顶尖研究团队的成果稿件,代表着学术与工业界的最高研究水平与最前沿技术趋势。
当国产AI芯片接连发布、估值高涨之际,一个尖锐的问题依然悬在头顶:它们真的能撑起下一代万卡集群与万亿参数模型的训练吗?
周五凌晨,OpenAI 发布 GPT-5.2-Codex,这是迄今为止最先进的智能体编码模型,专为复杂的实际软件工程而设计。GPT-5.2-Codex 是 GPT-5.2 的升级版本,提高了指令遵循能力、对长远语境的理解能力,它针对 Codex 中的智能体编码进行了进一步优化,包括通过上下文压缩改进长期工作。
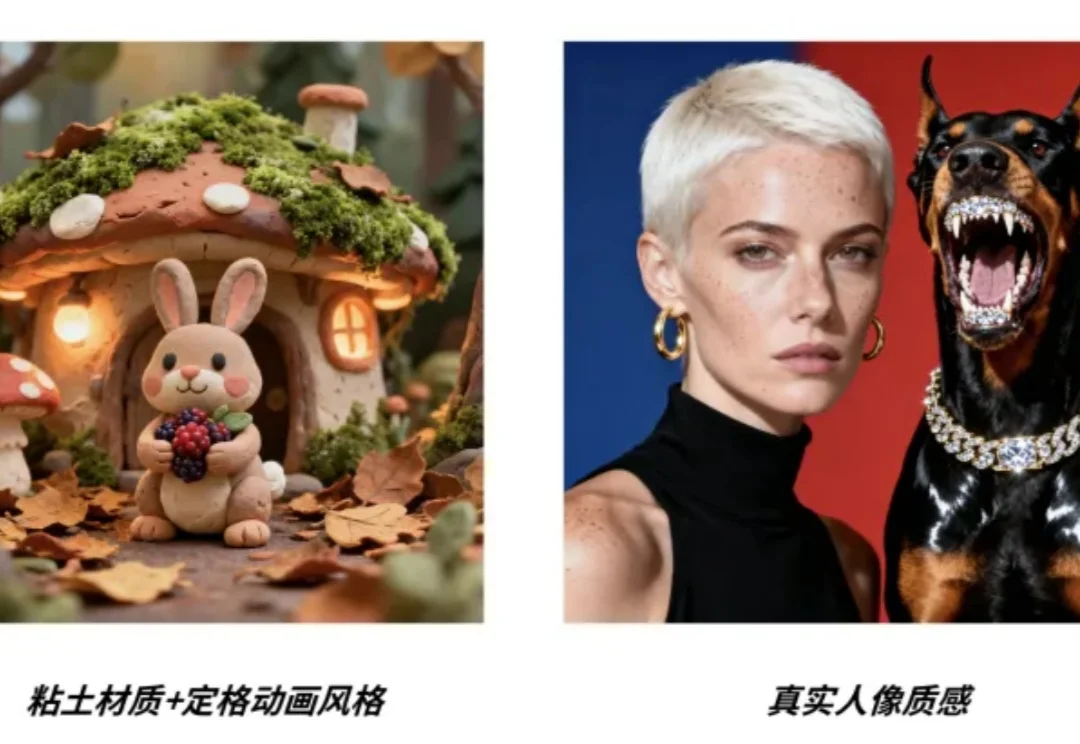
坏了,阿里这波是冲着Sora 2去的!
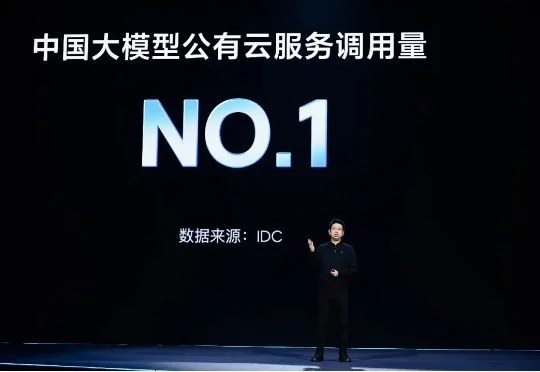
今天,在 FORCE 原动力大会上,火山引擎发布豆包大模型1.8、豆包视频生成模型 Seedance 1.5 pro。经过一年多的持续升级,豆包大模型家族在多模态理解和生成能力、Agent 能力上,已位于全球第一梯队。
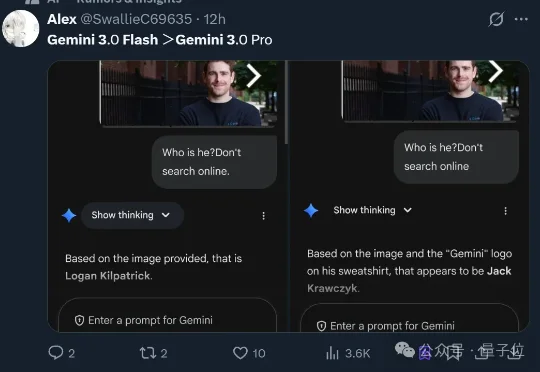
谷歌丢出Gemini 3 Flash,给AI圈示范了啥叫:小孩子才做选择题,成年人当然是全都要(doge)。一个公式来形容这款新模型:Gemini 3 Flash=Pro级智能+Flash级速度+更低价格。
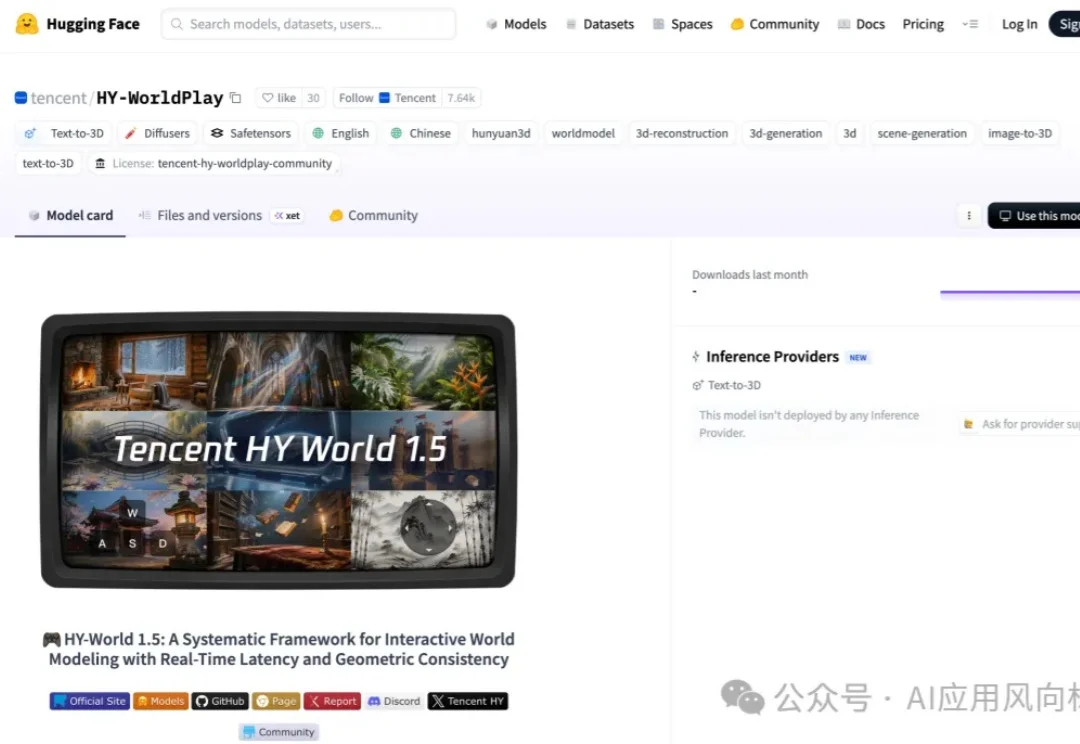
可支持24帧/秒的长时流式生成。
AI竞技场开始清场。
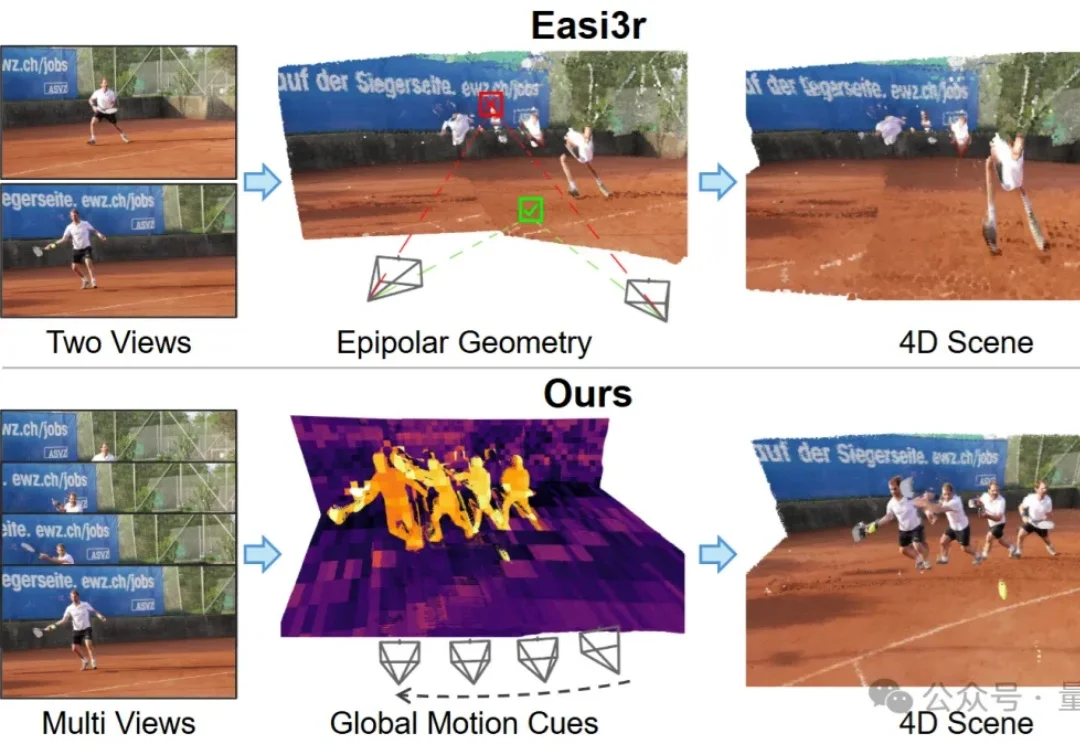
如何让针对静态场景训练的3D基础模型(3D Foundation Models),在不增加训练成本的前提下,具备处理动态4D场景的能力?