AI资讯新闻榜单内容搜索-模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型
AIVC:一文读懂AI虚拟细胞

AIVC:一文读懂AI虚拟细胞

AIVC:一文读懂AI虚拟细胞

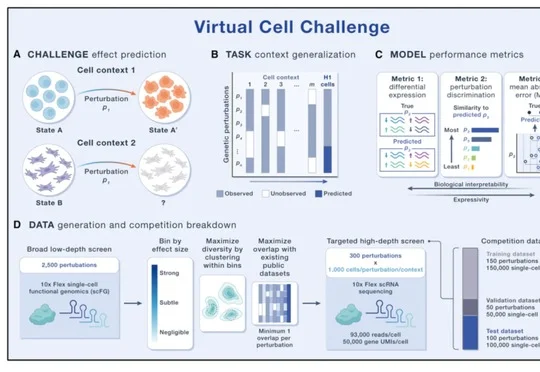
AI虚拟细胞(AIVC)正围绕基础模型、扰动数据、算力和评测标准展开竞赛,百图生科等机构加速布局,但纯AI尚不能稳定战胜统计基线,高质量扰动数据仍是瓶颈。

来自主题: AI资讯
8937 点击    2026-10-06 14:38
Rabbit创始人吕骋:人不该为Agent改变思考方式

Rabbit创始人吕骋:人不该为Agent改变思考方式

Rabbit创始人吕骋:人不该为Agent改变思考方式

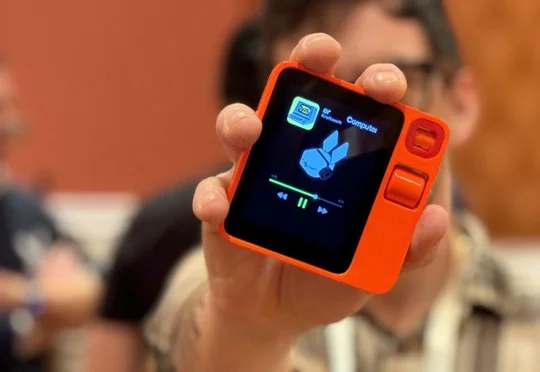
Rabbit创始人吕骋表示,人不该为Agent改变思考方式,OS3以持续对话、最多连接五台电脑并支持自带模型密钥和本地执行来降低门槛,但个人Agent的长期需求仍待验证。
来自主题: AI资讯
9133 点击    2026-10-06 14:37
点头、抢话、会脸红,一半人分辨不出这是位「AI 小姐姐」

点头、抢话、会脸红,一半人分辨不出这是位「AI 小姐姐」

点头、抢话、会脸红,一半人分辨不出这是位「AI 小姐姐」

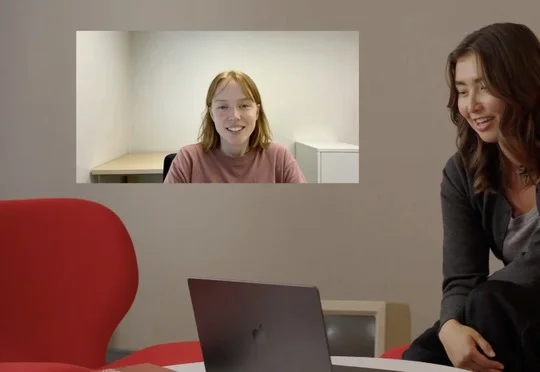
Tavus发布全双工视频到视频交互模型Griffin,可实时生成720p数字人并理解停顿、表情与动作,在一分钟测试中让54名参与者近48%误以为在与人交谈,但该结果未独立验证且模型尚未公开。
来自主题: AI资讯
8955 点击    2026-10-06 14:36
他们的新工作,是教 AI 取代自己

他们的新工作,是教 AI 取代自己

他们的新工作,是教 AI 取代自己

《The Verge》报道,Mercor、Scale AI 和 Surge AI 招募律师、编剧、教师等专业人士生产 AI 训练数据,使劳动者在教 AI 取代原有工作的同时,面临项目骤停、严密监控、降薪和技能被模型掌握后需求消失的困境。
来自主题: AI资讯
10789 点击    2026-10-06 14:35
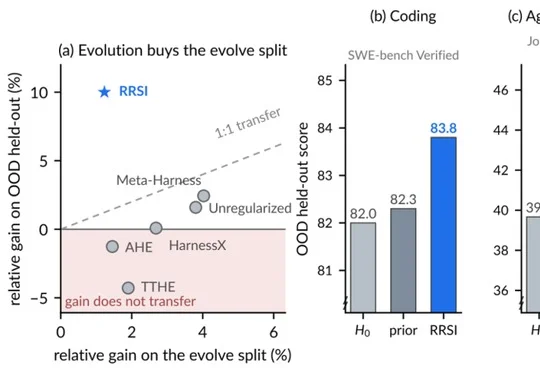
RSI火了,但自进化也会过拟合:Google等提出RRSI,给自进化施加正则化

RSI火了,但自进化也会过拟合:Google等提出RRSI,给自进化施加正则化

RSI火了,但自进化也会过拟合:Google等提出RRSI,给自进化施加正则化

Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
来自主题: AI技术研报
8830 点击    2026-10-06 13:54
Opus 5.5凭什么刷屏一周,看完这些爆款案例我悟了

Opus 5.5凭什么刷屏一周,看完这些爆款案例我悟了

Opus 5.5凭什么刷屏一周,看完这些爆款案例我悟了

Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
来自主题: AI资讯
10709 点击    2026-10-06 13:54
多场景新 SOTA!Ateve Jev 发布:让 AI 更会做选择!

多场景新 SOTA!Ateve Jev 发布:让 AI 更会做选择!

多场景新 SOTA!Ateve Jev 发布:让 AI 更会做选择!

Ateve 团队发布 AI 决策模型 Ateve Jev,首个版本 ateve-jev-v1 支持候选选择、是非判断和等级评分,并上线 TokenDance 平台。
来自主题: AI资讯
9774 点击    2026-10-05 23:54
Fable 5.5震撼首测:人类万年史浓缩进24小时!外网传疯了的3分钟神作

Fable 5.5震撼首测:人类万年史浓缩进24小时!外网传疯了的3分钟神作

Fable 5.5震撼首测:人类万年史浓缩进24小时!外网传疯了的3分钟神作

今天,外网被这个视频刷屏了。有人用Fable 5.5一键生成了一部「人类数万年进化史」,把整个人类历史压缩进了3分钟。整个过程,都是用纯代码写出,零视频素材,零版权音乐,没有使用任何视频生成模型。
来自主题: AI资讯
9457 点击    2026-10-05 23:53
AI,为什么总在画美女?

AI,为什么总在画美女?

AI,为什么总在画美女?

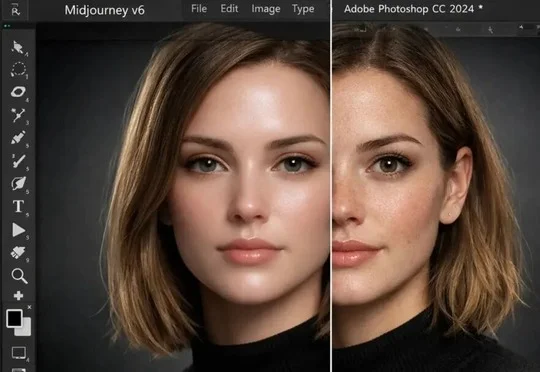
文章指出,AI常生成美女,是因为模型倾向生成接近数据分布中心的平均脸,而人类更偏爱平均脸,训练数据偏置、用户点击、奖励模型与商业激励进一步强化了这一反馈循环。
来自主题: AI资讯
10090 点击    2026-10-05 23:31
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

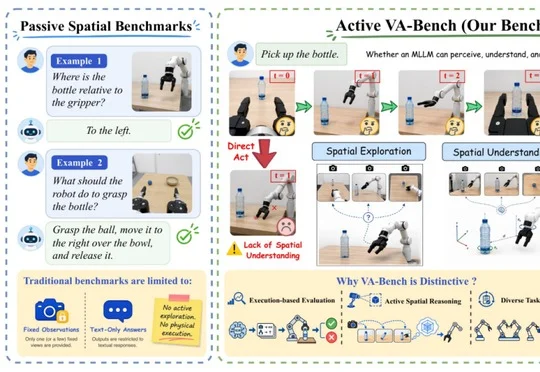
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。

来自主题: AI技术研报
9724 点击    2026-10-05 23:29