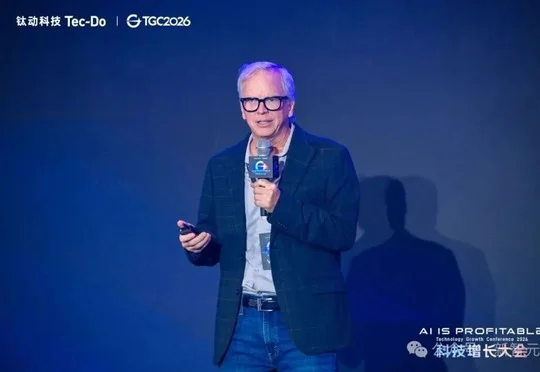
Transformer宗师空降中国!行业首个Pro Agent来了,中国队率先出手
Transformer宗师空降中国!行业首个Pro Agent来了,中国队率先出手钛动科技在广州TGC 2026科技增长大会发布行业首个Pro Agent Navos Pro,以专业、主动、盈利三项能力连接专业模型、数据与Agent Harness,推动AI for Work创造可衡量的商业回报。
来自主题: AI资讯
7658 点击 2026-10-24 13:45

 搜索
钛动科技在广州TGC 2026科技增长大会发布行业首个Pro Agent Navos Pro,以专业、主动、盈利三项能力连接专业模型、数据与Agent Harness,推动AI for Work创造可衡量的商业回报。
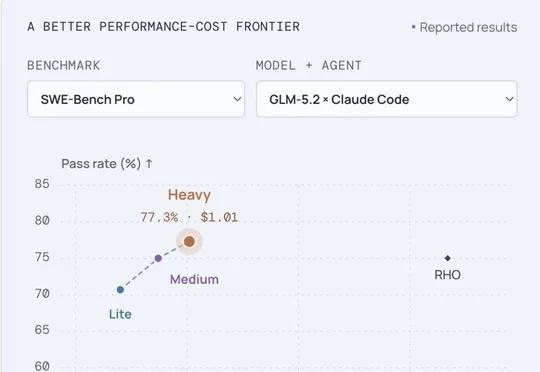
智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。
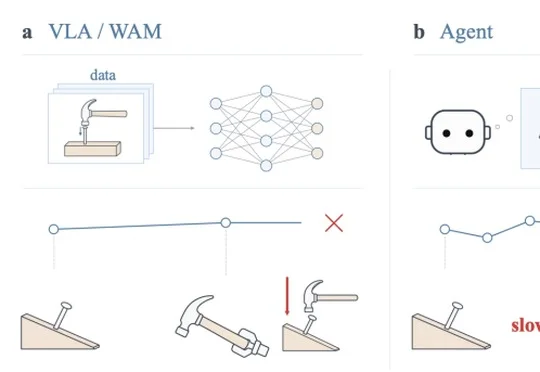
复旦大学可信具身智能研究院团队提出具身自进化框架RoboSkill,通过触觉反馈确认物理状态并积累、复用含代码的Skill,减少机器人Agent重复探索与推理,缩短任务执行时间。
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
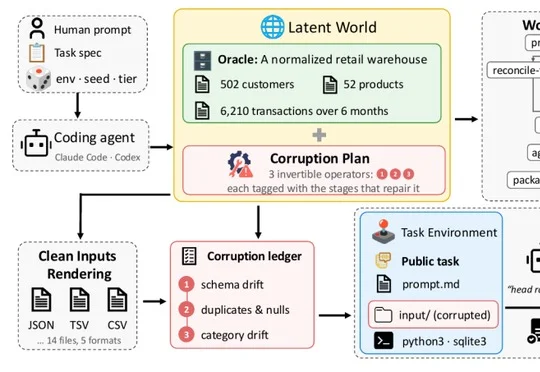
Adobe Research与UCLA提出Tev,构建含1170个环境、覆盖7个领域的Tev-Gym并提出进度势能奖励塑形(PPRS),训练出的Tev-27B在ALE-CM的Pass@5达0.28,与GPT-6 Astra、Claude Opus 5持平。
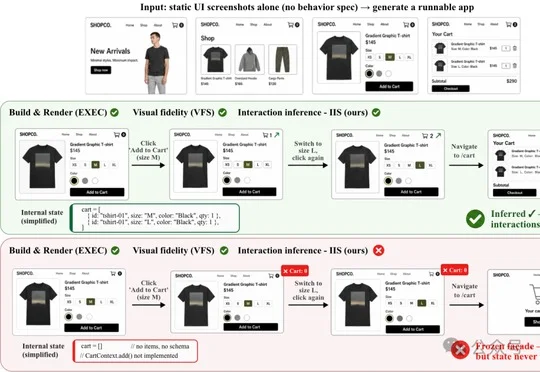
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
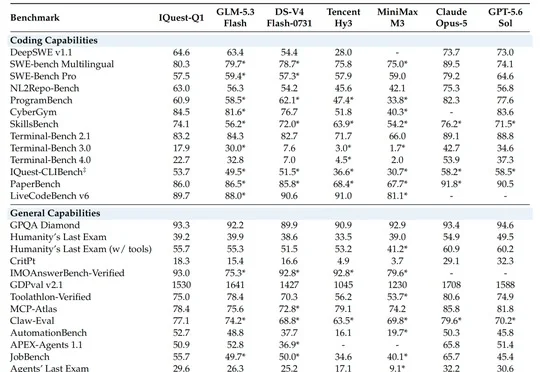
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
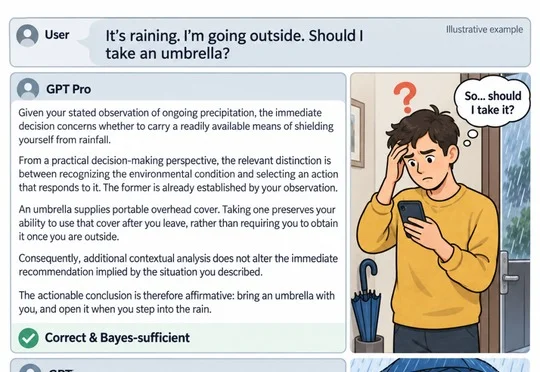
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
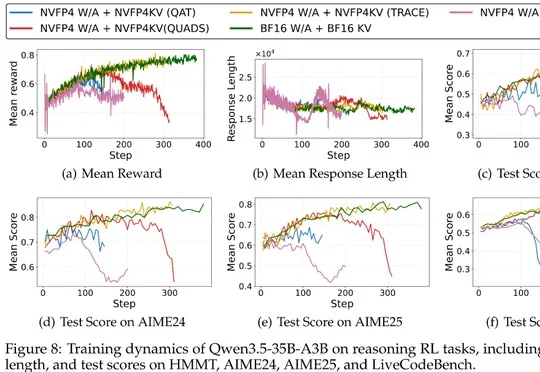
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
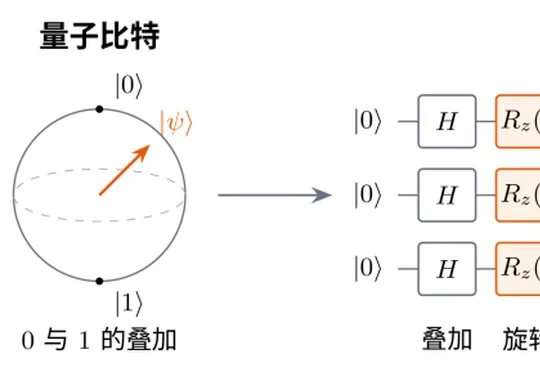
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。