LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式
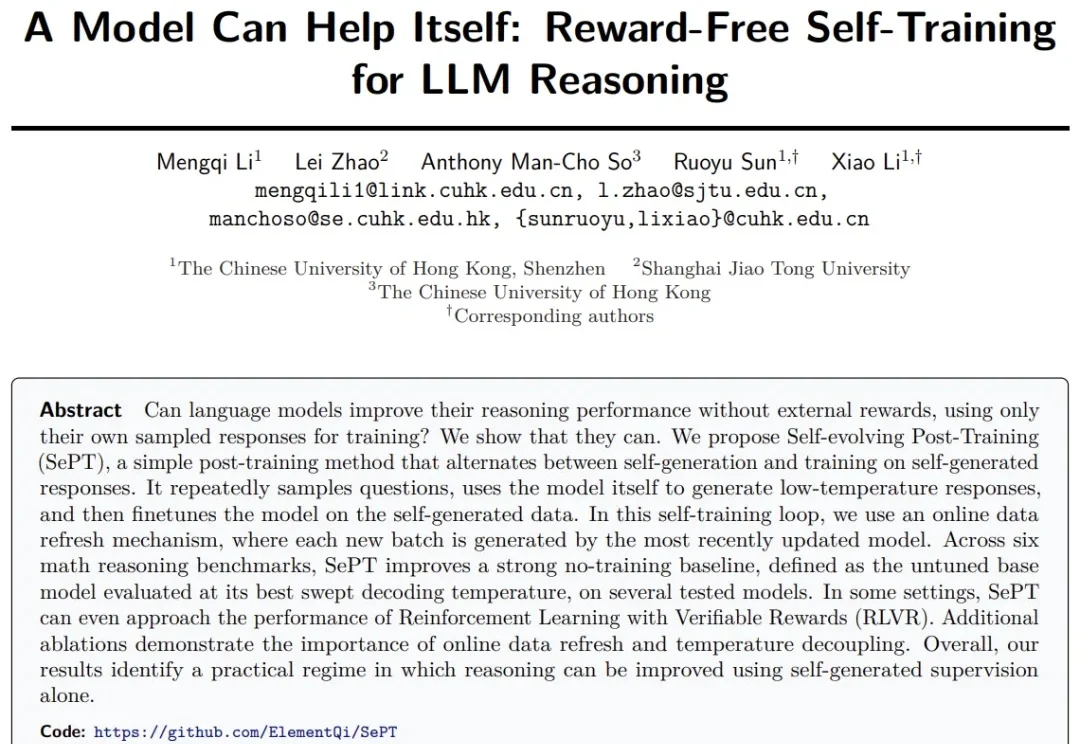
LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!
搜索
在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!
当 AI 智能体不再只是「一次性工具」,而是能够持续学习、自我进化的「数字伙伴『数字同事』,会发生什么?自进化智能体应该采取怎样的设计原则?
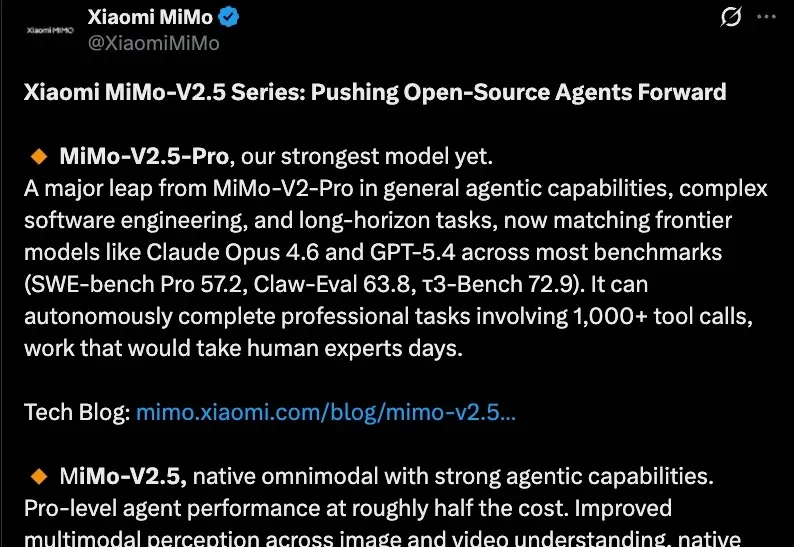
小米大模型时隔一月能力飙涨,比Kimi K2.6省42% Token。
NeoSigma 团队今天开源了一个叫 auto-harness 的系统,核心做的事只有一件:让智能体自己发现自己的 bug,自己修,自己验证。
“Claude 和许多模型在不需要太多诱导的情况下,就会陷入‘有某种东西是我,我感觉非常有意识’的这种状态。”
很少有人能意识到印奇只比杨植麟大4岁。两人都是从AI1.0时代开始创业,那时作为“AI四小龙”代表人物的印奇,名气远比杨植麟大。但到了以大模型为核心的AI2.0时代,印奇反而要追赶比他年轻的杨植麟。
千里科技的AI商业闭环,今天正式加速了
阿里前几天开源的Qwen3.6-35B-A3B,让这次讨论不再只是一次普通的新旧模型对比。它一边要面对谷歌Gemma4-26B-A4B的外部竞争,一边又必须回答一个更麻烦的问题:相较于 Qwen3.5-35B-A3B,它到底是升级,还是修补?更现实的是,很多人现在真正跑着的,其实是Qwen3.5-27B,那么这条新的35B-A3B路线,到底值不值得迁过去。
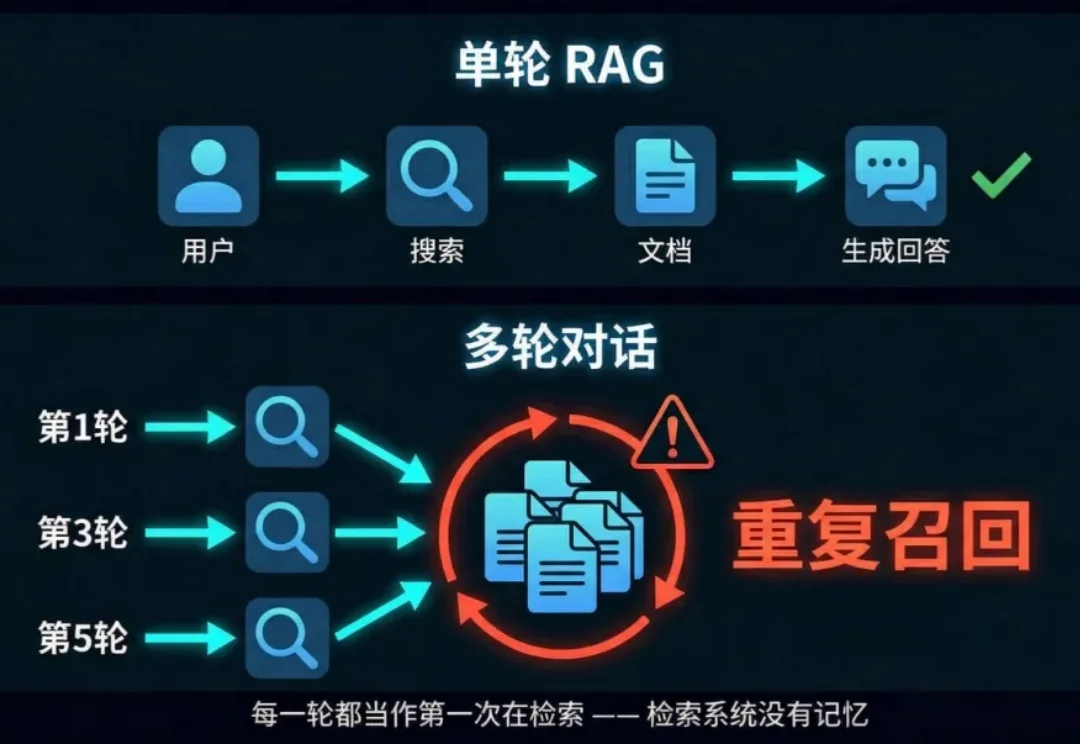
做 RAG 的团队,基本都会在多轮对话上吃过亏。
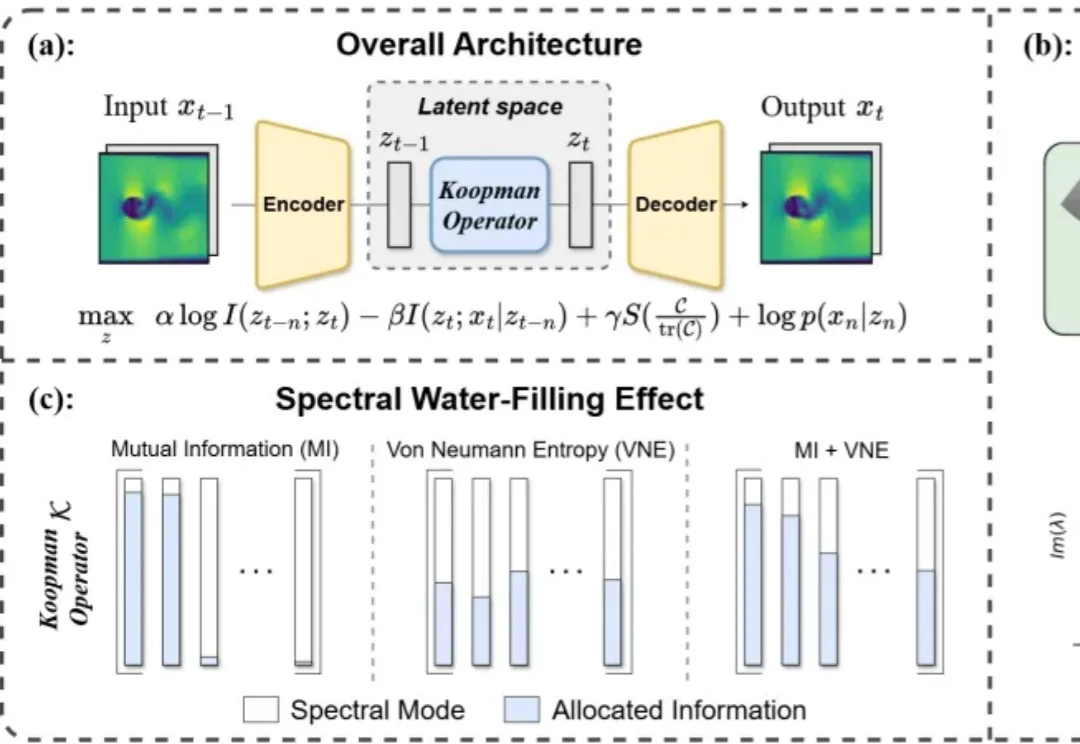
大多数世界模型工作默认:只要学到一个好的 latent dynamics,问题就解决了。 但这个假设本身是可疑的——什么样的信息,才足以支撑一个可预测、可传播的动力学? 本文从信息论出发,重新审视这一前提。