深度|RSI的下一场万亿机会,藏在AI还做不好的生意里
深度|RSI的下一场万亿机会,藏在AI还做不好的生意里RSI正在从长期的理论命题,逐步走向可验证的技术实践,硅谷新共识已经形成。以Anthropic和OpenAI为代表的全球头部模型公司,2026年9月,Anthropic披露,Claude已参与其超过80%的代码合并工作,OpenAI也明确将目标锚定为2028年3月前实现自动化AI研究员。
来自主题: AI资讯
7472 点击 2026-10-14 15:28

 搜索
RSI正在从长期的理论命题,逐步走向可验证的技术实践,硅谷新共识已经形成。以Anthropic和OpenAI为代表的全球头部模型公司,2026年9月,Anthropic披露,Claude已参与其超过80%的代码合并工作,OpenAI也明确将目标锚定为2028年3月前实现自动化AI研究员。
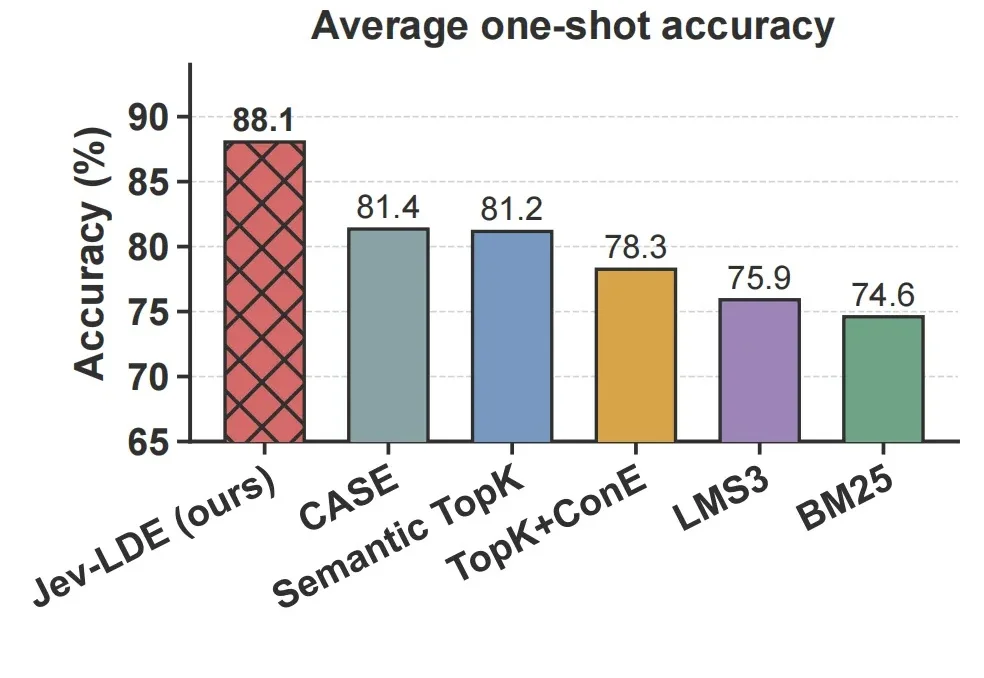
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
什么?35B的MoE,在手机上也能跑得很丝滑?
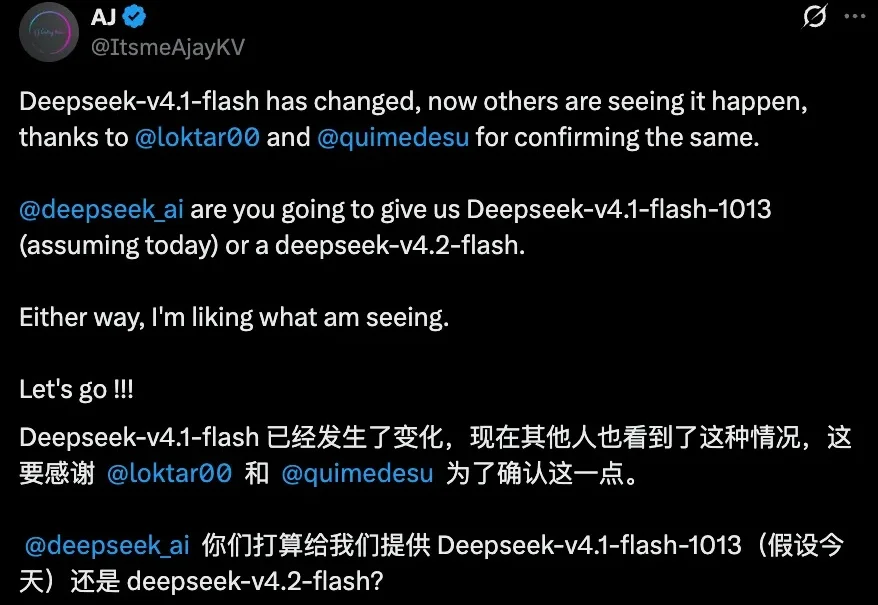
DeepSeek又悄么声更新模型了!
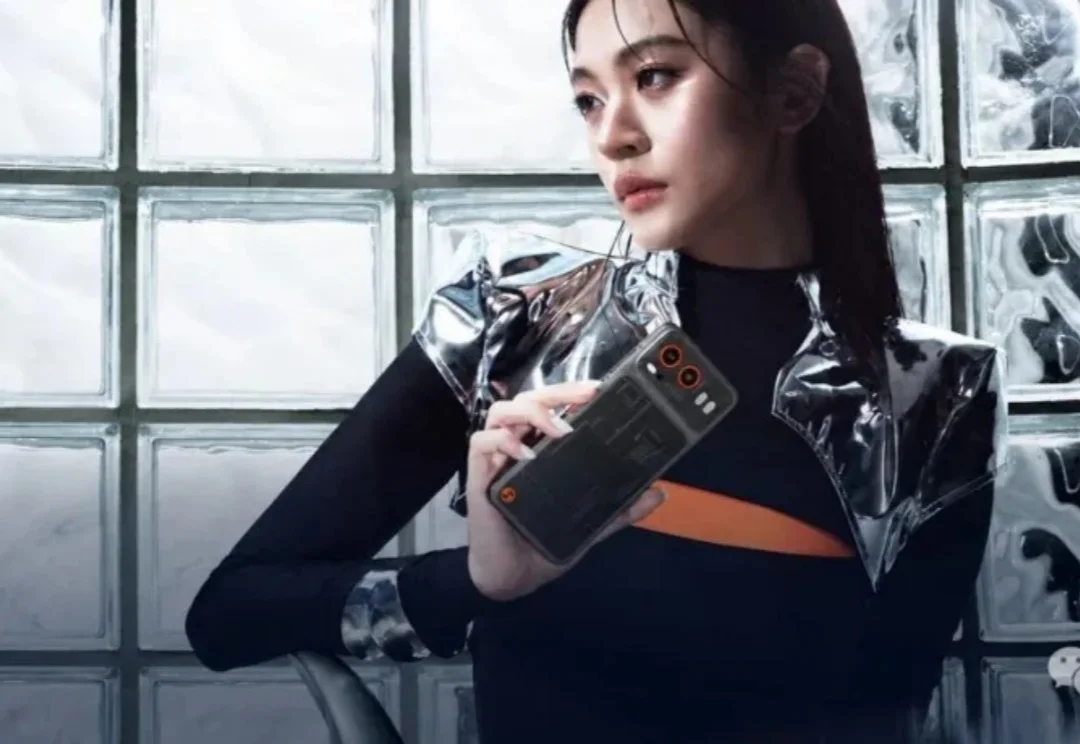
刚刚,上海。在一场叫「Ready Builder One」的发布会上—— STEPX Neo,全球首款大模型原生智能体手机,正式发布!
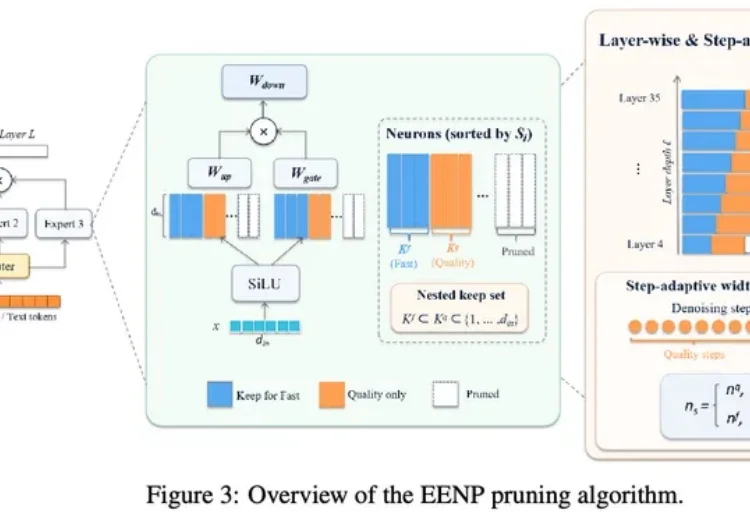
AI 视频越来越逼真,生成它的算力却并不便宜。复杂的动作、连贯的镜头和细腻的画面,背后都需要大量计算。一旦进入批量制作,反复生成、修改和重试的开销便会累积,成为创作者与视频平台必须考虑的成本。
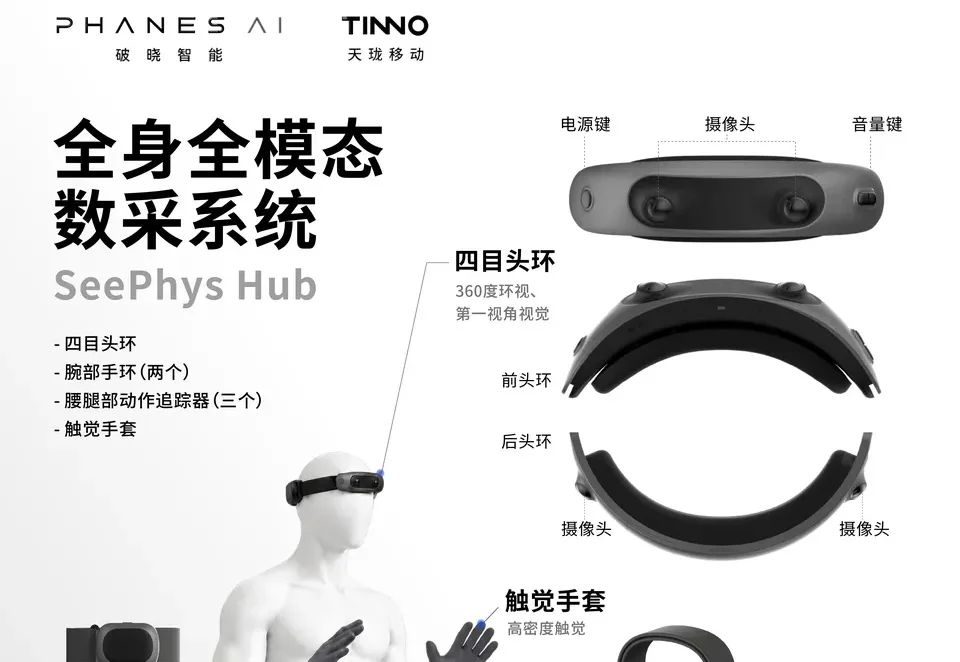
数据越采越多,机器人就能越来越会干活吗?
事情大家都知道了,田柯宇昨天一炒作,一堆人联合出来打假田神,不仅列时间线、列代码、还列上了自己的Github主页,搞学术的就是严谨啊👇 https://keyu-tian-sabotage.github.io
OpenAI正与一家影视制作AI视频初创公司洽谈,拟向其开放已关停的Sora模型使用权并针对影视制作深度定制,若达成协议,OpenAI将获得该公司部分股权。
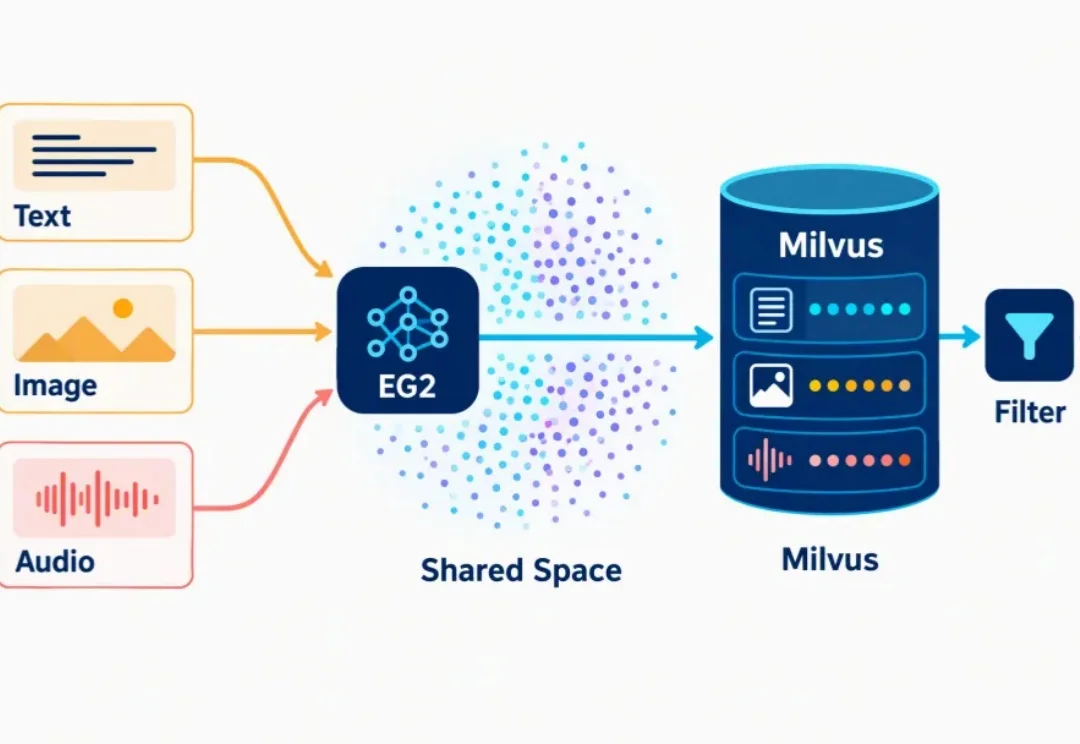
传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。