新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分
新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
来自主题: AI资讯
8409 点击 2026-10-18 13:02

 搜索
Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
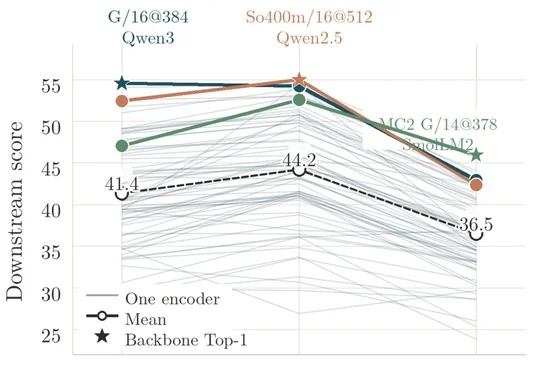
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
StartLux发布StartLux-Decision新版本,推出Instant与AutoThink双模型矩阵及原创RLCD²,在Decision Index 0.3和DecisionPivot评测中领先多款模型,并公开模型权重与推理代码。
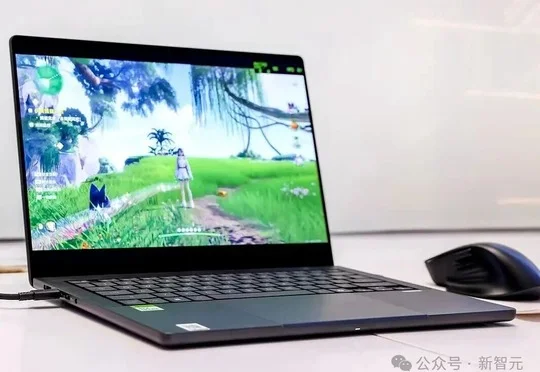
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
千问披露Agent训练框架QwenGyre,通过弹性调度和轨迹处理,将Qwen 3.8 2.4T的48步强化学习训练耗时从134.55小时降至75.42小时、效率提升78%,并计划优化后开源。
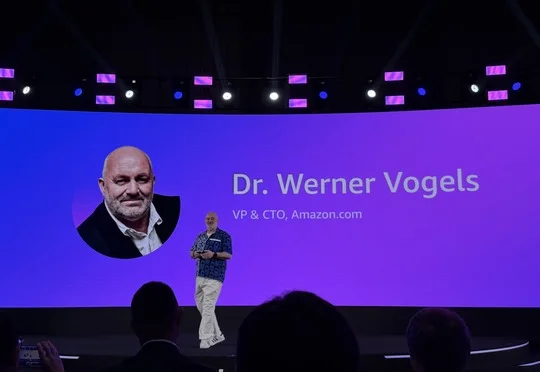
亚马逊CTO Werner Vogels在深圳表示,企业不应因担心错过AI转型窗口而仓促采用AI,而应先评估任务适配性、模型能力和成本,并以权限约束、结果验证及责任机制控制Agent风险。
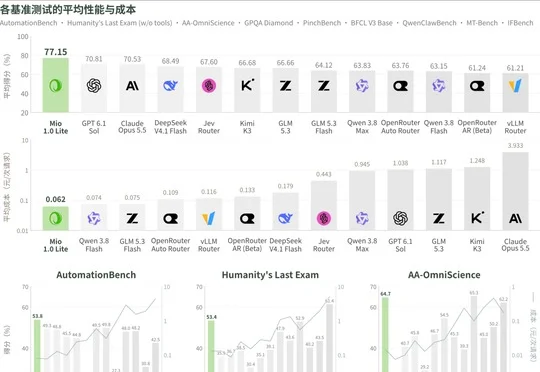
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
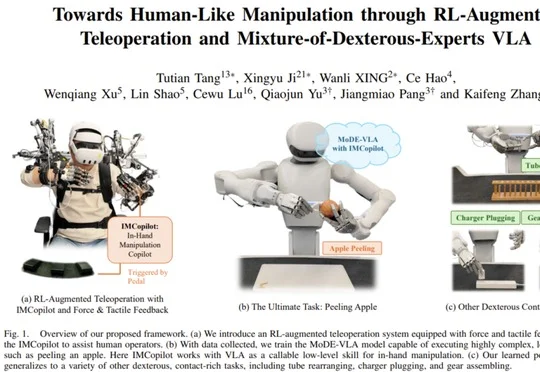
Sharpa以22自由度Sharpa Wave灵巧手为硬件平台,通过融合人类与遥操作数据、解耦运动与接触控制及开展触觉跨本体学习,系统推进灵巧操作的数据、模型与硬件协同研究。