AI资讯新闻榜单内容搜索-向量

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 向量
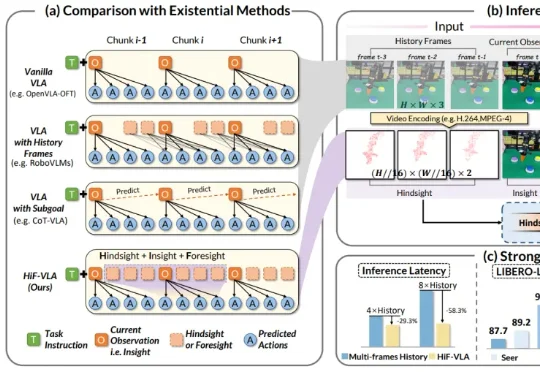
CVPR 2026 | 突破短视,理解变化!HiF-VLA:以motion为中心打造「边想边做」的世界动作模型

CVPR 2026 | 突破短视,理解变化!HiF-VLA:以motion为中心打造「边想边做」的世界动作模型

CVPR 2026 | 突破短视,理解变化!HiF-VLA:以motion为中心打造「边想边做」的世界动作模型

来自西湖大学、浙江大学、西湖机器人等机构的研究团队提出了一种以运动(Motion)为中心的全新双向时空推理框架 HiF-VLA。抛弃冗余的像素级输入,HiF-VLA 巧妙提取低维紧凑的 Motion 向量作为动态先验,在一个创新的「联合专家」模块中,同步完成未来视觉运动的预测与高精度动作序列的生成。

来自主题: AI技术研报
10709 点击    2026-05-23 09:55
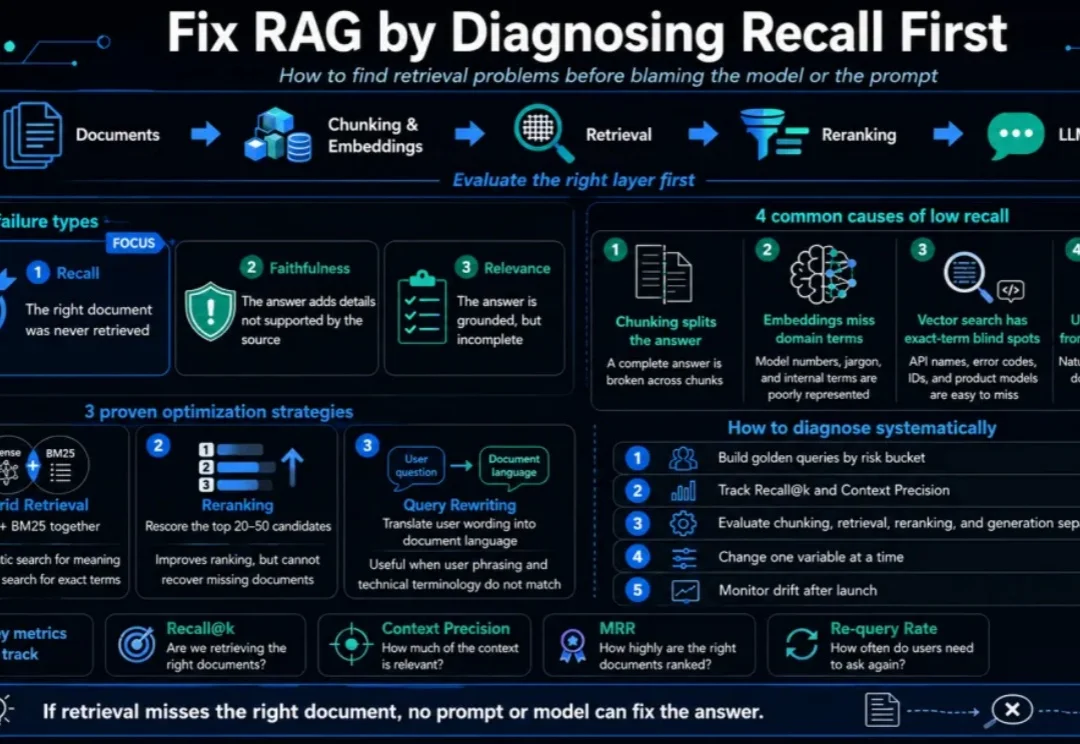
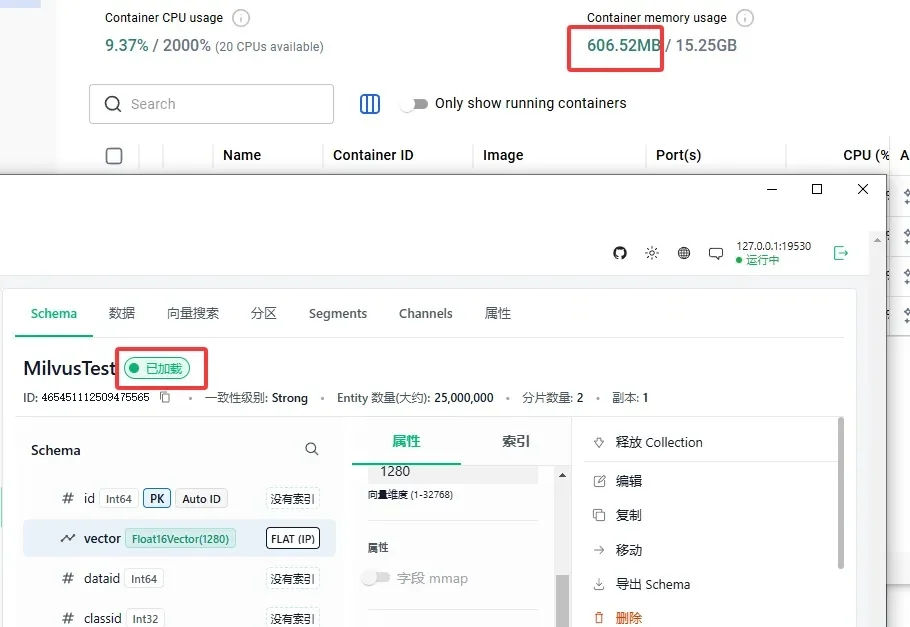
RAG效果不理想,怎么优化?Recall太低,是Milvus的问题吗?

RAG效果不理想,怎么优化?Recall太低,是Milvus的问题吗?

RAG效果不理想,怎么优化?Recall太低,是Milvus的问题吗?

RAG 系统上线后答案出错,绝大多数团队的第一反应都是换更贵的模型、反复调试 prompt。

来自主题: AI技术研报
9885 点击    2026-05-20 15:13
jina-embeddings-v5-omni 发布!全模态向量小模型

jina-embeddings-v5-omni 发布!全模态向量小模型

jina-embeddings-v5-omni 发布!全模态向量小模型

jina-embeddings-v5-omni正式发布,我们把 v5-text 向量模型的能力延伸到图像、音频和视频。文本侧不变,v5-omni 产出的文本向量与 v5-text逐字节一致,无需重建任何已有索引。

来自主题: AI资讯
10142 点击    2026-05-14 20:31
Google放大招:文字、图片、视频、音频、PDF,全部压进同一个向量空间!Gemini Embedding 2正式GA

Google放大招:文字、图片、视频、音频、PDF,全部压进同一个向量空间!Gemini Embedding 2正式GA

Google放大招:文字、图片、视频、音频、PDF,全部压进同一个向量空间!Gemini Embedding 2正式GA

Google悄悄干了一件大事——Gemini Embedding 2正式进入GA阶段,成为Gemini API中第一个原生多模态embedding模型。它能把文本、图片、视频、音频、PDF文档全部映射进同一个统一向量空间,支持100多种语言。

来自主题: AI资讯
11612 点击    2026-05-02 15:05
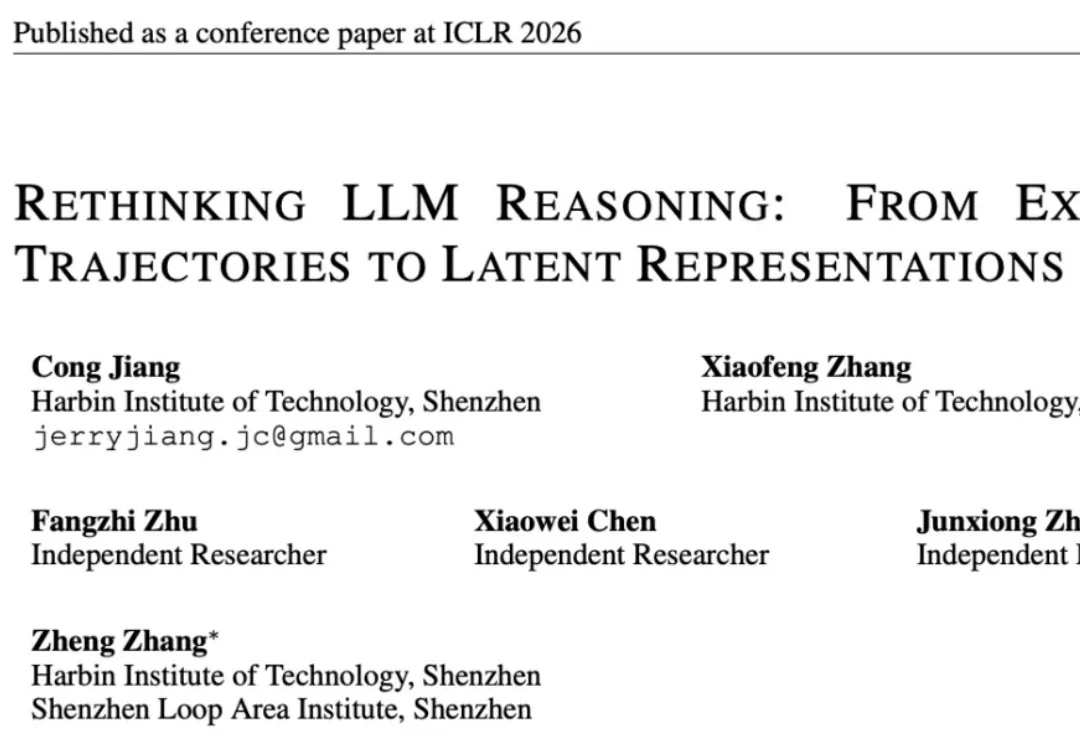
ICLR 2026|隐式思考模型LRT:「隐式思维链」推理,更快更强!

ICLR 2026|隐式思考模型LRT:「隐式思维链」推理,更快更强!

ICLR 2026|隐式思考模型LRT:「隐式思维链」推理,更快更强!

近日,哈尔滨工业大学(深圳)联合深圳河套学院、Independent Researcher提出了隐式思考模型 LRT(Latent Reasoning Tuning),通过一个轻量级的推理网络,将大模型冗长的「思维链」压缩为紧凑的隐式向量表征,一次前向计算即可完成推理,无需逐 token 生成数千字的中间推理过程。

来自主题: AI技术研报
11150 点击    2026-04-13 09:35