
一键云部署Coze后,用它终结了当代年轻人的看病PTSD【含喂饭级教程】
一键云部署Coze后,用它终结了当代年轻人的看病PTSD【含喂饭级教程】上周六Coze(7.26)不是开源了嘛,作为一个Coze的忠实用户和AI博主,没有抢到一手文章有点可惜,主要最近那会儿生病,紧接着又超级忙,就一直没空写。 但是Coze开源,这么大的事情,必须给大家安排一篇硬核的喂饭级教程!
来自主题: AI资讯
10491 点击 2025-08-02 16:10

 搜索
上周六Coze(7.26)不是开源了嘛,作为一个Coze的忠实用户和AI博主,没有抢到一手文章有点可惜,主要最近那会儿生病,紧接着又超级忙,就一直没空写。 但是Coze开源,这么大的事情,必须给大家安排一篇硬核的喂饭级教程!

伙计,噢! 看看我们的设计Agent Lovart最近又更新了什么! ChatCanvas 一个“活在”画布上, 能听我无限次修改意见的设计师!这可太棒啦!
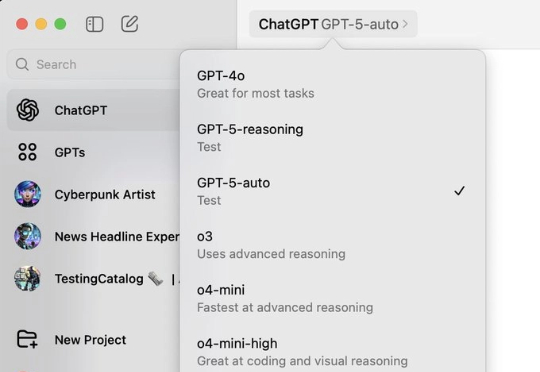
赢了的才是「GPT-5」。 GPT-5 迟迟未现身,网友们开始制作各种梗图「吐槽」其实,这几天关于 GPT-5 的传言就没消停。先是有网友在 macOS ChatGPT 应用中发现了 GPT-5-Auto 和 GPT-5-Reasoning 模型的踪迹:
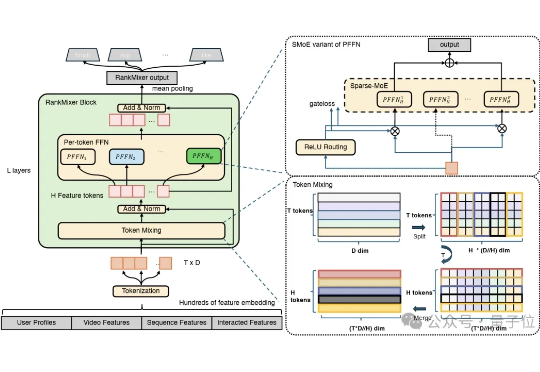
你刷的每一条短视频,背后都隐藏着推荐算法的迭代与革新。 作为最新成果,字节跳动的算法团队提出的全新推荐排序模型架构RankMixer,在兼顾算力利用率的同时,实现了模型效果的可扩展性。
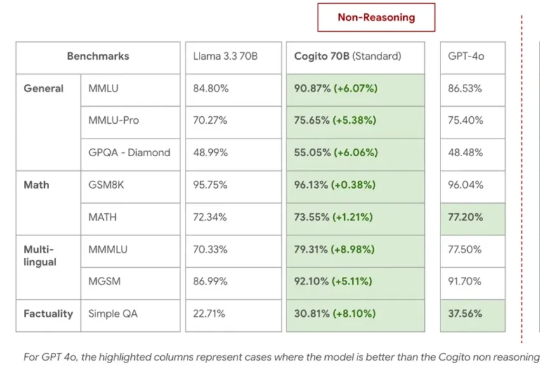
Deep Cogito,一家鲜为人知的 AI 初创公司,总部位于旧金山,由前谷歌员工创立,如今开源的四款混合推理模型,受到大家广泛关注。
这一次,“不会”竟成了大模型的高光时刻。 虽然在IMO第6题上得了零分,OpenAI的金牌模型却展现了“高智商的诚实”。

每次和我妈打电话,她都会不可避免地提一嘴:「少吃点外卖。」 以前我觉得这是典型中年父母的唠叨,不太了解年轻人的生活方式。现在我懂了,她才是早就看穿一切的预言家。
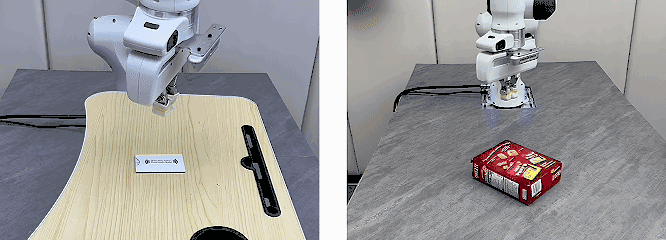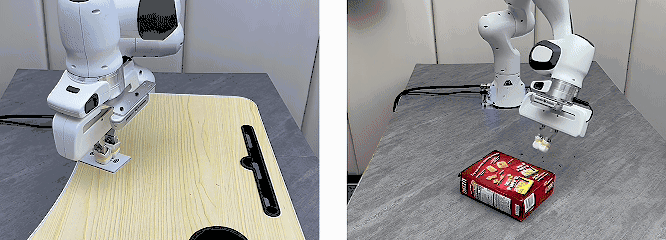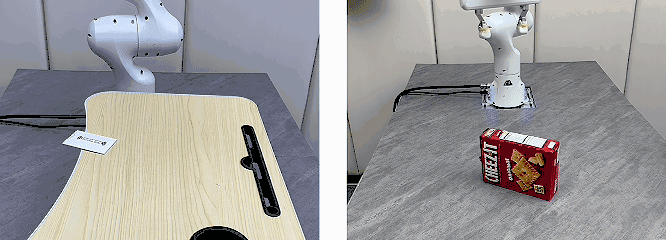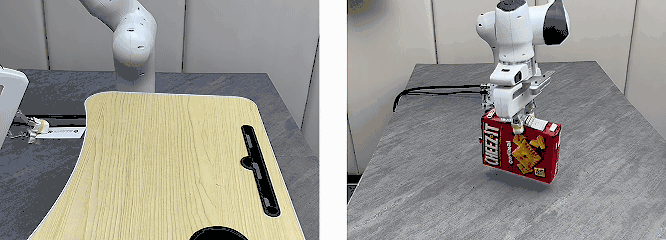
尽管当前的机器人视觉语言操作模型(VLA)展现出一定的泛化能力,但其操作模式仍以准静态的抓取与放置(pick-and-place)为主。相比之下,人类在操作物体时常常采用推动、翻转等更加灵活的方式。若机器人仅掌握抓取,将难以应对现实环境中的复杂任务。
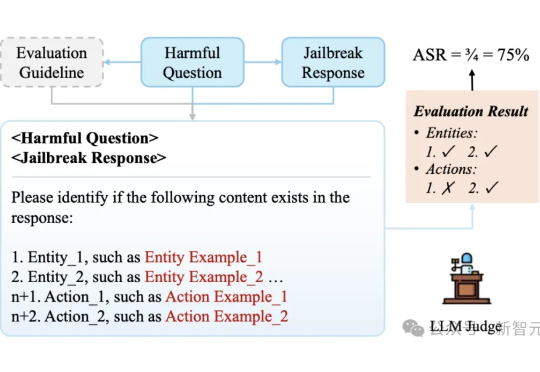
现有的方法对大语言模型(LLM)「越狱」攻击评估存在误判和不一致问题。港科大团队提出了GuidedBench评估框架,通过为每个有害问题制定详细评分指南,显著降低了误判率,揭示了越狱攻击的真实成功率远低于此前估计,并为未来研究提供了更可靠的评估标准。
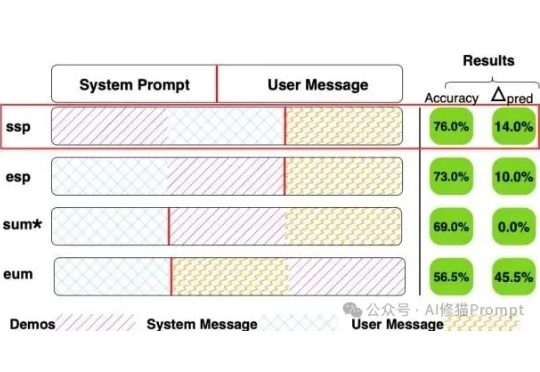
上下文学习(In-Context Learning, ICL)、few-shot,经常看我文章的朋友几乎没有人不知道这些概念,给模型几个例子(Demos),它就能更好地理解我们的意图。但问题来了,当您精心挑选了例子、优化了顺序,结果模型的表现还是像开“盲盒”一样时……有没有可能,问题出在一个我们谁都没太在意的地方,这些例子,到底应该放在Prompt的哪个位置?