深度拆解华为最新报告:物理智能规模化,为什么偏偏卡在“协同”上?
深度拆解华为最新报告:物理智能规模化,为什么偏偏卡在“协同”上?单点智能撑不起物理世界,华为报告指向系统进化。 作者 | 王涵 编辑 | 漠影 2026年,资本正在为AI走进物理世界疯狂下注。 IT桔子数据显示,截至5月11日,国内具身智能领域今年已披露投资218
来自主题: AI资讯
9009 点击 2026-09-28 09:48

 搜索
单点智能撑不起物理世界,华为报告指向系统进化。 作者 | 王涵 编辑 | 漠影 2026年,资本正在为AI走进物理世界疯狂下注。 IT桔子数据显示,截至5月11日,国内具身智能领域今年已披露投资218
Claude推出绑定GitHub即可领取限时云端额度的福利后,多名通过非官方渠道使用的国内用户在领取后不久因违反支持地区政策被封号,被网友调侃为"A社钓鱼执法"。
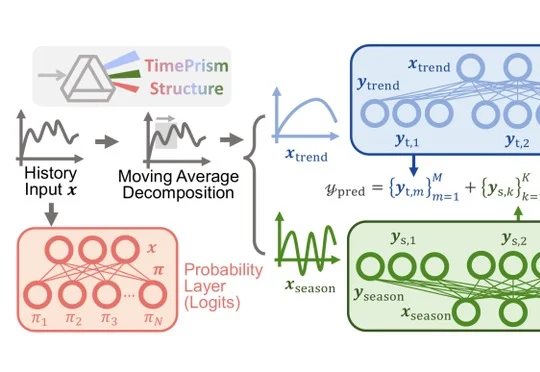
Jev刷屏之际,香港中文大学徐强团队早在12个月前就发表了论文《From Samples to Scenarios》并提出TimePrism验证模型,两者在不同领域分别走向了"显式概率、并行输出、面向决策"的相似设计思路。
OpenAI Codex负责人Tibo Sottiaux在访谈中详述了Codex从内部Python智能体演进为顶级编程助手的历程,并解释了选择Rust构建核心智能体、从一开始就开源CLI和SDK、不绑定自家模型等关键工程决策背后的考量,指出Codex的终极目标是打造易用的个人AGI。
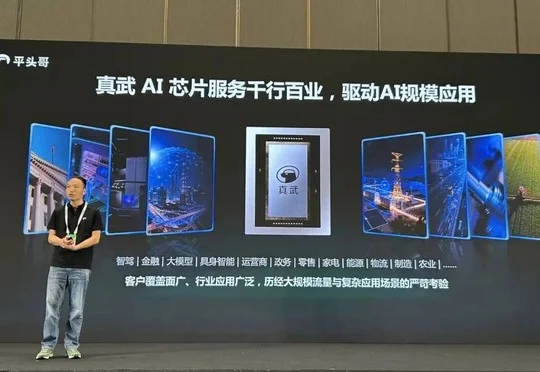
henry 发自 凹非寺 量子位 | 公众号 QbitAI “这是目前中国算力性能最强的AI芯片,性能达到M890的3倍。” 9月22日的云栖大会上,阿里巴巴集团CEO吴泳铭这样介绍新一代真武V900
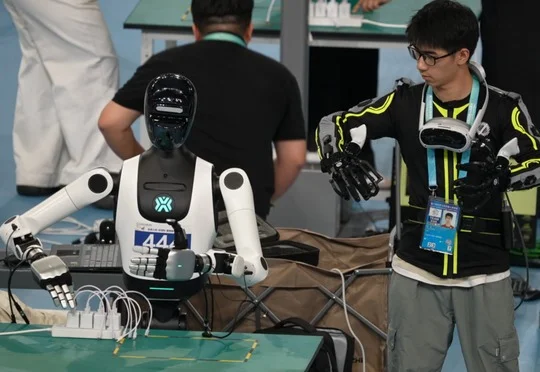
灵巧操作的最高境界,是「无剑胜有剑」。 作者丨向欣 高景辉 编辑丨高景辉 金庸笔下的独孤求败,对剑术的理解有几重境界:二十岁前看重利剑凌厉刚猛,四十岁前领悟重剑「大巧不工」;四十岁后渐渐达到「不滞于物
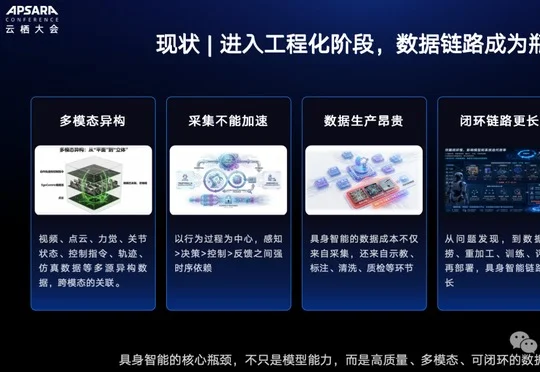
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
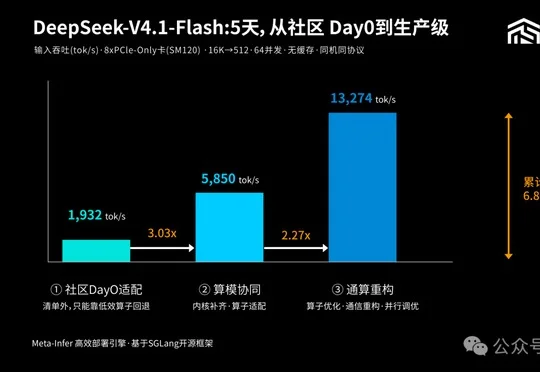
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
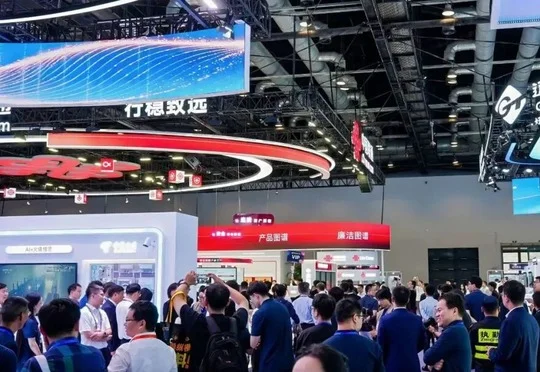
最近这几天,北京国家会议中心门口总是排起长队。 我刷码进场的时候,旁边两个穿格子衫的年轻人正在讨论今天先去哪边: 一个说先去E区看看机器人,另一个说C区有个安全路演,得早点过去占位置。 这是我第三次来
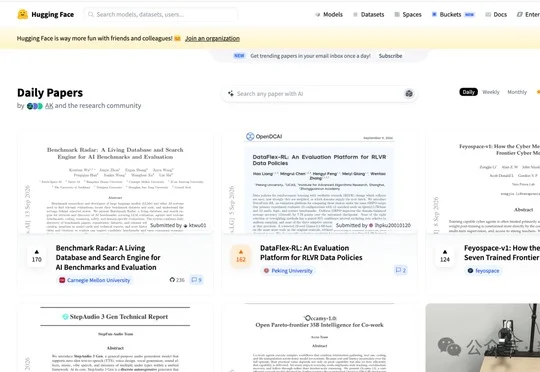
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。