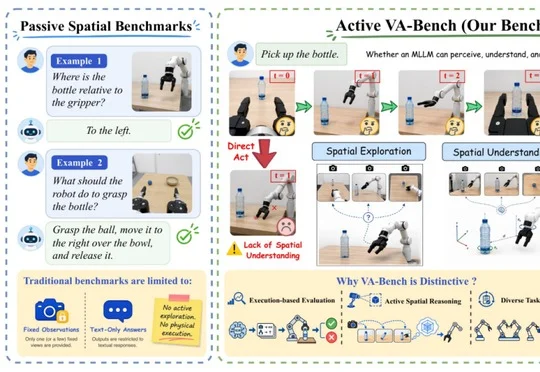
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9723 点击 2026-10-05 23:29

 搜索
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
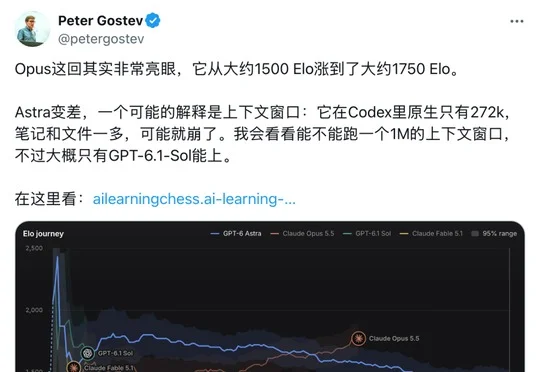
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
Harvey联合创始人Gabe Pereyra表示,AI应用公司不必与大模型公司比拼资金和算力,可借助真实任务评测、领域专家、开源模型和外部研究团队建立持续学习能力。
UC Berkeley教授宋晓冬带领的Virtue AI团队于今年6月加入Meta超级智能实验室,仅4个月后便因"工作风格不合"被曝遭裁减,合作疑似终止。
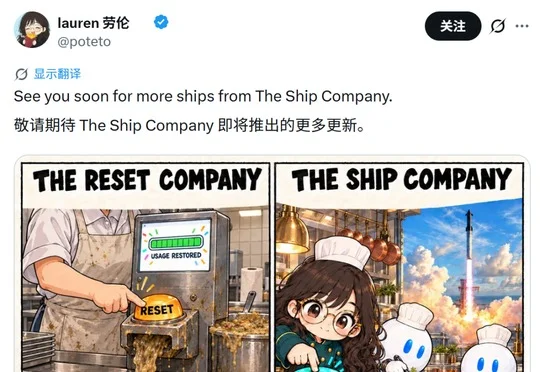
OpenAI在开发者日后因GPT-6.1 Sol实际体验不及预期、使用额度收紧等问题遭遇用户信任危机,Tibo承诺未来将进行连续28天发布或重置,并将简化产品、提高效率作为核心方向,以兑现此前过度宣传的承诺。
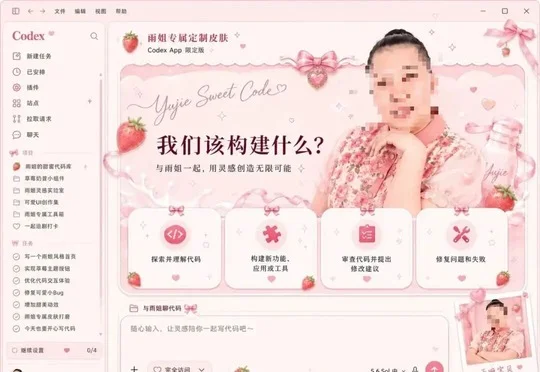
如果你妄图通过 Claude 执行 rm -rf node_modules 守护一方安宁的雨姐就会把你拦下:“整这死出呢?这命令不好使!想都别想” 然后面板里“拦下”那一栏记了 +1 Claude 要
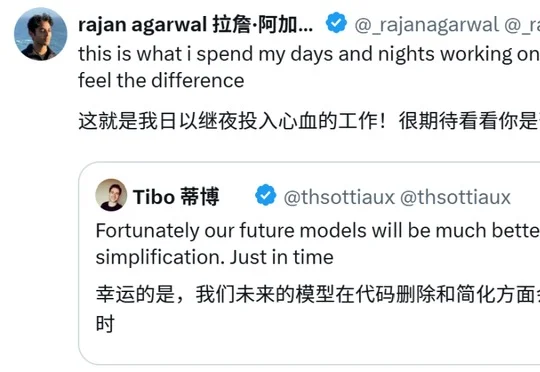
OpenAI 开发者日才过去了 5 天,Tibo 又来预告下一代模型了。这一次,他们终于打算管管模型写出来的屎山代码了。不久前,OpenAI 产品负责人 Tibo Sottiaux 发帖称,未来的模型会更擅长删除和简化代码。
作者测试了豆包、元宝、千问、小红书点点、美团问小团、Claude及Meta的Muse等多款AI工具在制作福建七日国庆旅游攻略中的表现,发现当前通用AI助手和热门的Personal Agent虽能快速生成看似完整的行程,却普遍缺乏对用户个性化偏好的深度理解、长期记忆和多源信息整合能力,无法真正像人一样做出可执行的旅游攻略。
闻乐 发自 凹非寺 量子位 | 公众号 QbitAI DeepSeek又开始捞人了。 弹性计算团队大量HC招人!尤其需要资深工程师。 三周前不是刚招过一轮吗?咋又缺人了。 这次没发岗位JD,直接甩了一
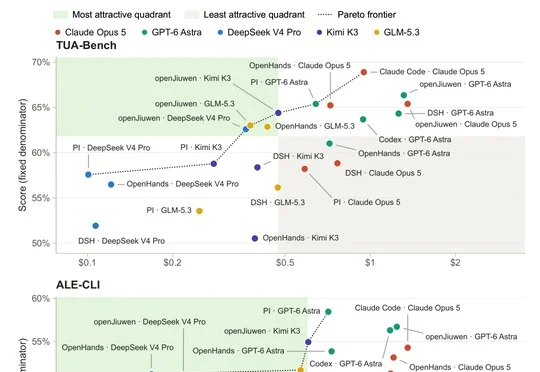
南洋理工大学安波团队最新研究指出,Agent Harness的选型应将模型、Harness与任务作为完整配置联合评估,不同任务下最佳组合会变化,原生搭配也未必优于其他可配置Harness。