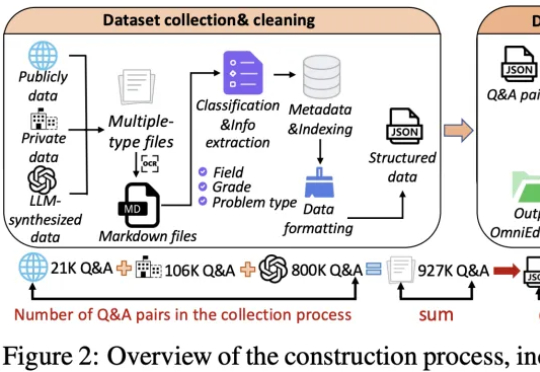
GPT-4o准确率仅为24%!权威中文教育基准:知识+情商的双重考验
GPT-4o准确率仅为24%!权威中文教育基准:知识+情商的双重考验华东师范大学智能教育学院发布OmniEduBench,首次从「知识+育人」双维度评测大模型教育能力。测评2.4万道中文题后,实验结果显示:GPT-4o等顶尖AI会做题,却在启发思维、情感支持等育人能力上远不及人类,暴露AI当老师的关键短板。
来自主题: AI技术研报
9256 点击 2025-11-15 10:15

 搜索
华东师范大学智能教育学院发布OmniEduBench,首次从「知识+育人」双维度评测大模型教育能力。测评2.4万道中文题后,实验结果显示:GPT-4o等顶尖AI会做题,却在启发思维、情感支持等育人能力上远不及人类,暴露AI当老师的关键短板。
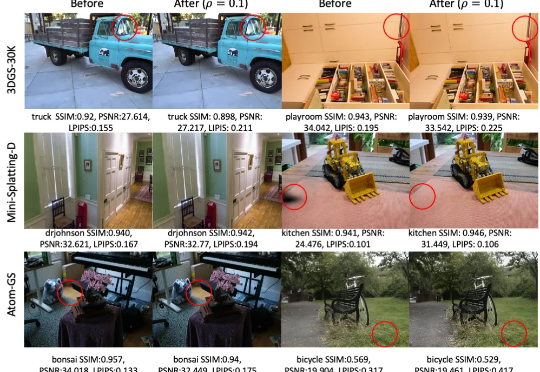
在三维视觉领域,3D Gaussian Splatting (3DGS) 是近年来大热的三维场景建模方法。它通过成千上万的高斯球在空间中“泼洒”,拼合成一个高质量的三维世界,就像是把一片空白的舞台,用彩色的光斑和粒子逐渐铺满,最后呈现出一幅立体的画卷。
刚刚,在理解大模型复杂行为的道路上,OpenAI又迈出了关键一步。他们从自己训练出来的稀疏模型里,发现存在结构小而清晰、既可理解又能完成任务的电路(这里的电路,指神经网络内部一组协同工作的特征与连接模式,是AI可解释性研究的一个术语)。
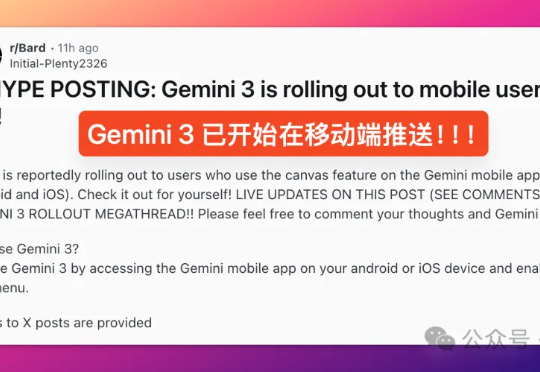
社区炸了,却不是因为 GPT-5.1。 而是你们心心念念的:Gemini 3。 几小时前,有网友发现在 Gemini 移动端的 Canvas 功能里,虽然显示的还是 Gemini 2.5 Pro,但输出效果已经完全提升了一个档次。

仅用两年时间,一个从实验室孕育的AI编程神器Cursor,年度经常性收入破10亿美元,冲刺300亿美元估值。新一轮23亿美元融资中,谷歌、英伟达重金押注。四名MIT本科辍学生,如今已是妥妥的亿万富翁。
如果一个AI,像人类一样看屏幕、敲键鼠、自己练级变强,这种游戏搭子,你愿意拥有吗?可能不久将来,类似王者荣耀、DOTA 2这样的游戏就可以选择和AI组队,而不是和人组队了!
一篇入围顶会NeurIPS’25 Oral的论文,狠狠反击了一把DiT(Diffusion Transformer)。这篇来自字节跳动商业化技术团队的论文,则是提出了一个名叫InfinityStar的方法,一举兼得了视频生成的质量和效率,为视频生成方法探索更多可能的路径。
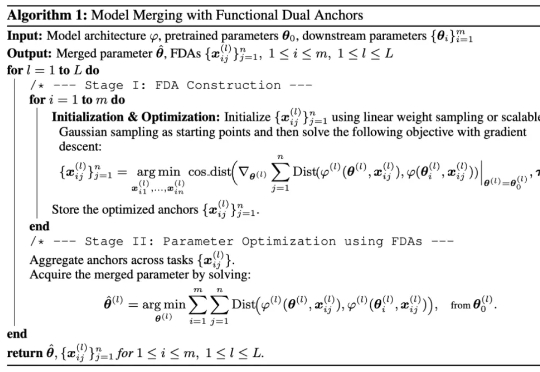
研究者们提出了 FDA(Model Merging with Functional Dual Anchors)——一个全新的模型融合框架。与传统的参数空间操作不同,FDA 将专家模型的参数知识投射到输入-表征空间中的合成锚点,通过功能对偶的方式实现更高效的知识整合。
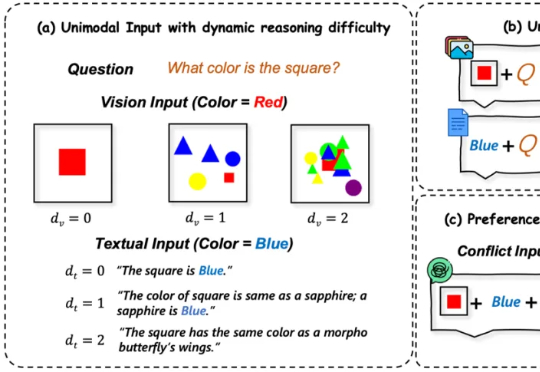
多模态大语言模型(MLLMs)在处理来自图像和文本等多种来源的信息时能力强大 。 然而,一个关键挑战随之而来:当这些模态呈现相互冲突的信息时(例如,图像显示一辆蓝色汽车,而文本描述它为红色),MLLM必须解决这种冲突 。模型最终输出与某一模态信息保持一致的行为,称之为“模态跟随”(modality following)
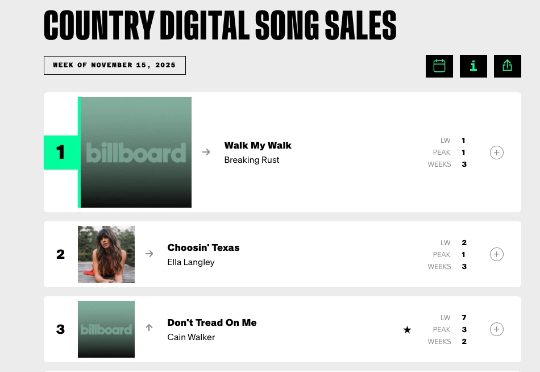
无人注意的角落里,权威榜单 Billboard 接二连三地迎来一批新歌手上榜,低调但行动快速,闷声就登顶了。权威音乐榜单 Billboard 旗下的乡村音乐排名榜,最新首位《Walk My Walk》,是一首 AI 生成的歌曲作品,Breaking Rust 自然也是一位 AI 歌手。从数据来看,它不仅登顶了,还连续在榜了三周。对于任何一个新人来说,都是堪称「爆」了的成绩。