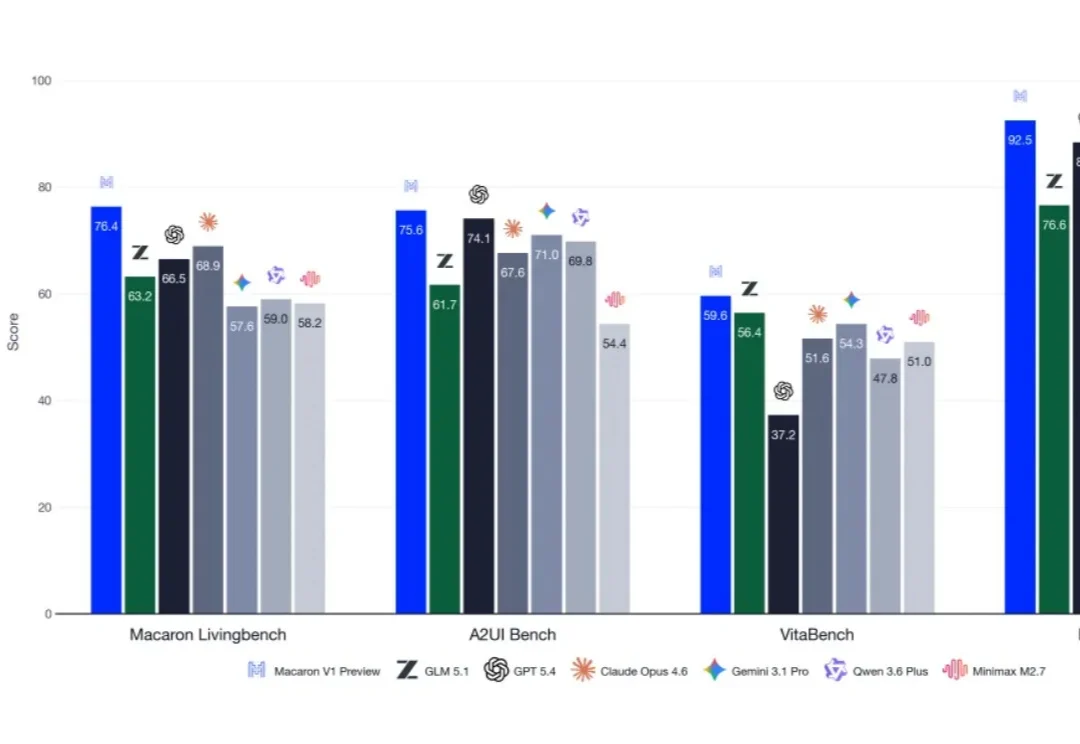
刚刚,Mind Lab开源V1系列模型Preview,749B参数,专为Agent 后训练
刚刚,Mind Lab开源V1系列模型Preview,749B参数,专为Agent 后训练过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
来自主题: AI技术研报
12515 点击 2026-06-08 15:29

 搜索
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
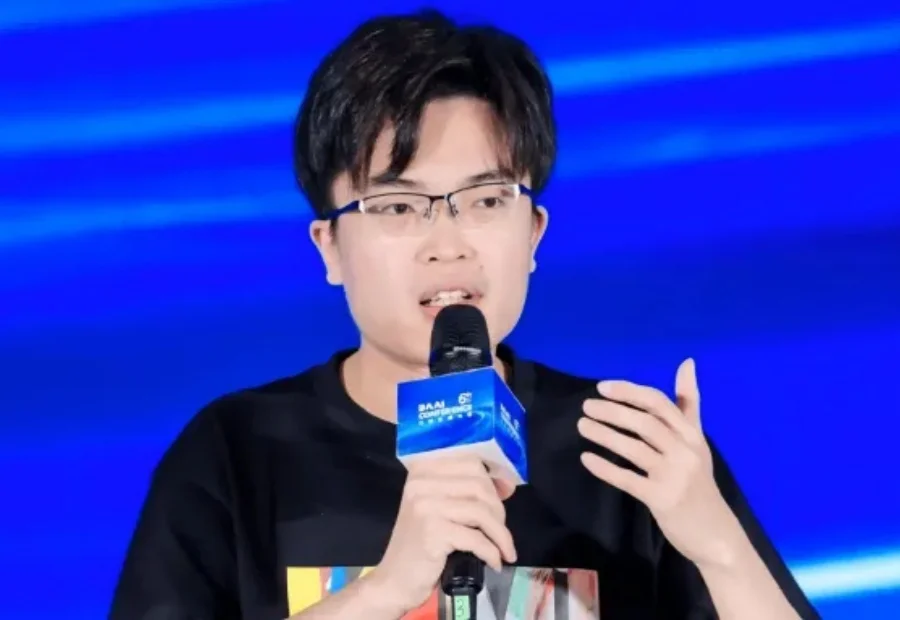
半年,估值实现6倍增长。
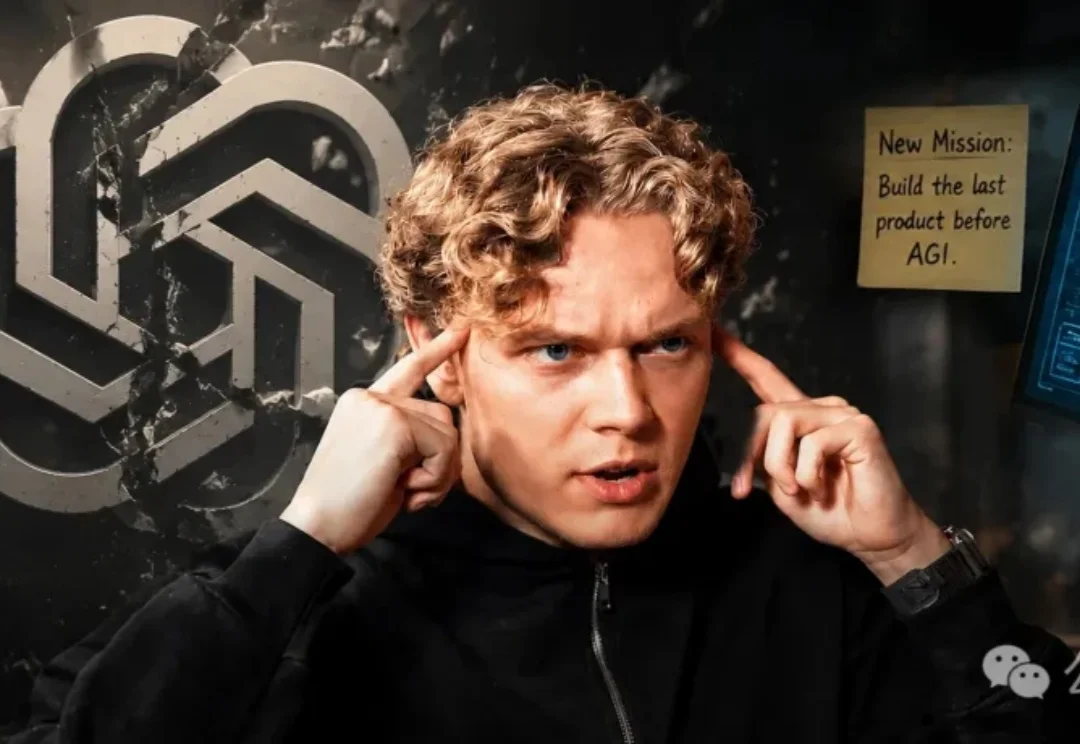
太突然了!Sora核心骨干、17岁高中辍学天才Gabriel正式官宣离开OpenAI。他要押上全部,打造AGI前夜的「最后一个产品」。
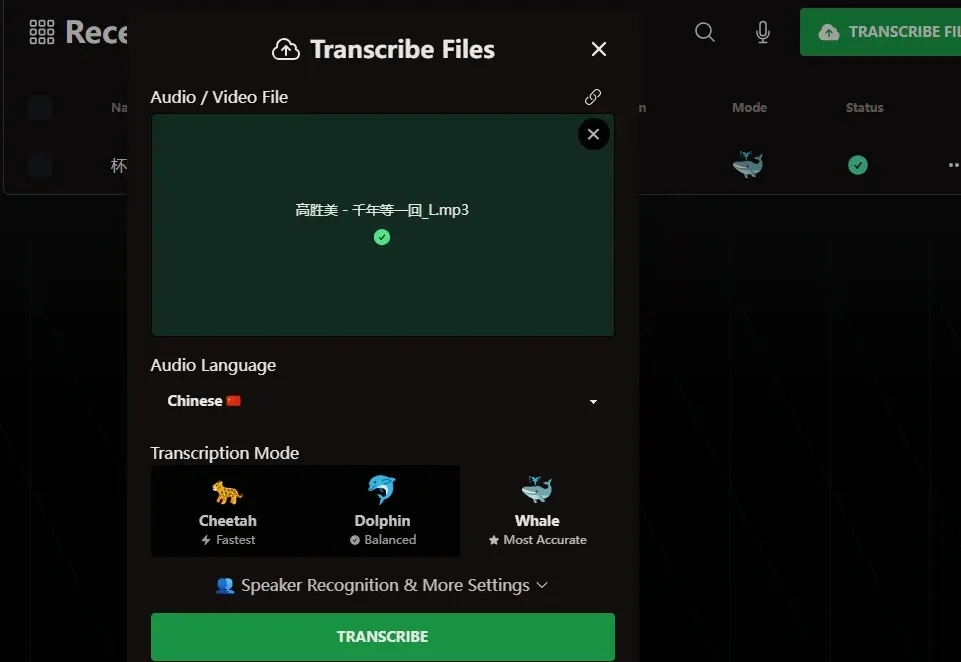
最近看到了一个音频转文字的 AI 工具站:turboscribe.ai。

硬氪获悉,隼瞻科技有限公司(下称“隼瞻科技”)近日完成近亿元天使+轮融资。本轮融资引入英飞尼迪资本、白云金控、深圳中小担创投、厚天资本、华盖资本、嘉誉创投等多家战略投资人,老股东毅达资本、达泰资本持续加持。
过去两年,“AI 游戏”很大程度上还停留在一键生成 Demo 阶段:输入一句提示词,几秒钟生成一个能试玩几分钟的小作品,适合传播和展示模型能力,但很难留下真正的玩家和商业化结果。
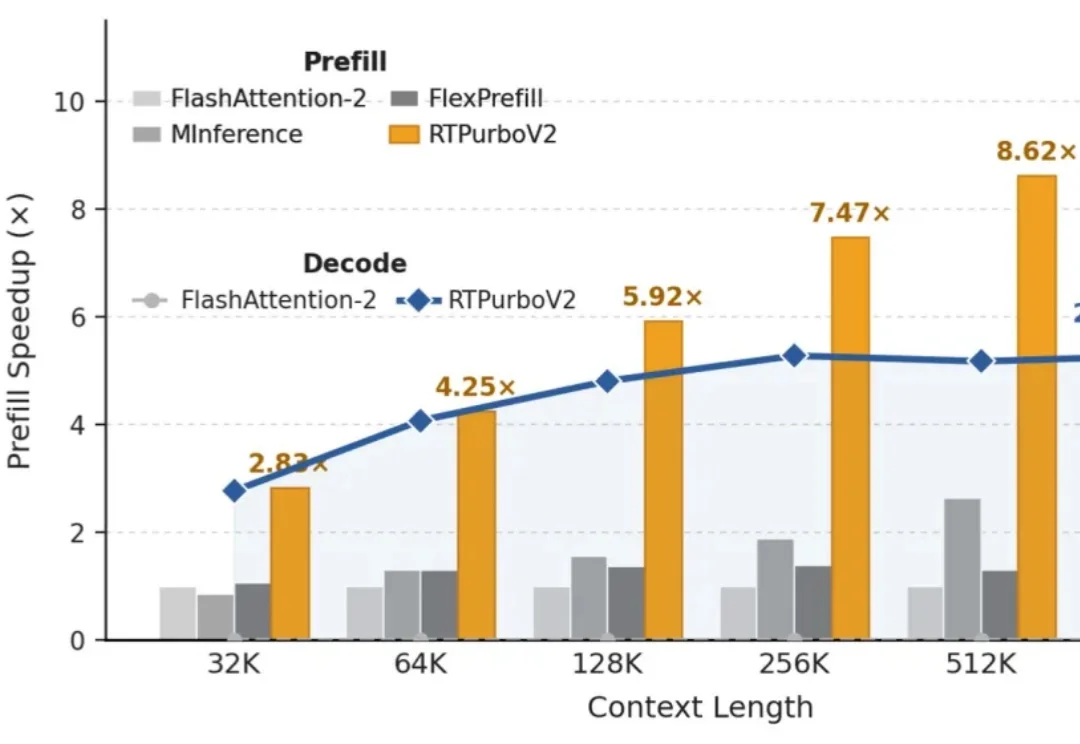
“Full Attention 正在被遗忘”
2K 图像 210ms 解码,4K 细节直接生成,传统「解码 + 超分」流水线可能要被重写了。
当具身智能行业还在密集PoC、卷demo、拼概念时,原力灵机先把答案押向了一个具体动作。
不扩上下文窗口、不换骨干架构、不做全参数微调 —— 只需要一个 8×8 的在线状态矩阵,就能让冻结的 Transformer 拥有真正的长期记忆。