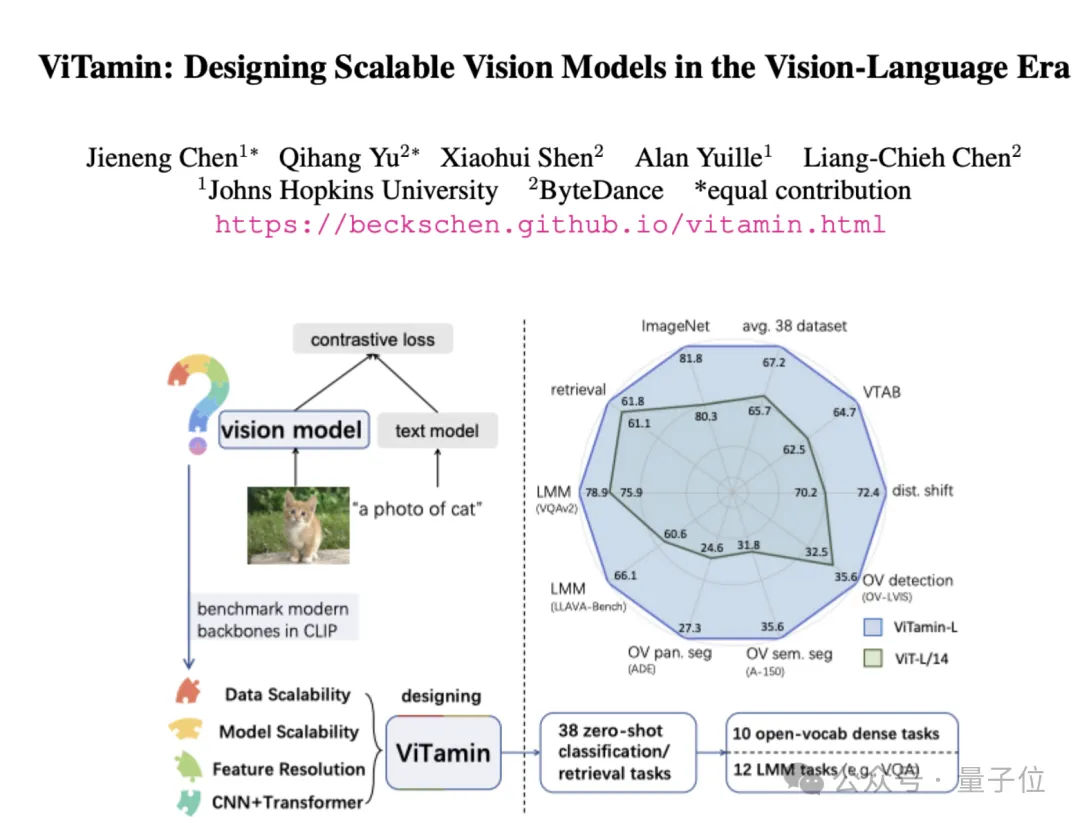
字节发布视觉基础模型ViTamin,多项任务实现SOTA,入选CVPR2024
字节发布视觉基础模型ViTamin,多项任务实现SOTA,入选CVPR2024视觉语言模型屡屡出现新突破,但ViT仍是图像编码器的首选网络结构。
来自主题: AI技术研报
7361 点击 2024-04-27 12:15

 搜索
视觉语言模型屡屡出现新突破,但ViT仍是图像编码器的首选网络结构。
这篇文章来自知名的「科技与商业战略」博客 Stratechery,作者是 Ben Thompson,采访对象 Nat Friedman 和 Daniel Gross 是一对投资二人组,他们很像是「人工智能时代」的 Marc Andreessen 和 Ben Horowitz,后者通过创办了 A16Z 在 2008 年之后成为了移动互联网时代硅谷的顶级投资人。
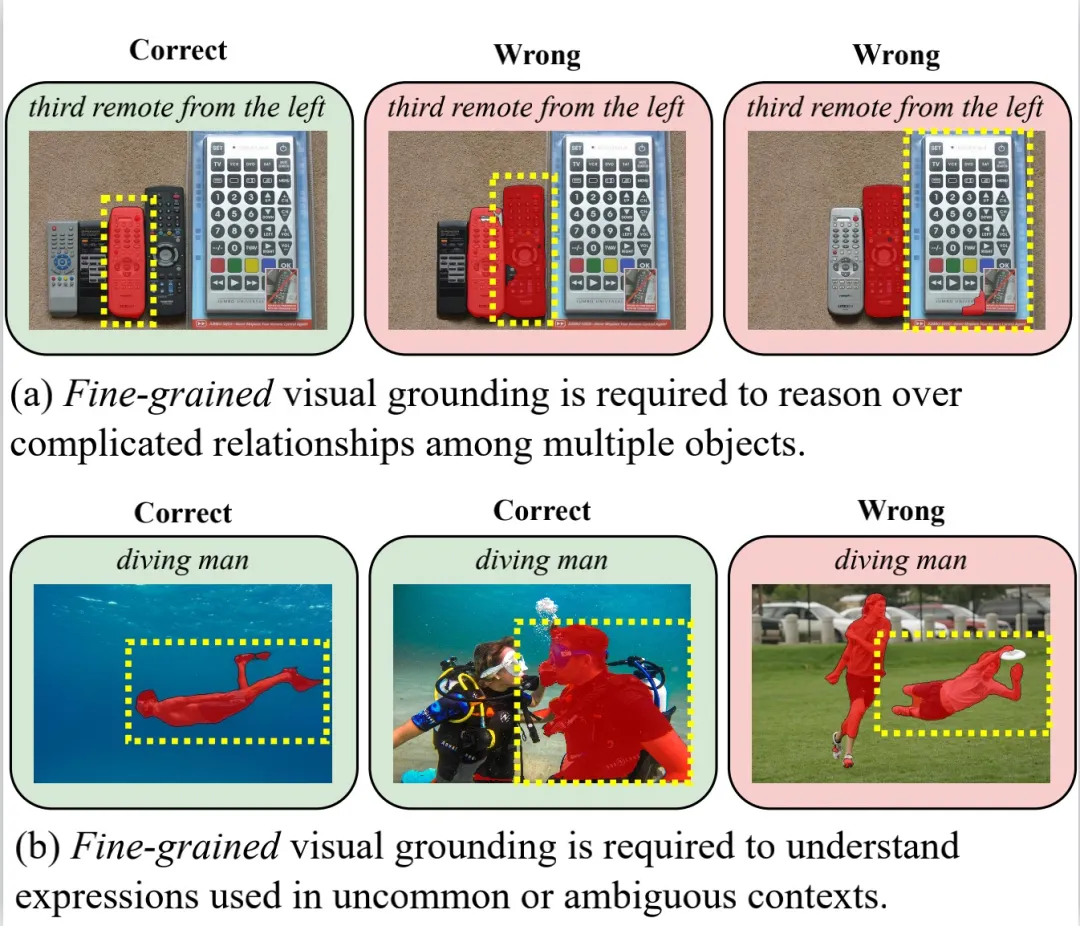
指代分割 (Referring Image Segmentation,RIS) 是一项极具挑战性的多模态任务,要求算法能够同时理解精细的人类语言和视觉图像信息,并将图像中句子所指代的物体进行像素级别的分割。
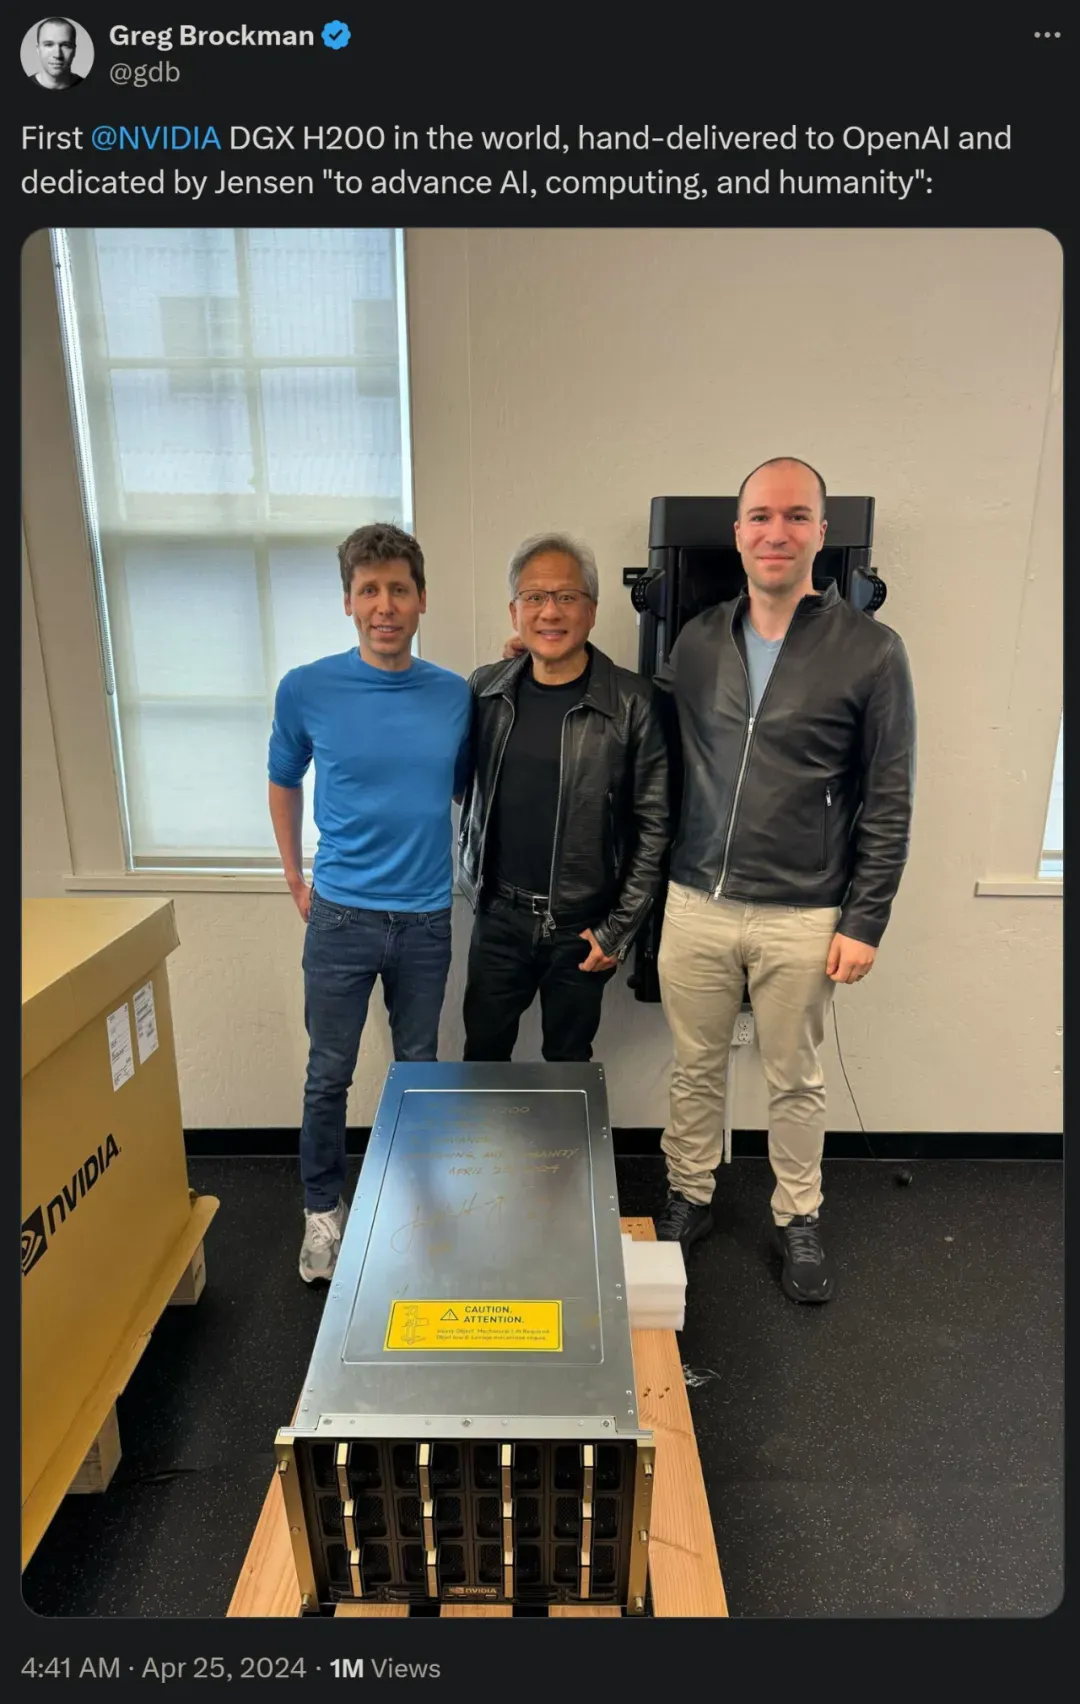
昨天,黄仁勋亲自为 OpenAI 送来了全球第一台 Nvidia DGX H200 超级计算机,三人合影(老黄、奥特曼、Greg Brockman )引得大家津津乐道。
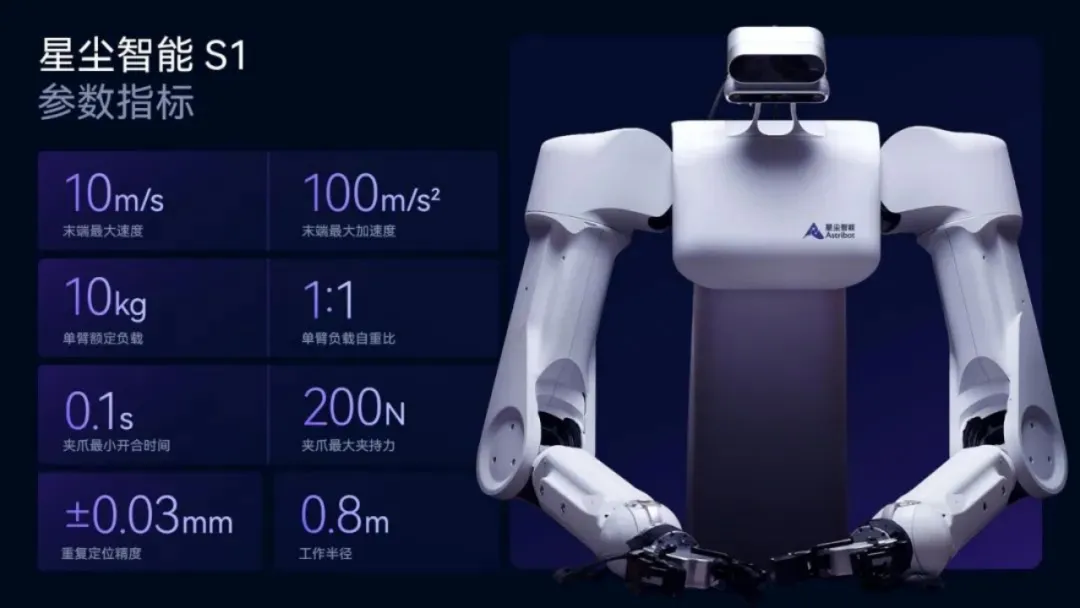
随着 AI 向 AGI(通用人工智能)的圣杯方向加速发展,大模型与机器人的结合是必然趋势。数十年来,单一用途机器人市场已趋于饱和,AI 通用机器人的巨大潜力急待开垦。
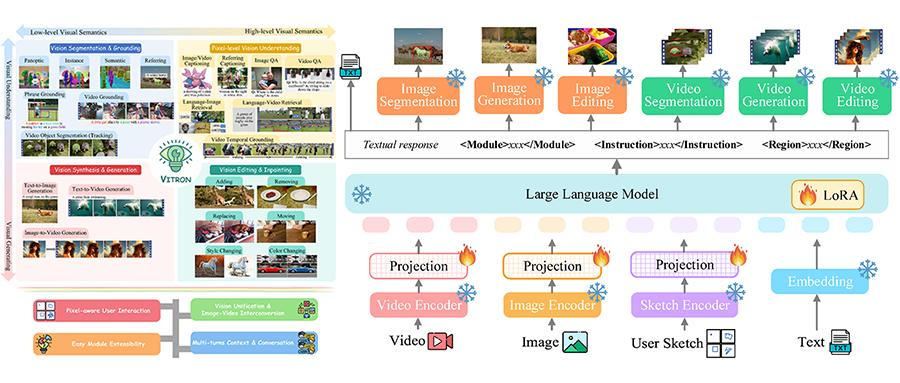
奔向通用人工智能,大模型又迈出一大步。
开源最近成了 AI 圈绕不开的高频热门词汇。
自Alpha Go起至今,AI已在资本市场浮沉近10年。围绕这一概念展开的资本游戏亦愈发扑朔迷离。
最近,一家名为 Reka 的初创公司发布了一款多模态语言模型——Reka Core,这是他们自2022 年成立以来第三款模型。

基于大模型知识库的问答类应用早已在全球溢满,不再成为新鲜事。AI Agent项目成为新的锚点,承载着创业者、投资人、从业者对未来应用的厚望。