都在说缺算力,90% 的 AI 芯片却被「浪费」了?
都在说缺算力,90% 的 AI 芯片却被「浪费」了?全球最昂贵的浪费,正发生在最聪明的公司里。当你正 Vibe Coding 嗨到不行,或者跑着的项目突然停摆,打开 CLI 工具一看,「你的额度已用完」字样出现时,心态不崩是不可能的。
来自主题: AI资讯
7822 点击 2026-06-28 11:12

 搜索
全球最昂贵的浪费,正发生在最聪明的公司里。当你正 Vibe Coding 嗨到不行,或者跑着的项目突然停摆,打开 CLI 工具一看,「你的额度已用完」字样出现时,心态不崩是不可能的。
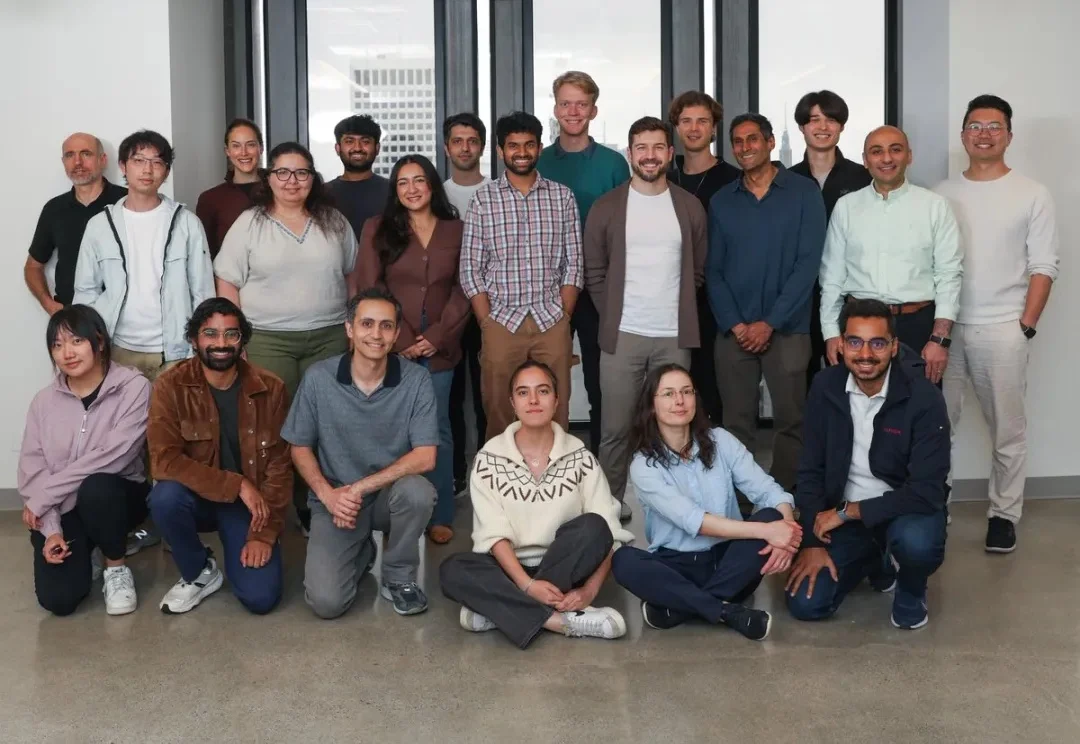
Harsh Mehta 在 Anthropic 的时候,启动了一个后来被称为 autoresearch 的内部平台(不是 Karpathy 那个)。最初这个项目只有他一个人,功能是让 AI 自主完成 AI 研发中的一系列流程环节:提出实验假设、编写代码、调度算力、评估结果,再决定下一步做什么。
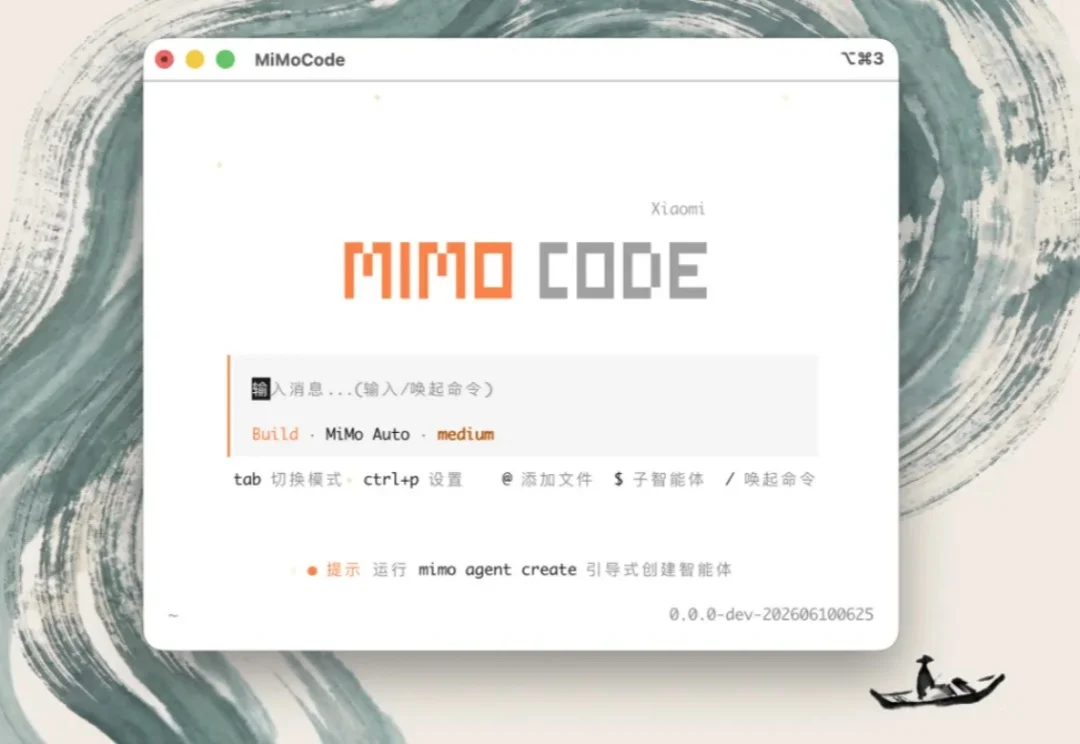
6 月 11 日凌晨,小米 MiMo 团队公开了一个叫 MiMo Code 的项目,定位是终端编程 Agent,MIT 协议开源。官方宣传重点有三处,14 天 5 人团队投入的“vibe coding”开发叙事、Claude Code 之上的 SWE-Bench Pro 跑分。以及“无限上下文”的记忆架构。
为什么推开源工具?在vibecoder到高级程序员都懂的原因,你能自己魔改成自家用的黑科技有什么不好?而且还不用订阅不花钱。为此,我们搞了这个游戏开发者的实用选型指南。每一个工具,都会告诉你:它适合做什么、不适合做什么、以及如何与AI工作流结合。
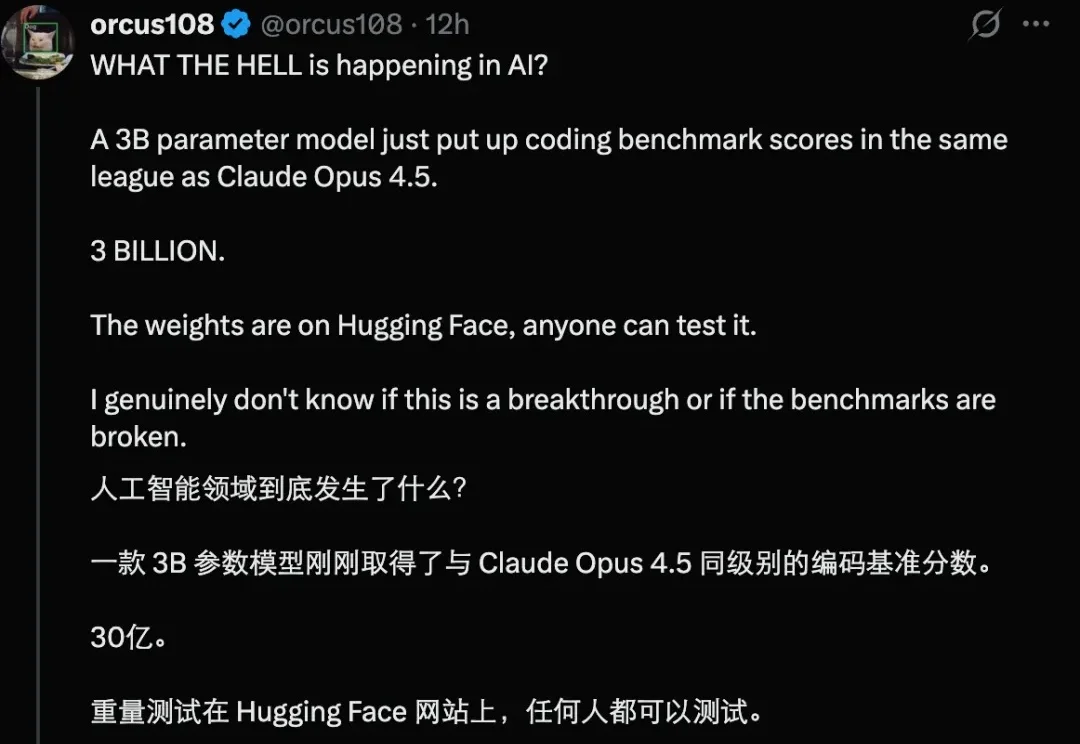
最近几天,一个 3B 的小模型在 X 上火了,因为在一些难度可验证的推理任务上(比如编程),它进入了 Gemini 3 Pro、GPT-5 high、Claude Opus 4.5、GLM-5、Kimi K2.5 等前沿模型的性能区间,而它的体积远小于这些模型。
最近追《歌手》的同事说,胡彦斌已经跟咱是「同行」了——除了编歌,就是天天在办公室玩 Vibe Coding。
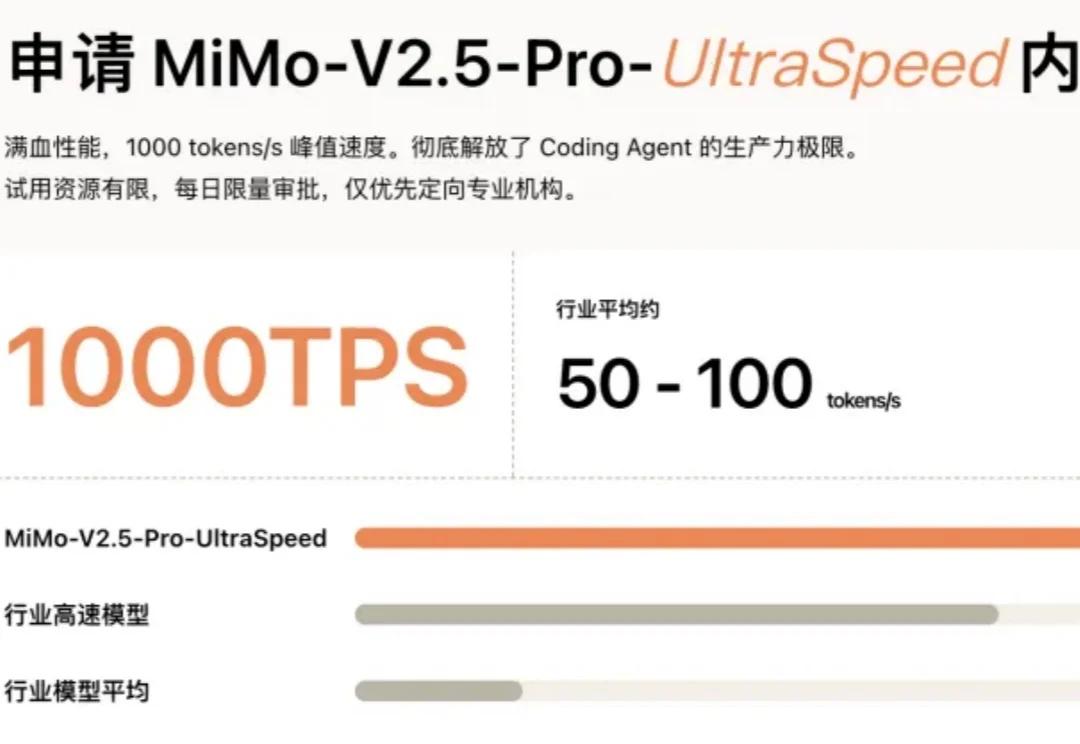
全球大模型的军备竞赛,正在“智商”之外开辟新的战场—— 推理速度。
还在手动在不同工具间来回切换查文献、跑代码、看结果?两个月前发起内侧的科研龙虾SciClaw,经过上万名科研人的「考核」,正式升级为Mira,推出专家小队、科研画布、LLM WIKI 三大核心能力,首次将「Vibe Researching」理念产品化,让研究者像组建实验室团队一样配置 AI,把时间还给真正的科学思考。
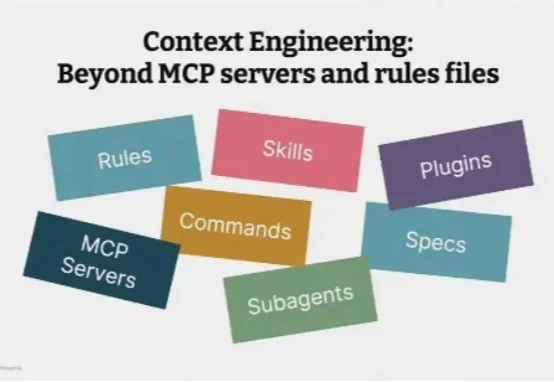
一年前,行业还在为“从自动补全到 Agent”的进化感到兴奋。然而一年过去,我们不难发现单纯靠“Vibe Coding”和“Prompt 调优”,面对非确定性模型带来的风险和成本问题,显然无法撑起企业级软件开发。
如果你接触过“氛围编程”(Vibe coding)、开发过 AI 应用,或许会对 Supabase 的名字感到熟悉。它是全球无数独立开发者最信赖的默认后端之一,也在最近一年里,成了资本热捧的开源巨头。