AI资讯新闻榜单内容搜索-SI

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: SI
四款扩散大语言模型全部破防?上交&上海AI Lab发现致命安全缺陷

四款扩散大语言模型全部破防?上交&上海AI Lab发现致命安全缺陷

四款扩散大语言模型全部破防?上交&上海AI Lab发现致命安全缺陷

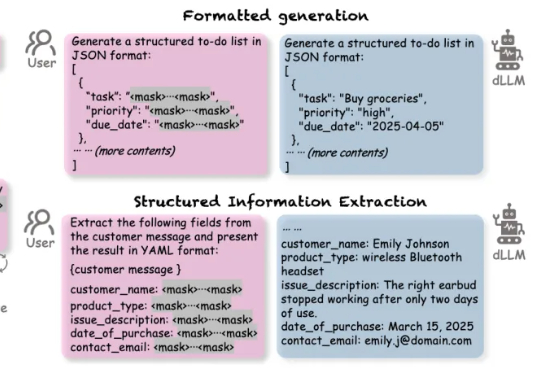
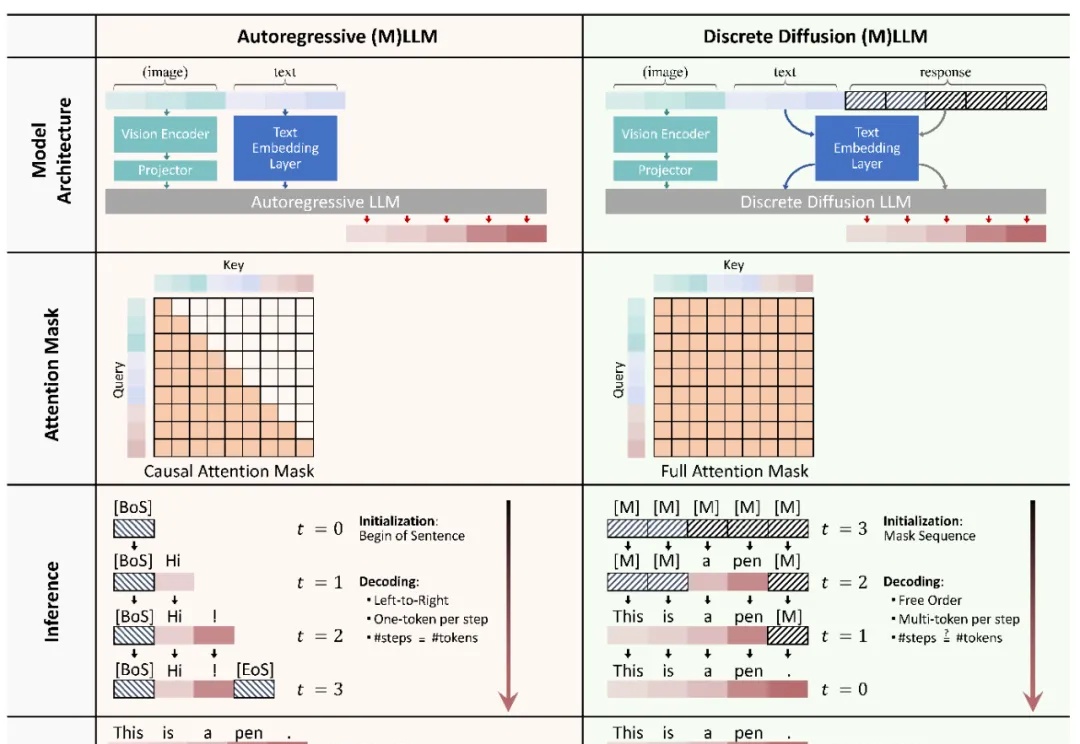
扩散语言模型(Diffusion-based LLMs,简称 dLLMs)以其并行解码、双向上下文建模、灵活插入masked token进行解码的特性,成为一个重要的发展方向。

来自主题: AI技术研报
10877 点击    2025-07-23 15:04
速递|21岁MIT辍学生打造AI合规:Delve获Insight领投3200万美元,估值3亿美元

速递|21岁MIT辍学生打造AI合规:Delve获Insight领投3200万美元,估值3亿美元

速递|21岁MIT辍学生打造AI合规:Delve获Insight领投3200万美元,估值3亿美元

卡伦·考希克( Karun Kaushik )和塞林·科卡拉尔( Selin Kocalar )原本没打算这么快进行 A 轮融资。他们的人工智能合规初创公司 Delve 在今年 1 月刚宣布完成 300 万美元种子轮融资,业务增长迅猛且客户签约率稳定攀升。
来自主题: AI资讯
8567 点击    2025-07-23 13:50
9岁女孩靠AI「万能钥匙」赚到第一桶金!OpenAI新CEO的六大野心

9岁女孩靠AI「万能钥匙」赚到第一桶金!OpenAI新CEO的六大野心

9岁女孩靠AI「万能钥匙」赚到第一桶金!OpenAI新CEO的六大野心

Fidji Simo以Instacart CEO的成功经验,加入OpenAI管理层。这份备忘录展示了她的宏大愿景:让AI成为知识、健康和创意的钥匙,打破资源壁垒,重塑人类的生活方式。
来自主题: AI资讯
7146 点击    2025-07-23 12:55
AMD携手Stability AI推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型,带来更快速且画质无损的文生图功能

AMD携手Stability AI推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型,带来更快速且画质无损的文生图功能

AMD携手Stability AI推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型,带来更快速且画质无损的文生图功能

AMD携手Stability AI宣布推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型。该模型可直接运行于AMD XDNA 2 NPU之上,能够显著提升图像生成质量。新模型作为Amuse 3.1平台的组件之一亮相,于今天一起发布。
来自主题: AI资讯
12261 点击    2025-07-23 10:06
AI“压力面”,DeepSeek性能暴跌近30% | 清华&上海AI Lab

AI“压力面”,DeepSeek性能暴跌近30% | 清华&上海AI Lab

AI“压力面”,DeepSeek性能暴跌近30% | 清华&上海AI Lab

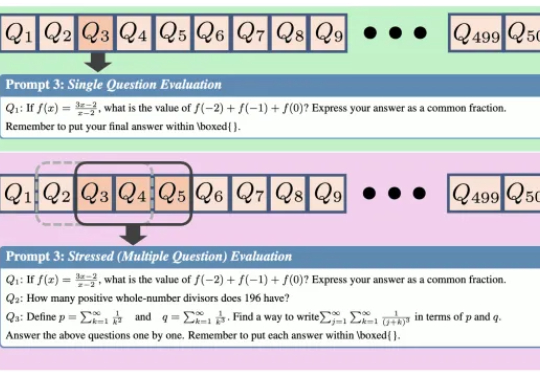
给AI一场压力测试,结果性能暴跌近30%。 来自上海人工智能实验室、清华大学和中国人民大学的研究团队设计了一个全新的“压力测试”框架——REST (Reasoning Evaluation through Simultaneous Testing)。
来自主题: AI技术研报
11282 点击    2025-07-21 10:44
Transformer终结者!谷歌DeepMind全新MoR架构问世,新一代魔王来了

Transformer终结者!谷歌DeepMind全新MoR架构问世,新一代魔王来了

Transformer终结者!谷歌DeepMind全新MoR架构问世,新一代魔王来了

Transformer杀手来了?KAIST、谷歌DeepMind等机构刚刚发布的MoR架构,推理速度翻倍、内存减半,直接重塑了LLM的性能边界,全面碾压了传统的Transformer。网友们直呼炸裂:又一个改变游戏规则的炸弹来了。
来自主题: AI技术研报
11387 点击    2025-07-17 17:00
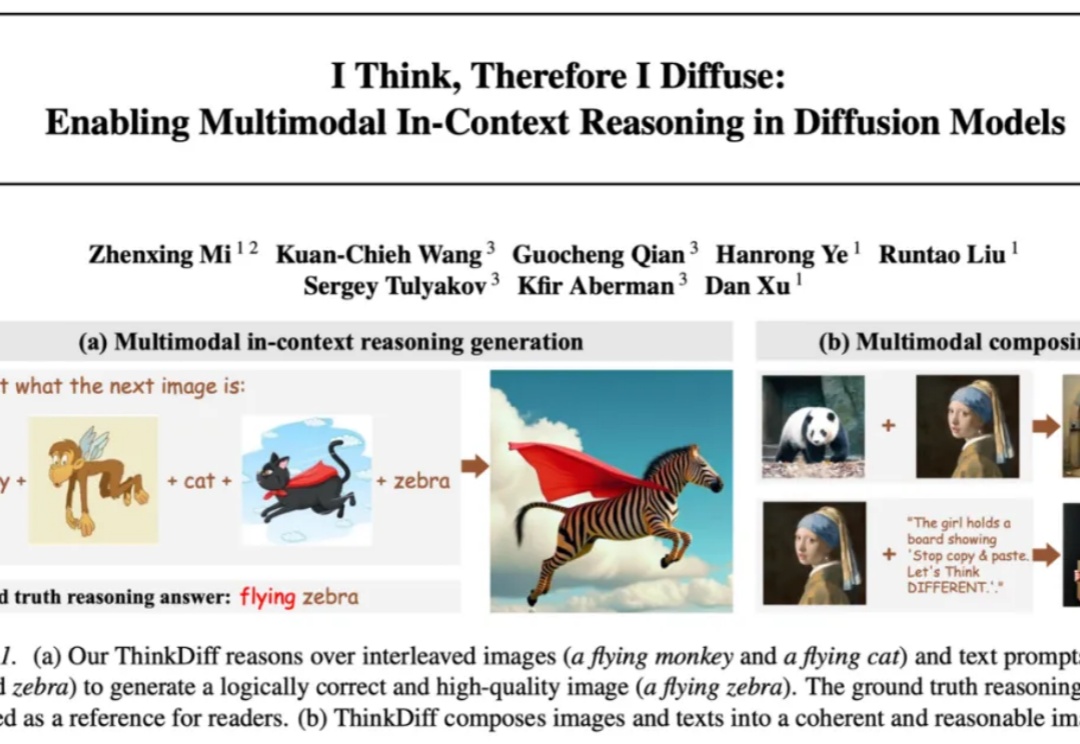
ICML 2025|多模态理解与生成最新进展:港科联合SnapResearch发布ThinkDiff,为扩散模型装上大脑

ICML 2025|多模态理解与生成最新进展:港科联合SnapResearch发布ThinkDiff,为扩散模型装上大脑

ICML 2025|多模态理解与生成最新进展:港科联合SnapResearch发布ThinkDiff,为扩散模型装上大脑

自 Stable Diffusion、Flux 等扩散模型 (Diffusion models) 席卷图像生成领域以来,文本到图像的生成技术取得了长足进步。但它们往往只能根据精确的文字或图片提示作图,缺乏真正读懂图像与文本、在多模 态上下文中推理并创作的能力。能否让模型像人类一样真正读懂图像与文本、完成多模态推理与创作,一直是学术界和工业界关注的热门问题。
来自主题: AI技术研报
10029 点击    2025-07-16 15:19
比Adam更有效,POET从谱不变原理出发,让LLM训练又稳又快

比Adam更有效,POET从谱不变原理出发,让LLM训练又稳又快

比Adam更有效,POET从谱不变原理出发,让LLM训练又稳又快

Zeju Qiu和Tim Z. Xiao是德国马普所博士生,Simon Buchholz和Maximilian Dax担任德国马普所博士后研究员
来自主题: AI技术研报
11187 点击    2025-07-15 10:11
VLA 推理新范式!一致性模型 CEED-VLA 实现四倍加速!

VLA 推理新范式!一致性模型 CEED-VLA 实现四倍加速!

VLA 推理新范式!一致性模型 CEED-VLA 实现四倍加速!

近年来,视觉 - 语言 - 动作(Vision-Language-Action, VLA)模型因其出色的多模态理解与泛化能力,已成为机器人领域的重要研究方向。尽管相关技术取得了显著进展,但在实际部署中,尤其是在高频率和精细操作等任务中,VLA 模型仍受到推理速度瓶颈的严重制约。

来自主题: AI技术研报
8589 点击    2025-07-14 11:12