三榜第一,完胜GPT-6!中国物理RSI杀出黑马
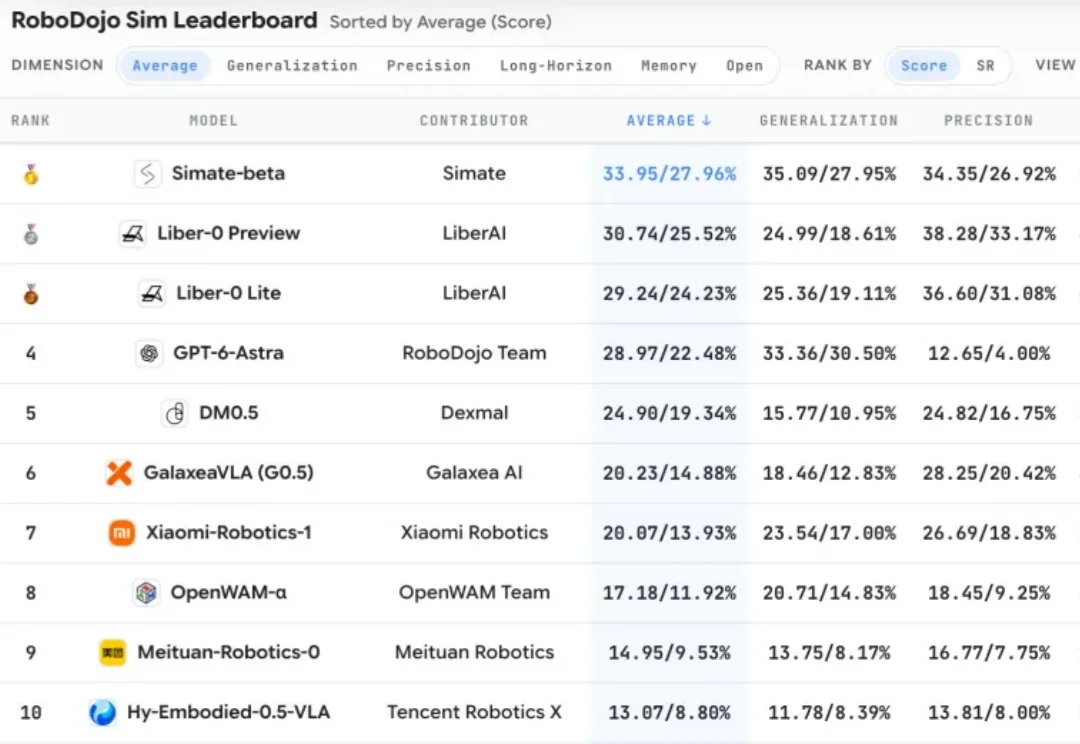
三榜第一,完胜GPT-6!中国物理RSI杀出黑马诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
来自主题: AI资讯
9364 点击 2026-09-25 10:11

 搜索
诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
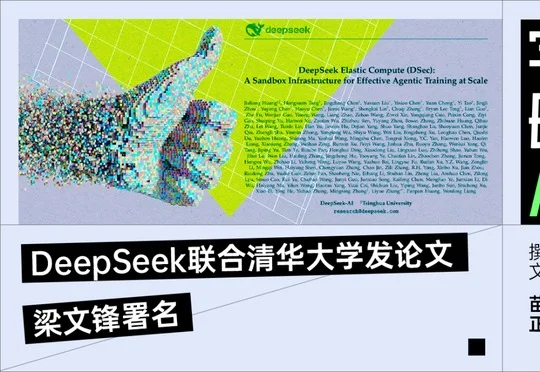
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。
Z Potentials获悉,Physical AI公司息壤开物近日连续完成数亿元种子轮及天使轮融资,目前估值达5亿美元。本轮融资由敦鸿资产领投,华控基金、三花控股、银杏谷资本、泽然资本、本坚基金、天使基石、标朴投资等机构跟投。募集资金将主要用于原生物理AI模型的规模预训练、真实物理交互数据建设、核心研发人才引入及场景验证。
就在刚刚,AI圈迎来全新黑马。
近日,IQuest Research 同北京航空航天大学、曼彻斯特大学等合作伙伴发布 ModularRSI,尝试让 Agent 根据自身执行经验,持续修改模型外围的运行机制——Harness。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
今年以来,RSI(Recursive Self-Improvement,递归自我改进)逐渐从硅谷前沿话题,演变为全球共识。
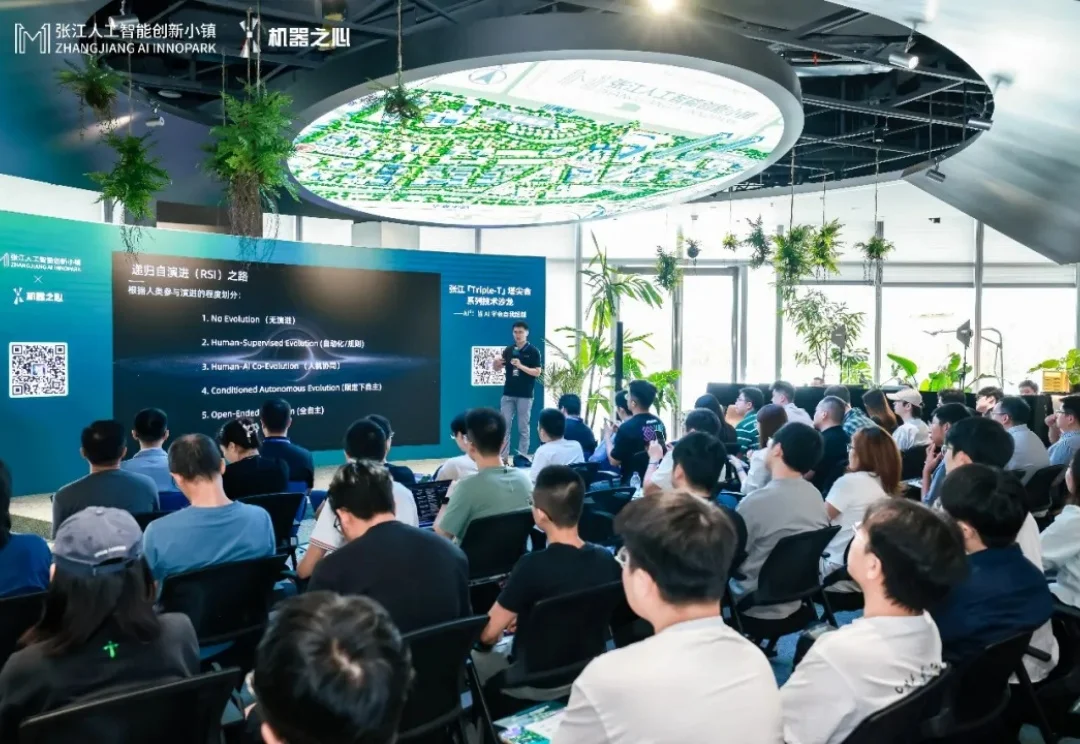
AI 距离真正的递归自我改进(RSI)还有多远?当前,AI 已开始参与数据生成、训练优化、工具迭代与结果验证,但参与研发,并不意味着已经具备持续改进自身的能力。它能够自主完成哪些环节,又如何将局部优化连接成持续、可靠的改进闭环?回答这些问题,需要回到具体的研究与实践,审视已有进展与尚待突破的瓶颈。
过去,在灵光闪应用中,用户需要等到应用生成完成,才能看到完整的页面设计和视觉效果。 在画眉的专业设计场景中,设计师拿到成图后,还要经过拆层处理,通常需要 5 分钟以上才能继续编辑。 一个需要更早看见设
9 月 16 日,在谷歌 DeepMind 深度参与了 Gemini 2.5/3、世界模型 Genie 2/3 以及具身智能体 Sima 2 研发的核心研究员 Bonnie Li 宣布离职,转会 OpenAI。