3D重建范式变革!最新模型MVDiffusion++:无需相机姿态,即可实现高清3D模型重建
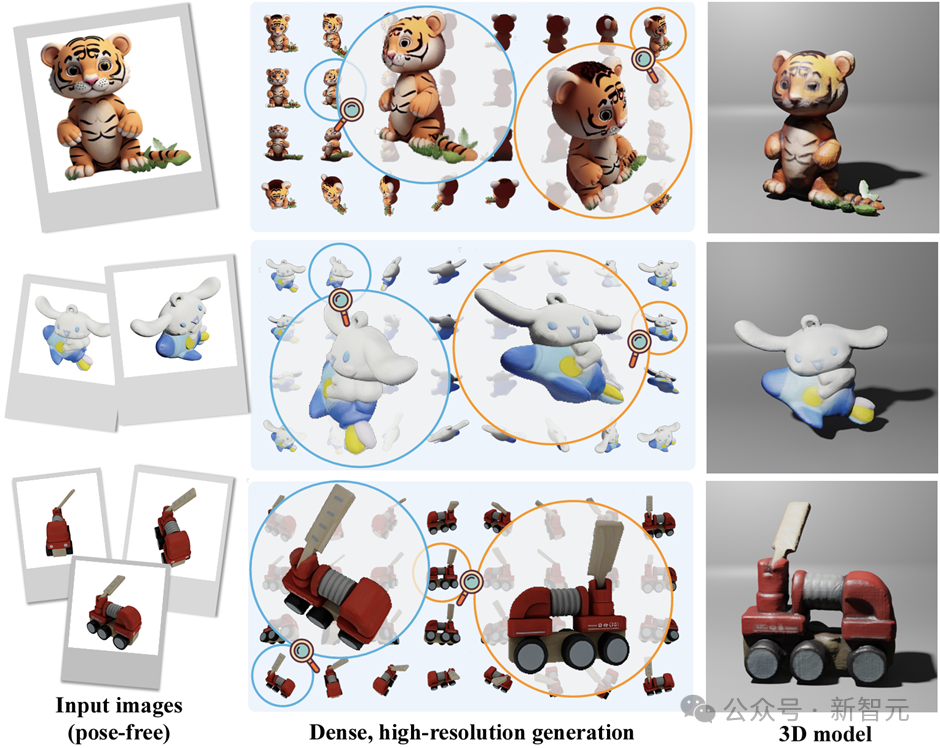
3D重建范式变革!最新模型MVDiffusion++:无需相机姿态,即可实现高清3D模型重建受人类视觉系统的启发,MVDiffusion++结合计算方法高保真和人类视觉系统灵活性,可以根据任意数量的无位姿图片, 生成密集、高分辨率的有位姿图像,实现了高质量的3D模型重建。
来自主题: AI技术研报
8720 点击 2024-03-21 10:24

 搜索
受人类视觉系统的启发,MVDiffusion++结合计算方法高保真和人类视觉系统灵活性,可以根据任意数量的无位姿图片, 生成密集、高分辨率的有位姿图像,实现了高质量的3D模型重建。
3D 生成领域迎来新的「SOTA 级选手」,支持商用和非商用。Stability AI 的大模型家族来了一位新成员。昨日,Stability AI 继推出文生图 Stable Diffusion、文生视频 Stable Video Diffusion 之后,又为社区带来了 3D 视频生成大模型「Stable Video 3D」(简称 SV3D)。
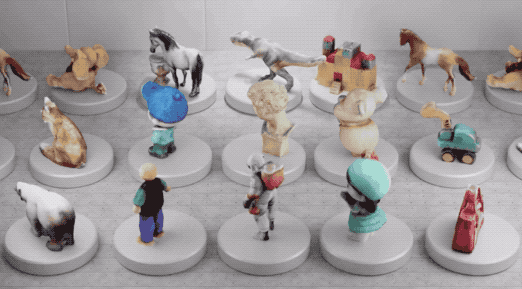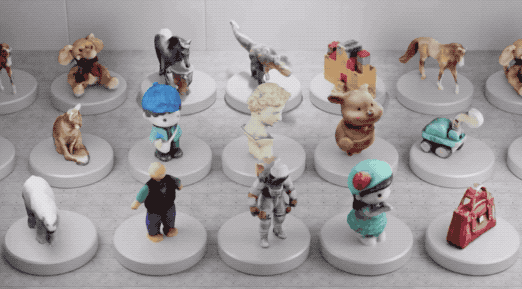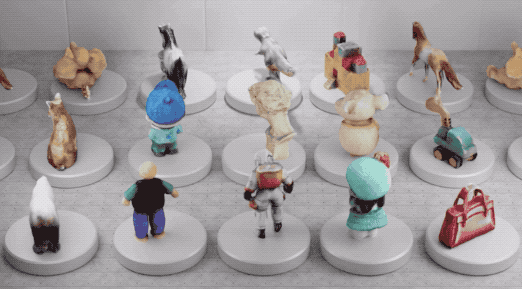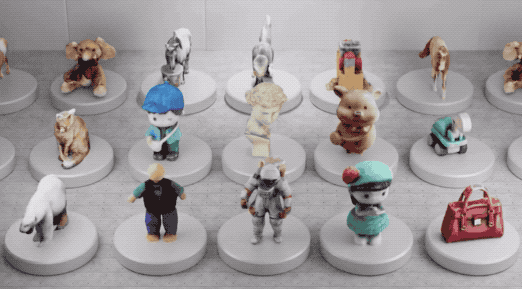
Stable Diffusion背后公司Stability AI又上新了。 这次带来的是图生3D方面的新进展: 基于Stable Video Diffusion的Stable Video 3D(SV3D),只用一张图片就能生成高质量3D网格。
【新智元导读】利用文本生成图片(Text-to-Image, T2I)已经满足不了人们的需要了,近期研究在T2I模型的基础上引入了更多类型的条件来生成图像,本文对这些方法进行了总结综述。
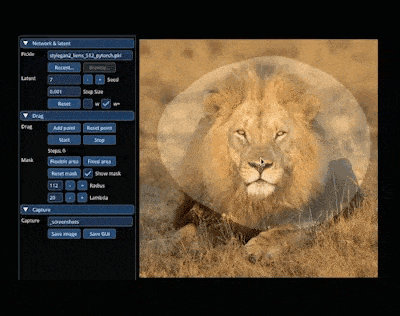
年 5 月,动动鼠标就能让图片变「活」得研究 DragGAN 吸引了 AI 圈的关注。通过拖拽,我们可以改变并合成自己想要的图像,比如下图中让一头狮子转头并张嘴!
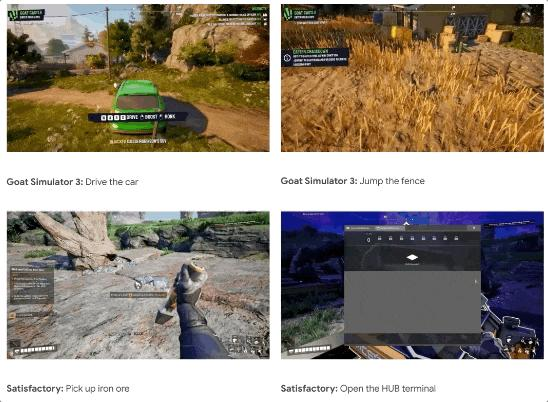
近日,谷歌DeepMind宣布推出一个可扩展指令多世界智能体(Scalable Instructable Multiworld Agent,SIMA)。
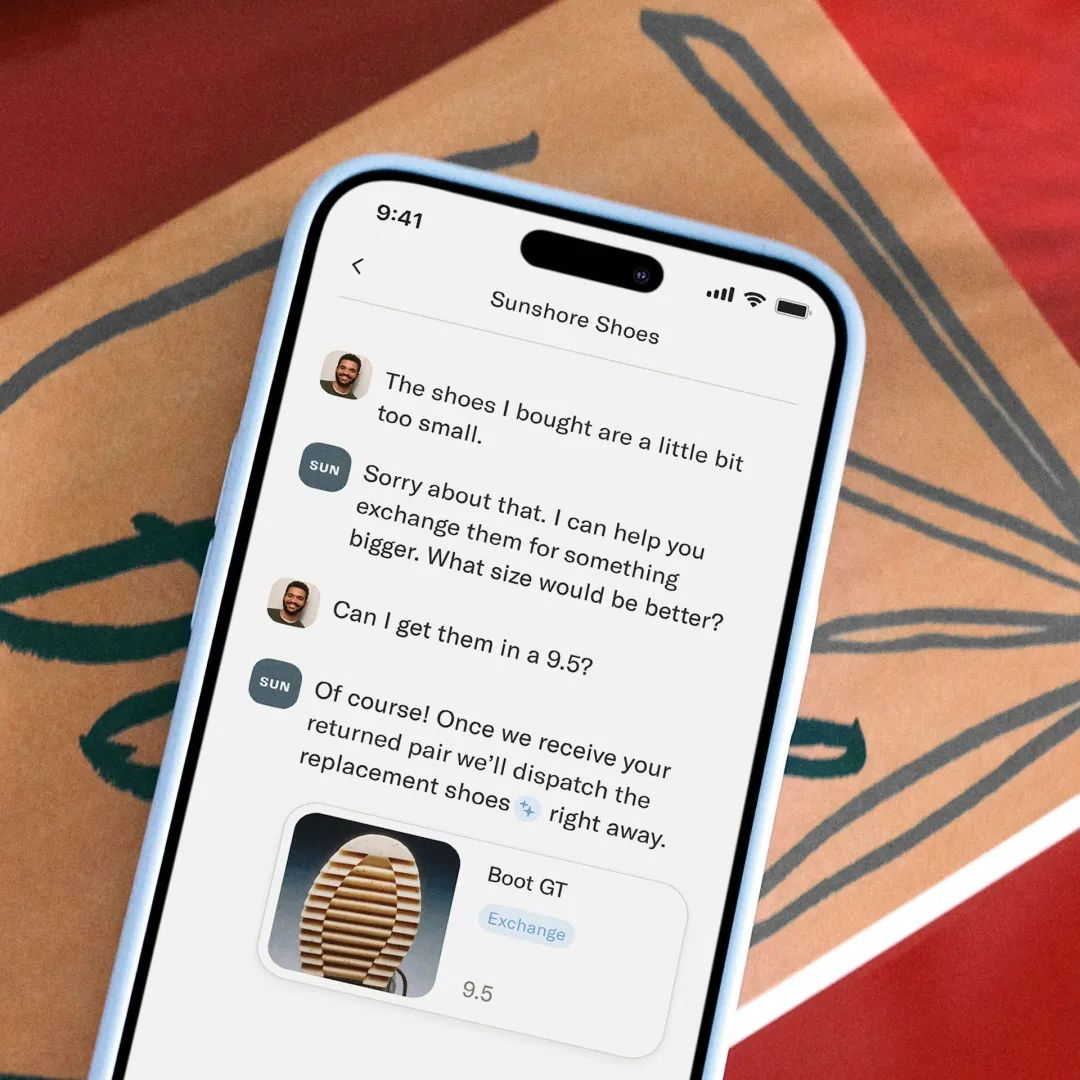
约一年前,OpenAI发布了强大的基础模型GPT-4,这催生了一批基于GPT-4打造应用的创业公司,其中就有法律AI领域的领头羊Harvey。

本文介绍了当前AI创业领域的状况,讨论了基石模型的发展和投资趋势,以及AI应用在SaaS和传统行业的渗透。作者认为,AI创业热潮存在泡沫风险,但找到真实用例和可持续商业模式仍然是成功的关键。
半年多来,Meta 开源的 LLaMA 架构在 LLM 中经受了考验并大获成功(训练稳定、容易做 scaling)。
很快啊,“文生图新王”Stable Diffusion 3的技术报告,这就来了。