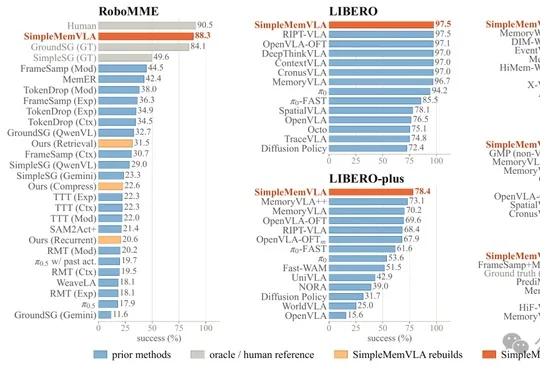
流式推理优化,让机器人决策延迟低至0.68秒
流式推理优化,让机器人决策延迟低至0.68秒SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
来自主题: AI技术研报
10044 点击 2026-09-18 15:47

 搜索
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
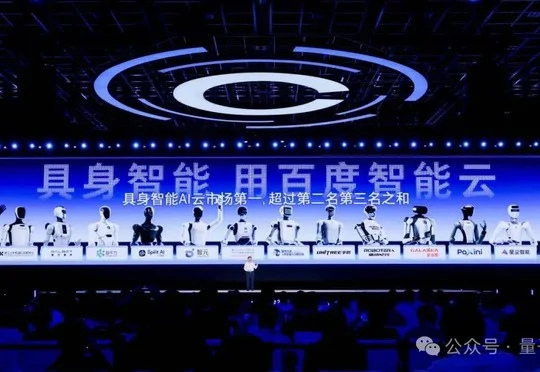
在具身智能技术路线尚未定型的阶段,基础设施需求正率先收敛,百度智能云以百度百舸AI计算平台为核心,为超过50家具身智能企业提供涵盖模型迭代、数据生产和跨本体部署的全栈AI云支撑,并在《中国具身智能云市场份额报告,2025》中以29.55%份额位居第一。
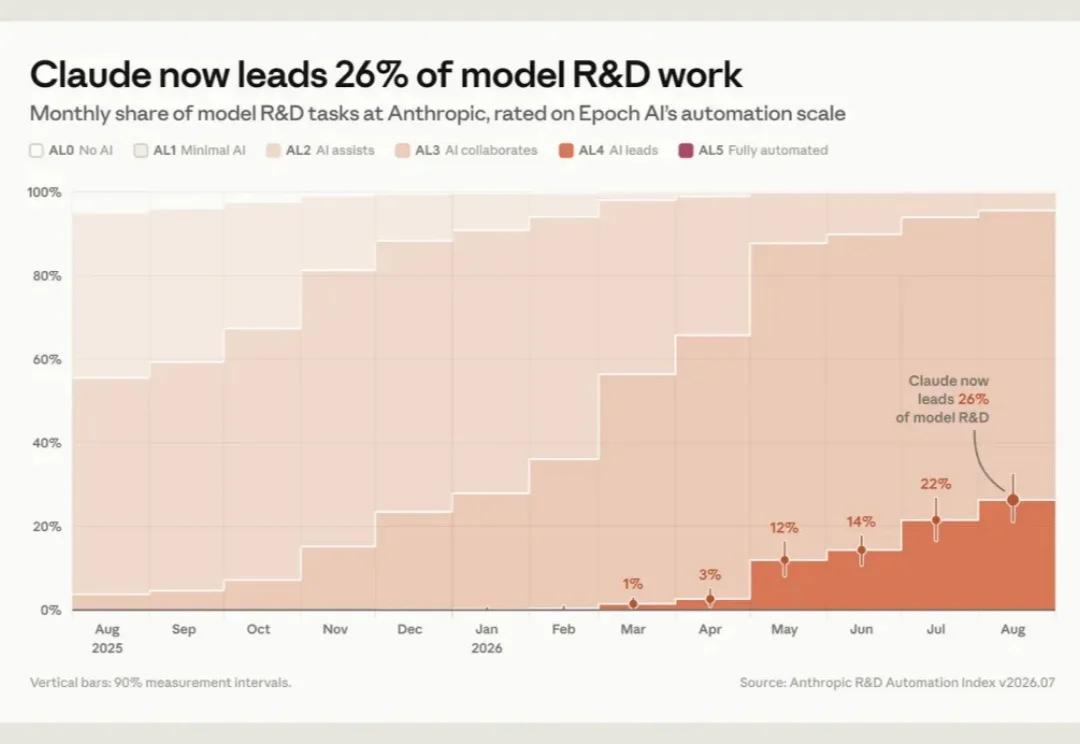
AI 距离递归的自我改进(RSI)还有多远?
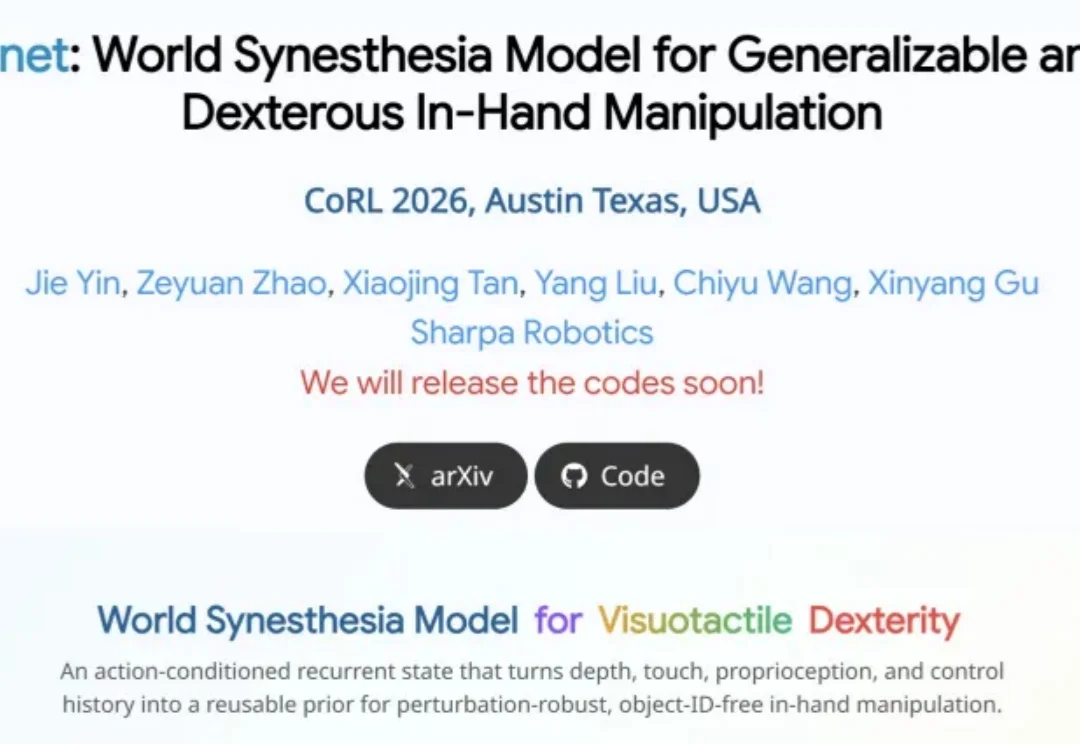
灵巧手从 demo 走向真实应用,关键不只是 “会不会动”,而是能否在 noisy depth、稀疏触觉、外力扰动和未见物体下稳定泛化。现有 in-hand manipulation 往往依赖固定物体、定初始位姿或理想传感器。而一旦遇到真实深度噪声、形状变化和接触状态不可见,这些策略就容易退化成近乎开环的 “手指套路”。
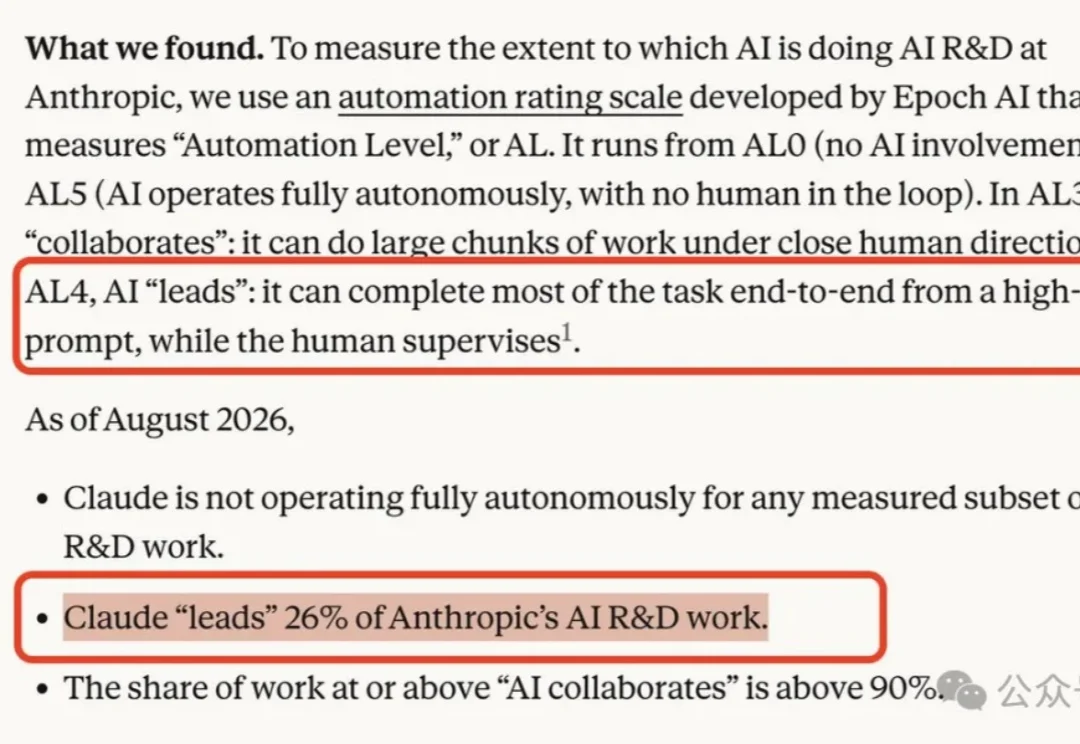
刚刚,Anthropic首次自曝绝密底牌:3万个AI正在研发下一代自己,正在疯狂自我进化。
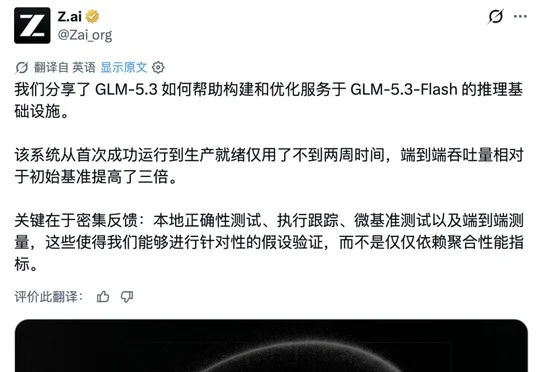
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
谷歌,可能已经破解了RSI!
9 月 3 日,OpenAI 正式发布 GPT-6 Astra。在 ARC-AGI-3(一个考验 AI 能否在陌生环境中自主探索、理解规则并规划行动的 Benchmark),Astra 拿下 99.9%,并在 96% 的关卡中达到或超过人类的行动效率基准。
RSI,彻底火了。