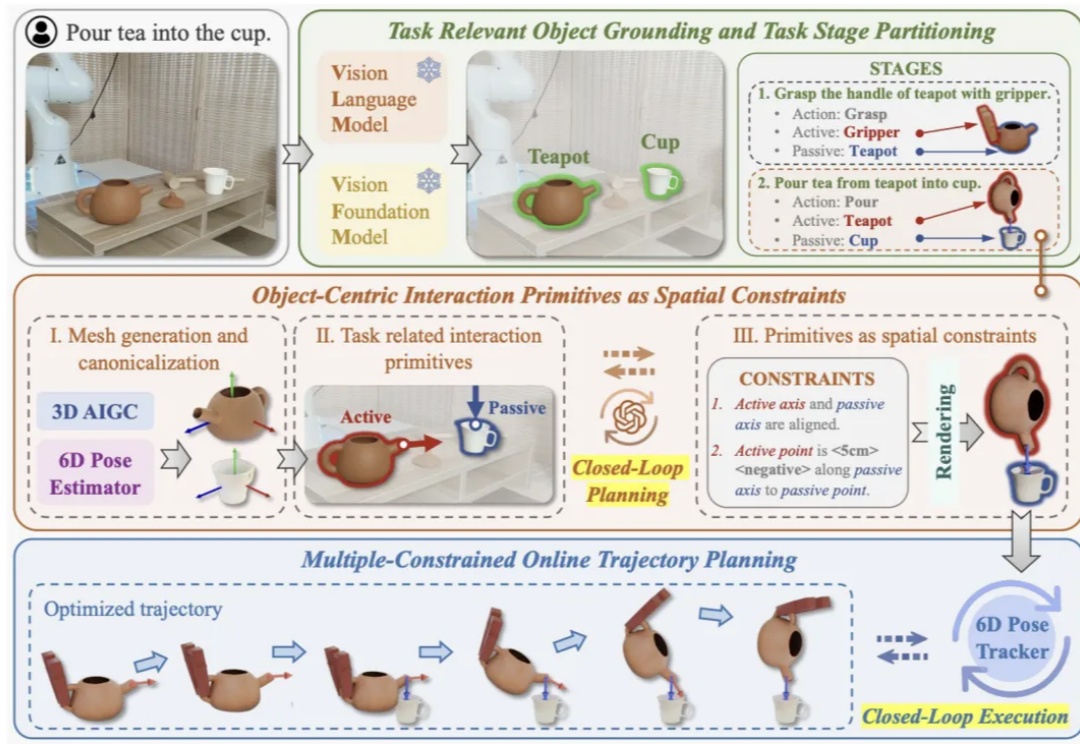
化解机器人的「幻觉」:北大发布OmniManip,VLM结合双闭环系统,3D理解能力大幅提升
化解机器人的「幻觉」:北大发布OmniManip,VLM结合双闭环系统,3D理解能力大幅提升近年来视觉语⾔基础模型(Vision Language Models, VLMs)在多模态理解和⾼层次常识推理上⼤放异彩,如何将其应⽤于机器⼈以实现通⽤操作是具身智能领域的⼀个核⼼问题。这⼀⽬标的实现受两⼤关键挑战制约:
来自主题: AI技术研报
9838 点击 2025-01-23 13:09

 搜索
近年来视觉语⾔基础模型(Vision Language Models, VLMs)在多模态理解和⾼层次常识推理上⼤放异彩,如何将其应⽤于机器⼈以实现通⽤操作是具身智能领域的⼀个核⼼问题。这⼀⽬标的实现受两⼤关键挑战制约:
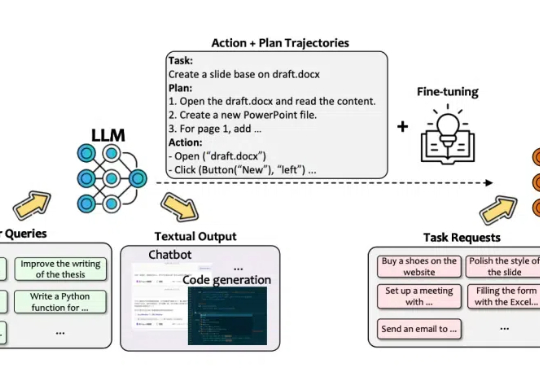
该技术报告的主要作者 Lu Wang, Fangkai Yang, Chaoyun Zhang, Shilin He, Pu Zhao, Si Qin 等均来自 Data, Knowledge, and Intelligence (DKI) 团队,为微软 TaskWeaver, WizardLLM, Windows GUI Agent UFO 的核心开发者。
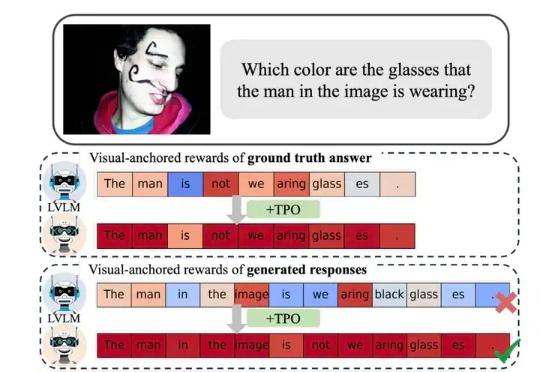
近年来,视觉大模型(Large Vision Language Models, LVLMs)领域经历了迅猛的发展,这些模型在图像理解、视觉对话以及其他跨模态任务中展现出了卓越的能力。然而,随着 LVLMs 复杂性和能力的增长,「幻觉现象」的挑战也日益凸显。

OpenAI,有大事发生!最近各种爆料频出,比如OpenAI已经跨过「递归自我改进」临界点,o4、o5已经能自动化AI研发,甚至OpenAI已经研发出GPT-5?OpenAI员工如潮水般爆料,疯狂暗示内部已开发出ASI。
AI产品与基座模型独立发展,已经成为主流趋势。
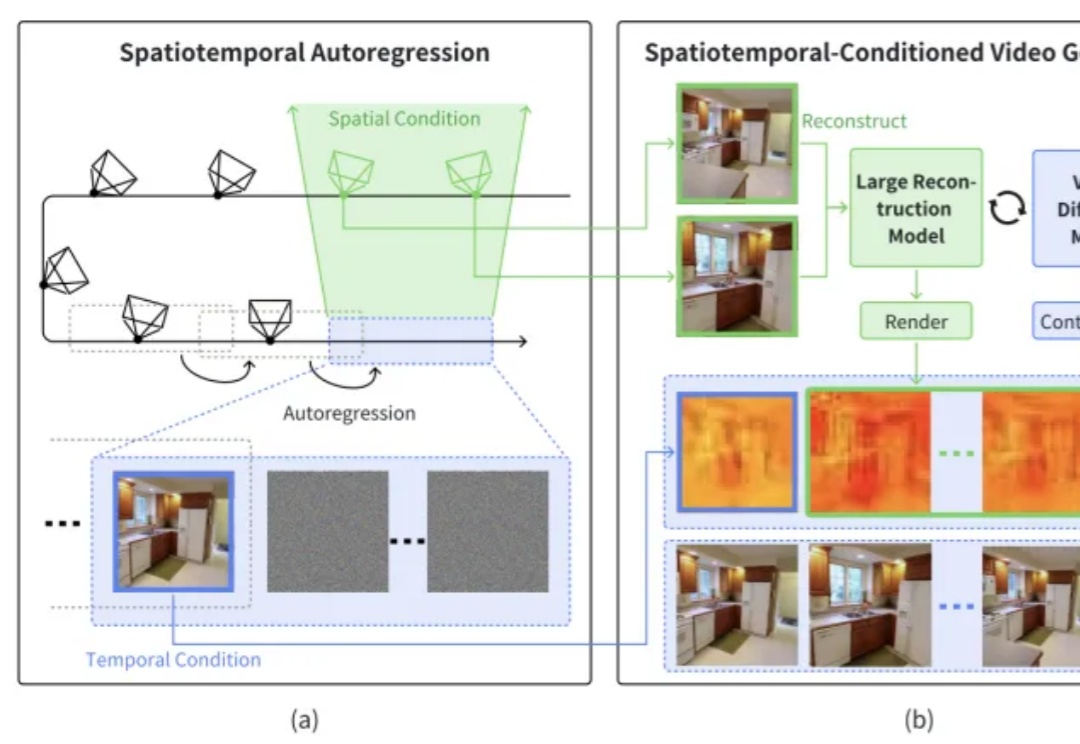
本文介绍了一篇由浙江大学章国锋教授和商汤科技研究团队联合撰写的论文《StarGen: A Spatiotemporal Autoregression Framework with Video Diffusion Model for Scalable and Controllable Scene Generation》。

据 TechCrunch 报道,Synthesia 今天确认已完成 1.8 亿美元的融资轮,这轮 D 系列融资使公司的估值达到 21 亿美元。
12月19日,CMU 联合其他 20 多所研究实验室开源发布了一个生成式物理引擎:Genesis,意为「创世纪」。
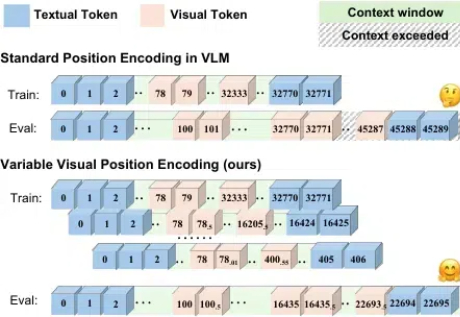
随着语言大模型的成功,视觉 - 语言多模态大模型 (Vision-Language Multimodal Models, 简写为 VLMs) 发展迅速,但在长上下文场景下表现却不尽如人意,这一问题严重制约了多模态模型在实际应用中的潜力。
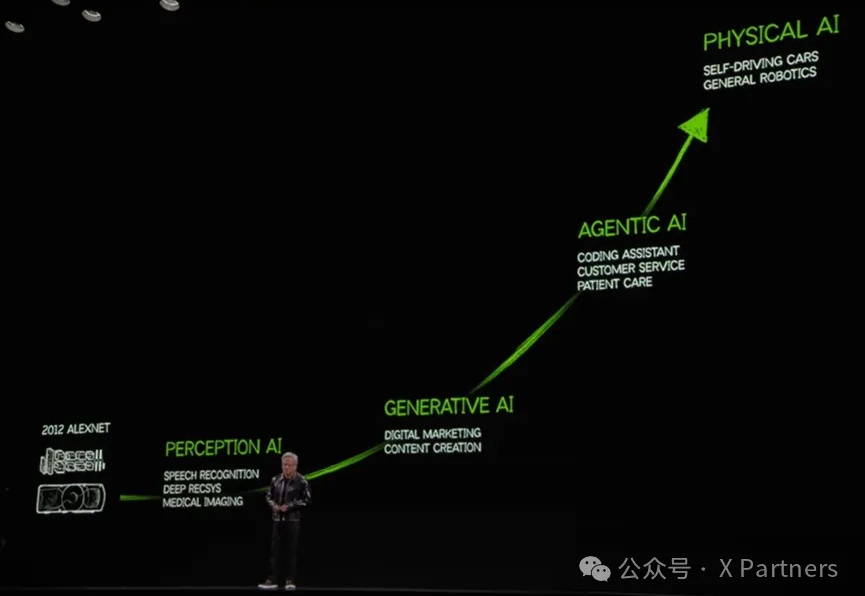
英伟达CEO黄仁勋最近在CES 上的主题演讲及问答,分享了他对未来的愿景。这显然是Agentic AI和Robotics的结合,他称之为Physical AI。