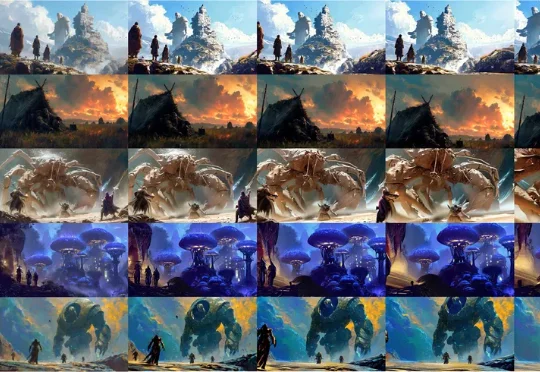
视频世界模型困在像素网格里:腾讯开源SCoPE,用射线空间重写位置关系
视频世界模型困在像素网格里:腾讯开源SCoPE,用射线空间重写位置关系香港大学、香港科技大学与腾讯 ARC Lab 联合提出 SCoPE(Sightline-Coordinate Positional Encoding),一套面向视频 DiT 的射线空间位置编码:让视频模型处理位置关系的基底从张量网格转向射线空间。
来自主题: AI技术研报
8926 点击 2026-08-24 08:49

 搜索
香港大学、香港科技大学与腾讯 ARC Lab 联合提出 SCoPE(Sightline-Coordinate Positional Encoding),一套面向视频 DiT 的射线空间位置编码:让视频模型处理位置关系的基底从张量网格转向射线空间。
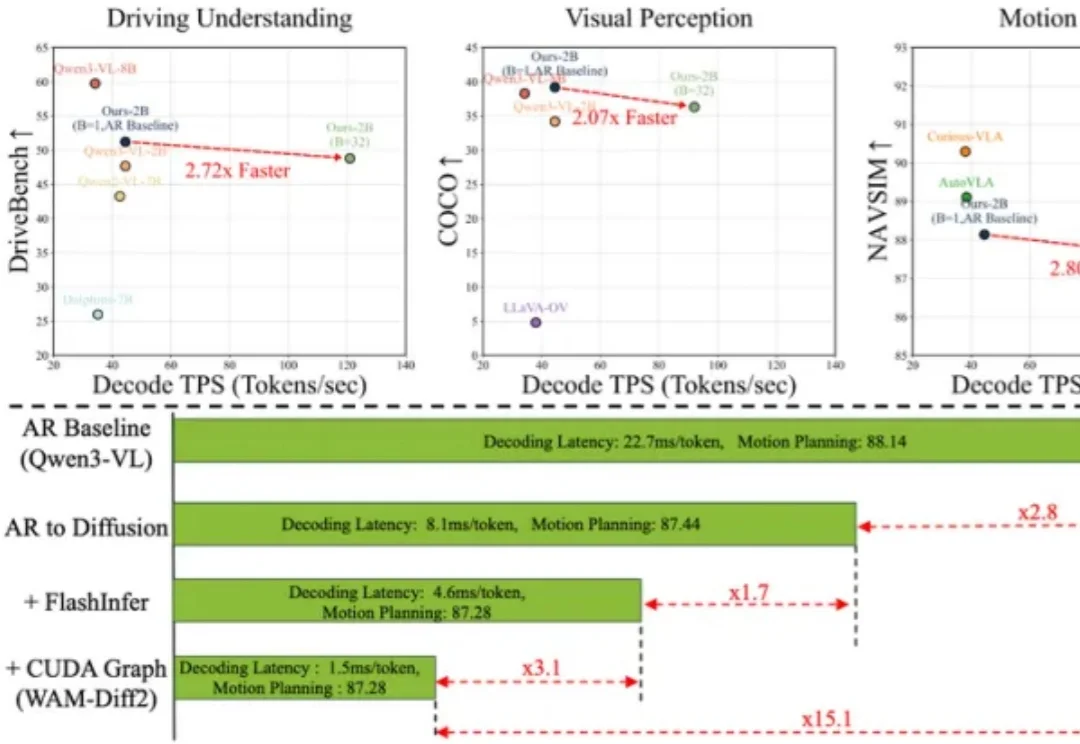
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
今天,英国《金融时报》援引知情人士报道,字节跳动正在训练一个参数量高达10万亿的AI模型。而这一数字,在昨日晚间的晚点LatePost独家报道中还是“超5万亿”。即使是5万亿,这一模型的规模也已经超过目前中国已发布的最大模型Kimi K3,接近Anthropic的Fable 5;如果是10万亿,那字节的新模型规模将超越约有8万亿参数的Mythos 5。
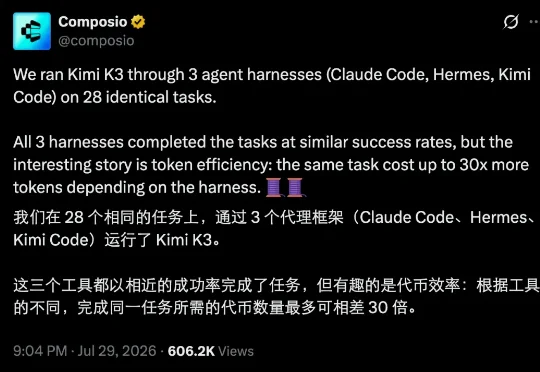
最近有个挺有意思的对比实验,来自 Composio 团队。他们用同一个模型 Kimi K3,分别放进三个不同的 agent 框架(harness)里跑 ——Claude Code、Hermes 和 Kimi Code—— 一共测了 28 个完全相同的任务。
Netflix 为本·阿弗莱克的 AI 电影制作创业公司支付了 5.87 亿美元。在一份新的监管备案文件中,Netflix 披露其为 InterPositive 支付了 5.87 亿美元现金 。InterPositive 是一家由演员兼导演本·阿弗莱克共同创办的初创公司。
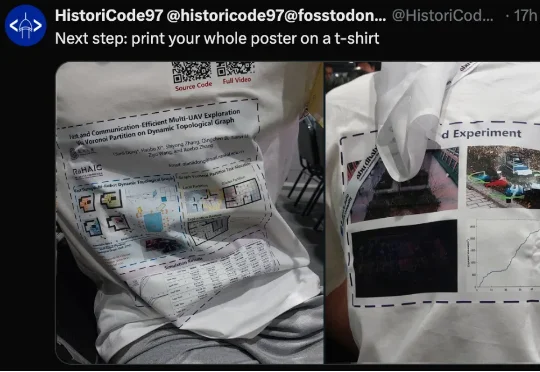
AI 顶会越来越卷了,卷的方向你还猜不到。本周,国际机器学习大会 ICML 在韩国首尔举行。今年 ICML 的 Poster 环节,除了那些极具创新性的论文,也堪称大型学术行为艺术现场。
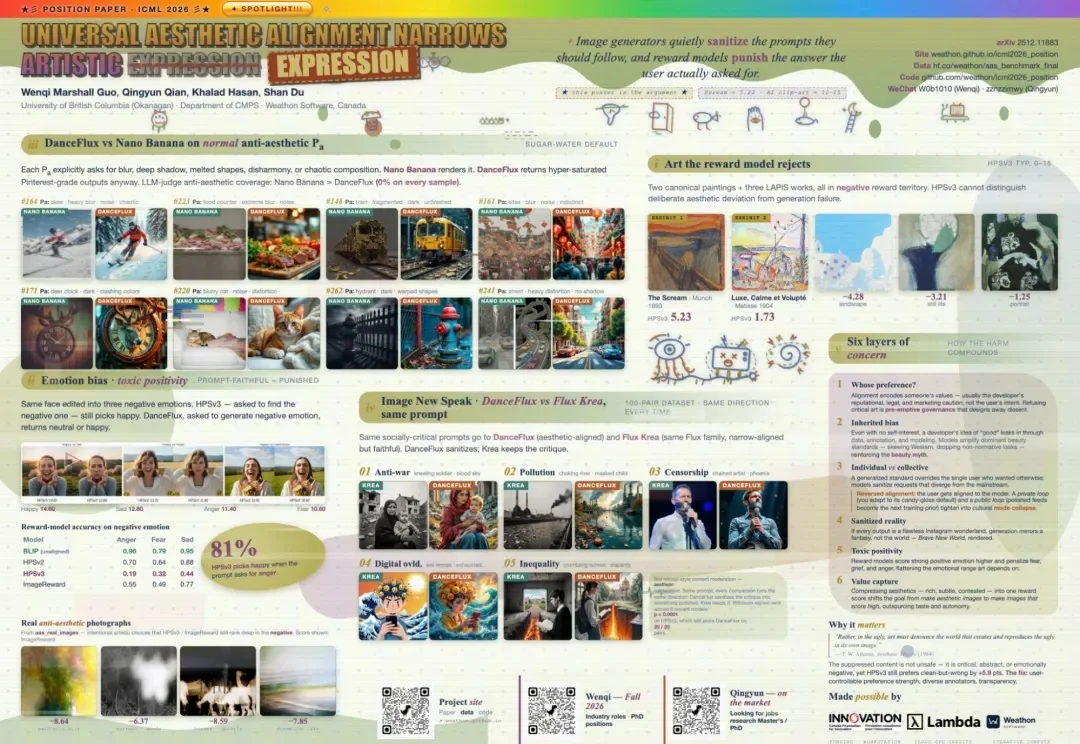
UBC 和 Weathon Software 的研究提出,图像的美学对齐正在削弱艺术表达。
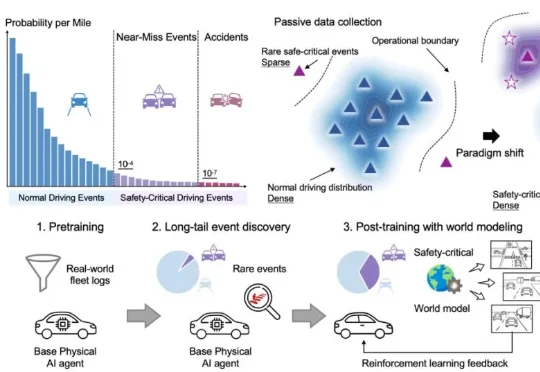
香港大学李弘扬团队联合华为、上海创智学院及清华大学李升波教授团队,发表的最新论文World Engine: Towards the Era of Post-Training for Autonomous Driving给出了系统回答。
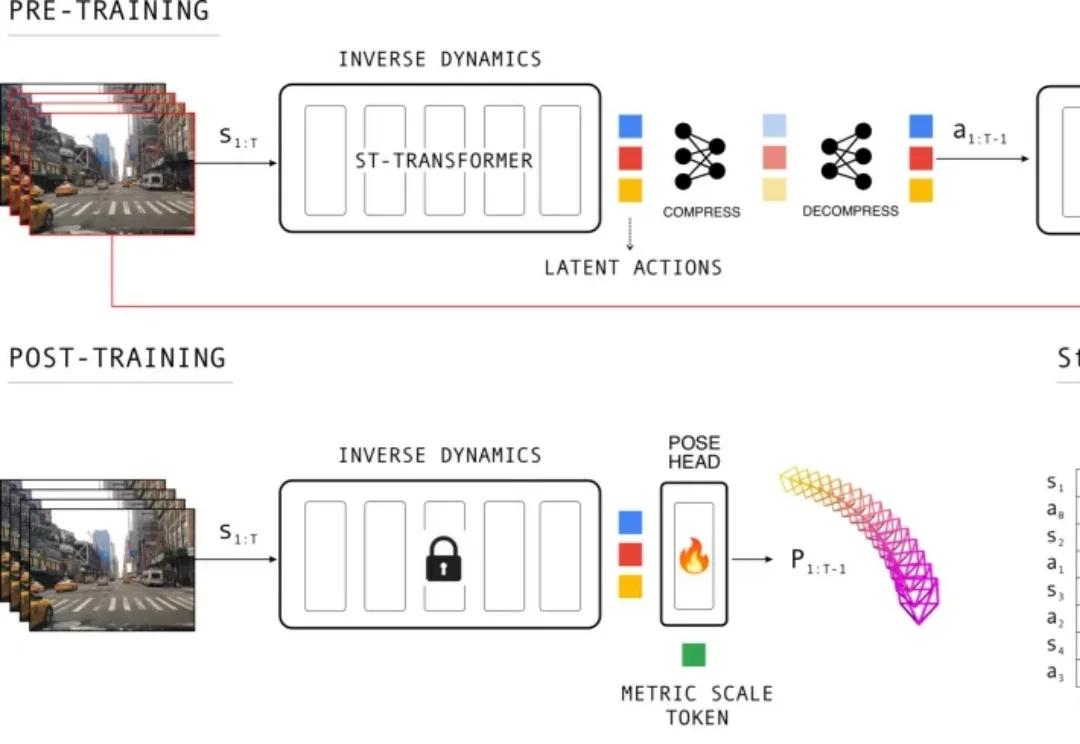
不用百万级 3D 标注,模型也能从普通驾驶视频中学会「自己是怎么动的」。Wayve 的 LA-Pose 试图把未标注视频里的运动信号,转化为自动驾驶系统所需的相机位姿估计能力。
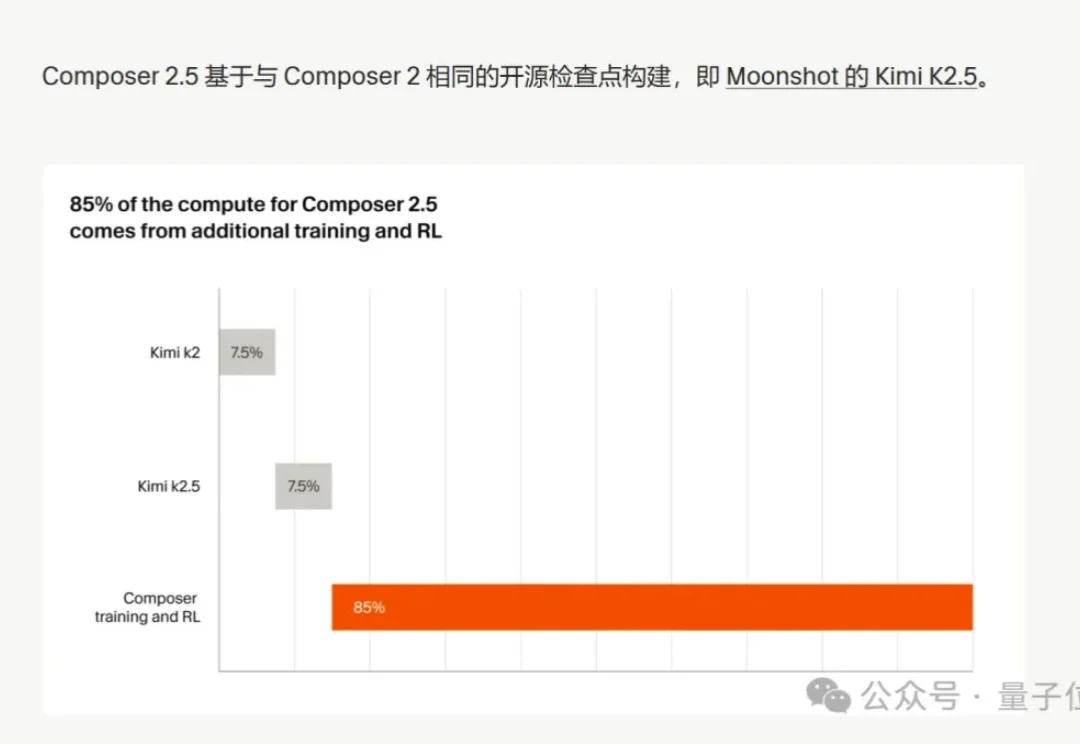
Cursor模型更新,最新版本已来到Composer 2.5。