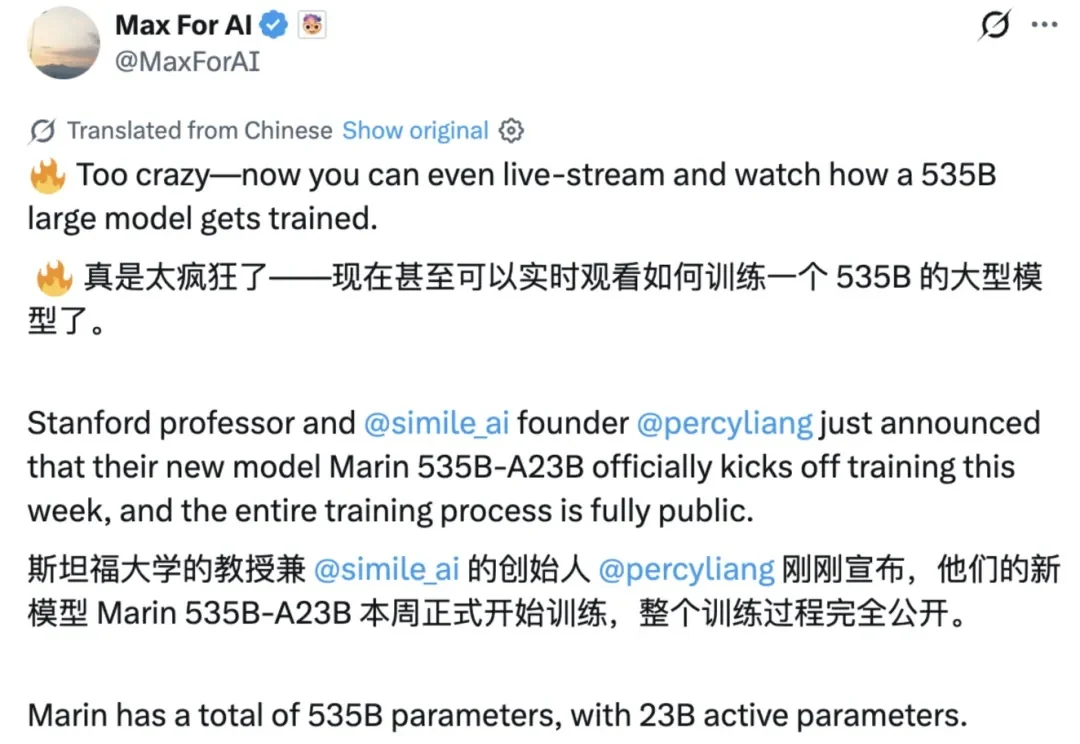
斯坦福教授直播训练535B大模型,模型训练背后的「黑箱」正在被打开?
斯坦福教授直播训练535B大模型,模型训练背后的「黑箱」正在被打开?最近两天,X 上网友 Max For AI@MaxForAI 的一篇帖子引发了网友热议:「太疯狂了 —— 现在你甚至可以直播围观一个 535B 大模型是如何被训练出来的。」
来自主题: AI资讯
9700 点击 2026-08-25 11:41

 搜索
最近两天,X 上网友 Max For AI@MaxForAI 的一篇帖子引发了网友热议:「太疯狂了 —— 现在你甚至可以直播围观一个 535B 大模型是如何被训练出来的。」
这期节目的嘉宾黄东旭,就是Token Maxing热潮的亲历者。他曾经只用最前沿的模型,每天账单三四百美元。让他转变的,是前沿模型的智力碾压和中国开源模型们的崛起——Fable 5可以一句话终结Agent群的讨论,同时大量的日常任务可以做到“只烧电费,不烧Token”。他的结论是:不是前沿模型用不起,而是本地开源模型底座+前沿模型的搭配,成本可控,更具性价比。

当一个视频模型和 Seedance 2.5 同一天发布,似乎大概率要成炮灰,但 MiniMax H3 却成了一个例外。而现在 MiniMax 也开始把这种模型的能力,放到了具体的产品上,正式推出了 MiniMax Design,进一步把 H3 视频模型的能力放大,同时也让我们少折腾一些,可以更高效地制作各种商业化内容。

DeepSeek V4 Pro,可能又又又更新了。今天下午,有用户在技术社区 Linux.do 发帖称,自己在DeepSeek Harness标准模式、V4 Pro Max思考档位下,发现模型的思维链突然变了。

刚把M3、Agent几条线推上新阶段—— MiniMax一位核心工程负责人离职了。 近日有网友发现,MiniMax Agent工程部主管阿岛(缪宇航)的飞书状态目前已经显示离职,下一站暂未公开。

8月13日凌晨,DeepSeek V4 Pro正式登场,给开源模型生态又添一把猛火。从Kimi K3到MiniMax H3,再到DeepSeek V4 flash、DeepSeek V4 Pro,在中国开源模型的猛攻之下,美国的AI公司这次是真的坐不住了。

视频模型这个月很热闹。7 月 31 日,MiniMax H3 和字节跳动 Seedance 2.5 同日发布。3 天后,MiniMax H3 正式开源;8 月 7 日,Seedance 2.5 开放 api。模型越来越好了,但产品能把它用好吗?

刚刚,阿里千问大模型团队开放Qwen3.8-2.4T-A95B模型权重! Qwen3.8-Max是基于Qwen3.8-2.4T-A95B的官方版本,于8月3日发布,拥有更多功能,例如视觉输入功能、无需思考即可使用、默认支持1百万上下文长度处理、内置官方工具等。

MiniMax 过去一年的 agent 实践,从一个内部飞书 bot 开始,演化成了桌面应用 MiniMax Code,最终形成了一个训练-服务的闭环:模型在自己的 harness 里训练,通过 harness 服务用户,用户行为变成训练信号反哺下一个模型。这个闭环是模型公司设计 Agent 的核心逻辑。

MiniMax 在发布说明里直接用了两个词:Rebuilt on Pi Agent,基于开源 Pi Agent 框架重构;宣传图上写得更干脆,Rebuilt from the Core,从核心重建。对 Node.js 开发者来说,这件事比又一款 AI 编程工具上线更有意思。