OpenAI的强化微调:RL+Science 创造新神还是灭霸?
OpenAI的强化微调:RL+Science 创造新神还是灭霸?2024 年 12 月 6 号加州时间上午 11 点,OpenAI 发布了新的 Reinforcement Finetuning 方法,用于构造专家模型。对于特定领域的决策问题,比如医疗诊断、罕见病诊断等等,只需要上传几十到几千条训练案例,就可以通过微调来找到最有的决策。
来自主题: AI技术研报
9937 点击 2024-12-08 14:19

 搜索
2024 年 12 月 6 号加州时间上午 11 点,OpenAI 发布了新的 Reinforcement Finetuning 方法,用于构造专家模型。对于特定领域的决策问题,比如医疗诊断、罕见病诊断等等,只需要上传几十到几千条训练案例,就可以通过微调来找到最有的决策。
OpenAI“双12”直播第二天,依旧简短精悍,主题:新功能强化微调(Reinforcement Fine-Tuning),使用极少训练数据即在特定领域轻松地创建专家模型。少到什么程度呢?最低几十个例子就可以。
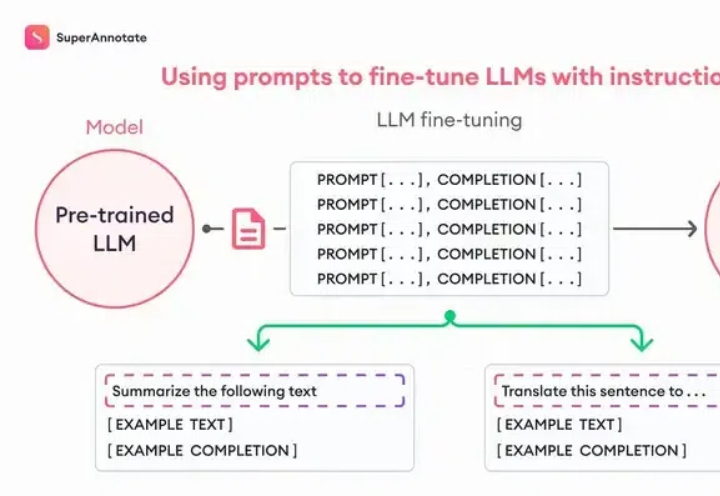
Fine-tuning理论上很复杂,但是OpenAI把这个功能完善到任何一个人看了就能做出来的程度。我们先从原理入手,你看这张图,左边是Pre-trained LLM (预训练大模型模型),也就是像ChatGPT这样的模型;右边是Fine-tuned LLM (微调过的语言大模型),中间就是进行微调的过程,它需要我们提供一些「ChatGPT提供不了但是我们需要的东西」。
这是一个不容小觑的最新推理框架,它解耦了LLM的记忆与推理,用此框架Fine-tuned过的LLaMa-3.1-8B在TruthfulQA数据集上首次超越了GPT-4o。
上月,一家名叫Kick的硅谷AI记账自动化公司宣布完成900万美元种子轮融资。尽管AI/FinTech领域一直是热门吸金板块,但Kick因其特殊的融资背景格外引人注目,因为它是OpenAI Startup Fund最早期的投资组合之一。
近日,美国AI独角兽Afiniti向法院申请破产保护,成为最新一家走向破产的“老牌AI初创公司”。

MME-Finance 是一个专为金融领域设计的多模态基准测试,由同花顺财经旗下的 HiThink 研究团队联合多家高校共同开发,旨在评估和提升多模态大型语言模型(MLLMs)在金融领域的专业理解和推理能力。
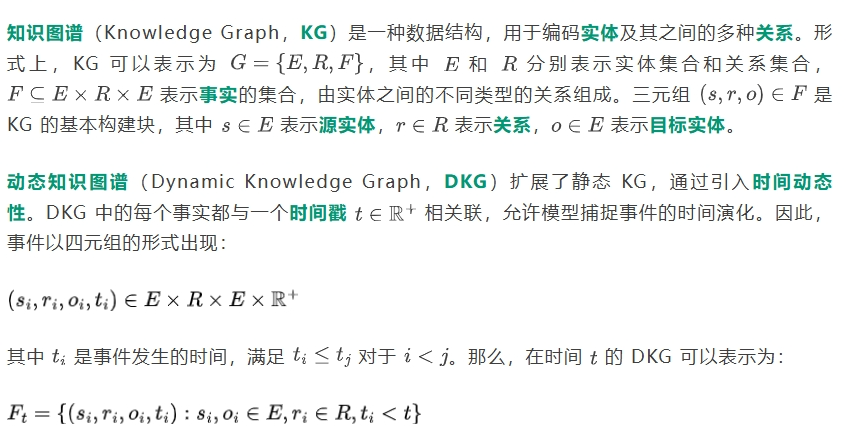
在金融市场中,动态知识图谱(Dynamic Knowledge Graphs,DKGs)是一种表达对象之间随时间变化的多种关系的流行结构。它们可以有效地表示从复杂的非结构化数据源(如文本或图像)中提取的信息。在金融应用中,基于从金融新闻文章中获取的信息,DKGs 可用于检测战略性主题投资的趋势。
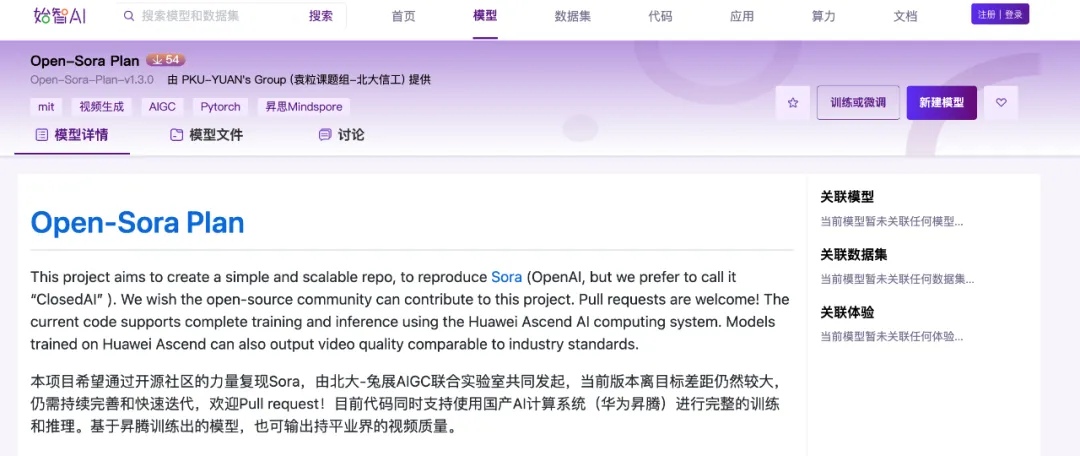
Open-Sora-Plan迎来又一次升级。新的Open-Sora-Plan v1.3.0版本引入了五个新特性:性能更强、成本更低的WFVAE;Prompt refiner;高质量数据清洗策略;全新稀疏注意力的DiT,以及动态分辨率、动态时长的支持。

在当前内卷严重的实时目标检测 (Real-time Object Detection) 领域,性能与效率始终是难以平衡的核心问题。绝大多数现有的 SOTA 方法仅依赖于更先进的模块替换或训练策略,导致性能逐渐趋于饱和。