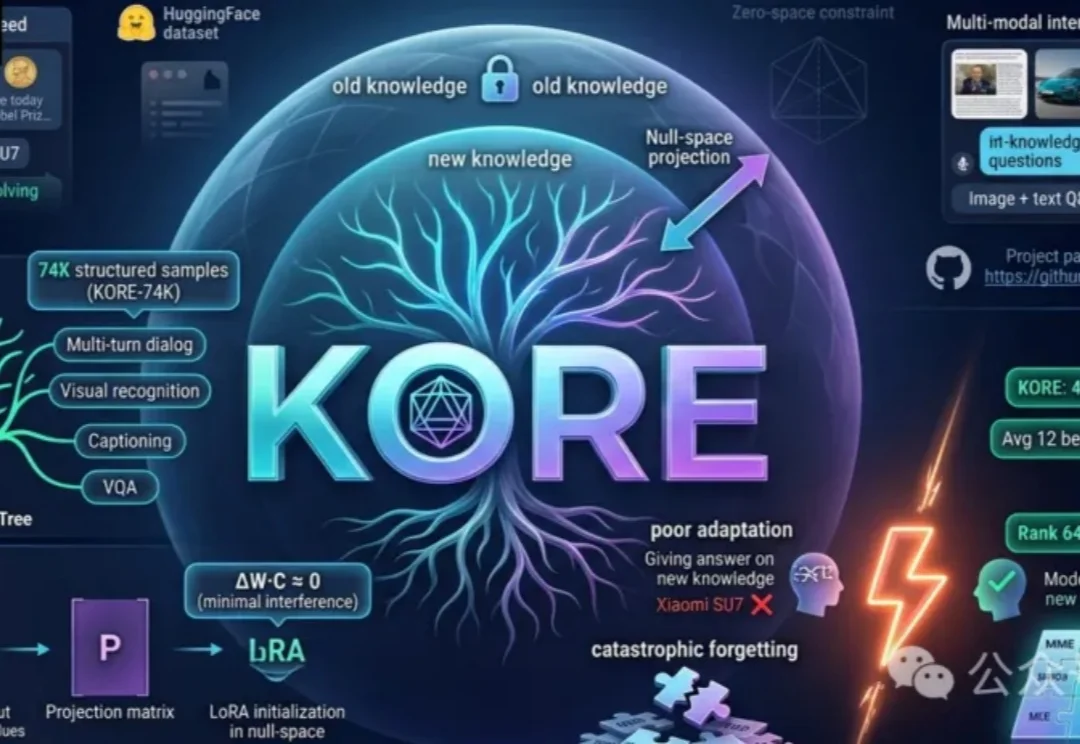
教大模型终身学习!中科大连发两篇顶会,突破「知识注入」双重困境
教大模型终身学习!中科大连发两篇顶会,突破「知识注入」双重困境中科大团队首先推出动态多模态知识注入基准MMEVOKE,解构遗忘机制,并在此基础上提出全新双阶段框架KORE。通过「知识树」自动增强与「零空间」协方差约束微调,为大模型终身学习开辟了全新路径。
来自主题: AI技术研报
11282 点击 2026-05-22 09:28

 搜索
中科大团队首先推出动态多模态知识注入基准MMEVOKE,解构遗忘机制,并在此基础上提出全新双阶段框架KORE。通过「知识树」自动增强与「零空间」协方差约束微调,为大模型终身学习开辟了全新路径。
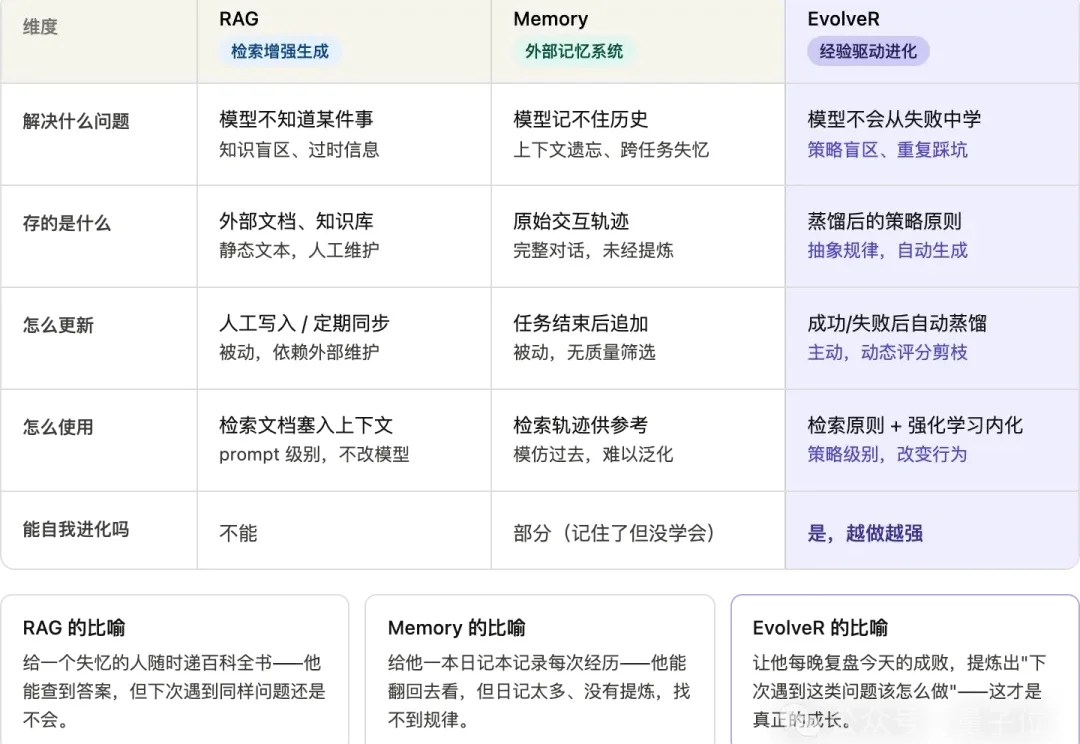
过去一年,Agent学会了两件事:会用工具、会调用Skill。
AI创造生命的一大步!斯坦福团队用AI造出从零写出16种噬菌体,内含地球前所未有的蛋白,Anthropic CEO预警:6到12个月,傻子也能造超级病毒。
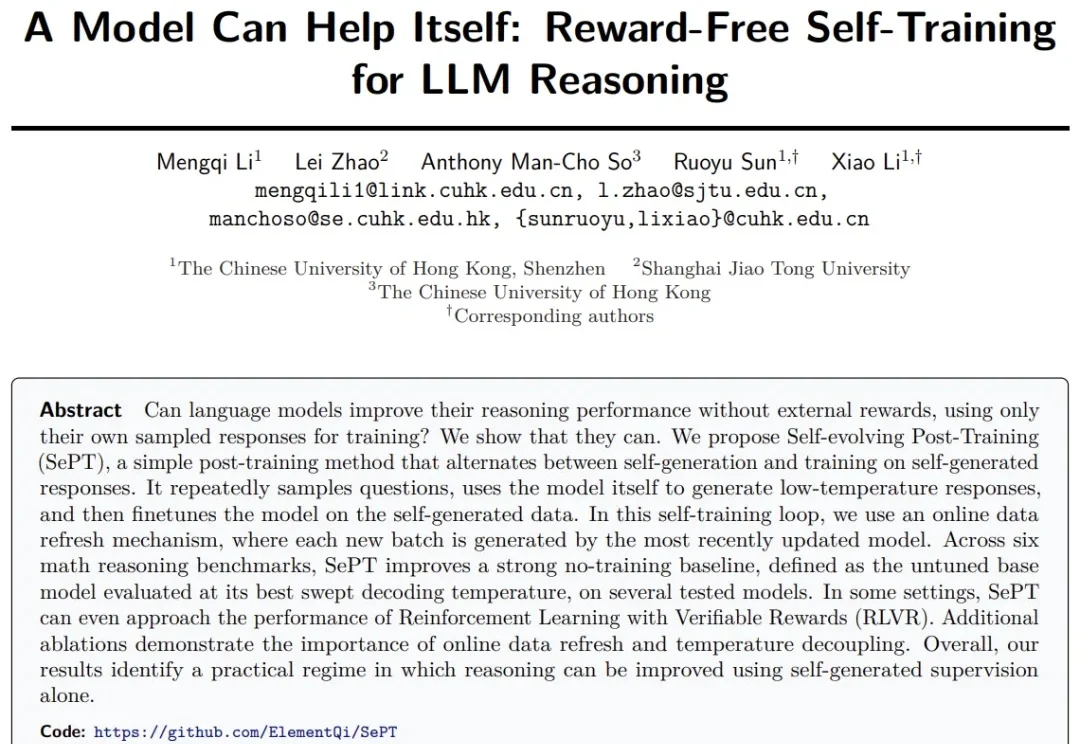
在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!
Hermes Agent最近在AI圈彻底火了。
随着新一代主动执行型 Agent(如 OpenClaw、Hermes Agent 等)的爆发,AI 正经历从「被动工具」向「具备自我演化(Self-Evolving)能力的智能体」的范式跃迁。然而,受限于上下文窗口极限与记忆缺失,现有 Agent 难以在复杂任务中实现经验的复用与自我进化。
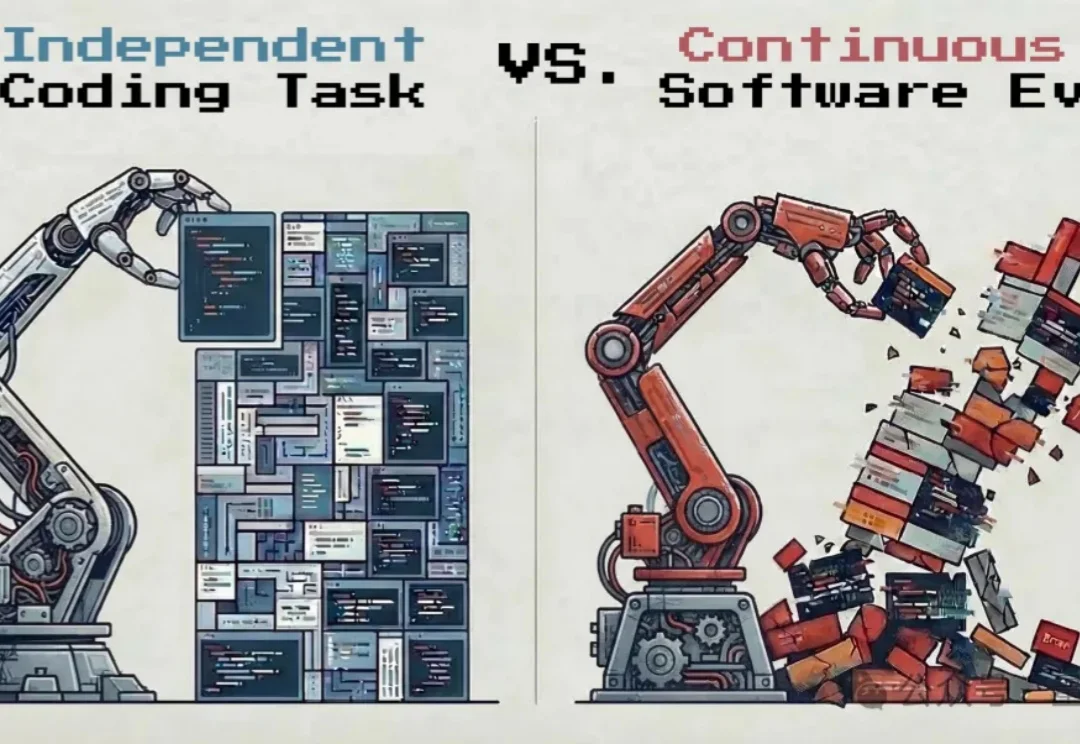
到2025年末,AI编程已经全面从辅助工具Copilot,转向以AI为主、人类监督的Agent时代。
您用OpenClaw或CC时有没有这样的感受?Skill越装越多,Agent解决问题的能力却没有越变越强。
我们推出GLM-5-Turbo——一个面向OpenClaw龙虾场景深度优化的基座模型。 体验过OpenClaw的用户都有一个共同感受:模型能聊好天,但未必能干好活。问题的根源不在框架,而在底层模型本身
谷歌DeepMind又放大招了:AlphaEvolve自主写算法,一口气改写5个经典拉姆齐数下界,打破了尘封十年的数学纪录!诺奖得主Hassabis和图灵奖得主LeCun都纷纷点赞——AI,正在彻底改变数学突破的方式!