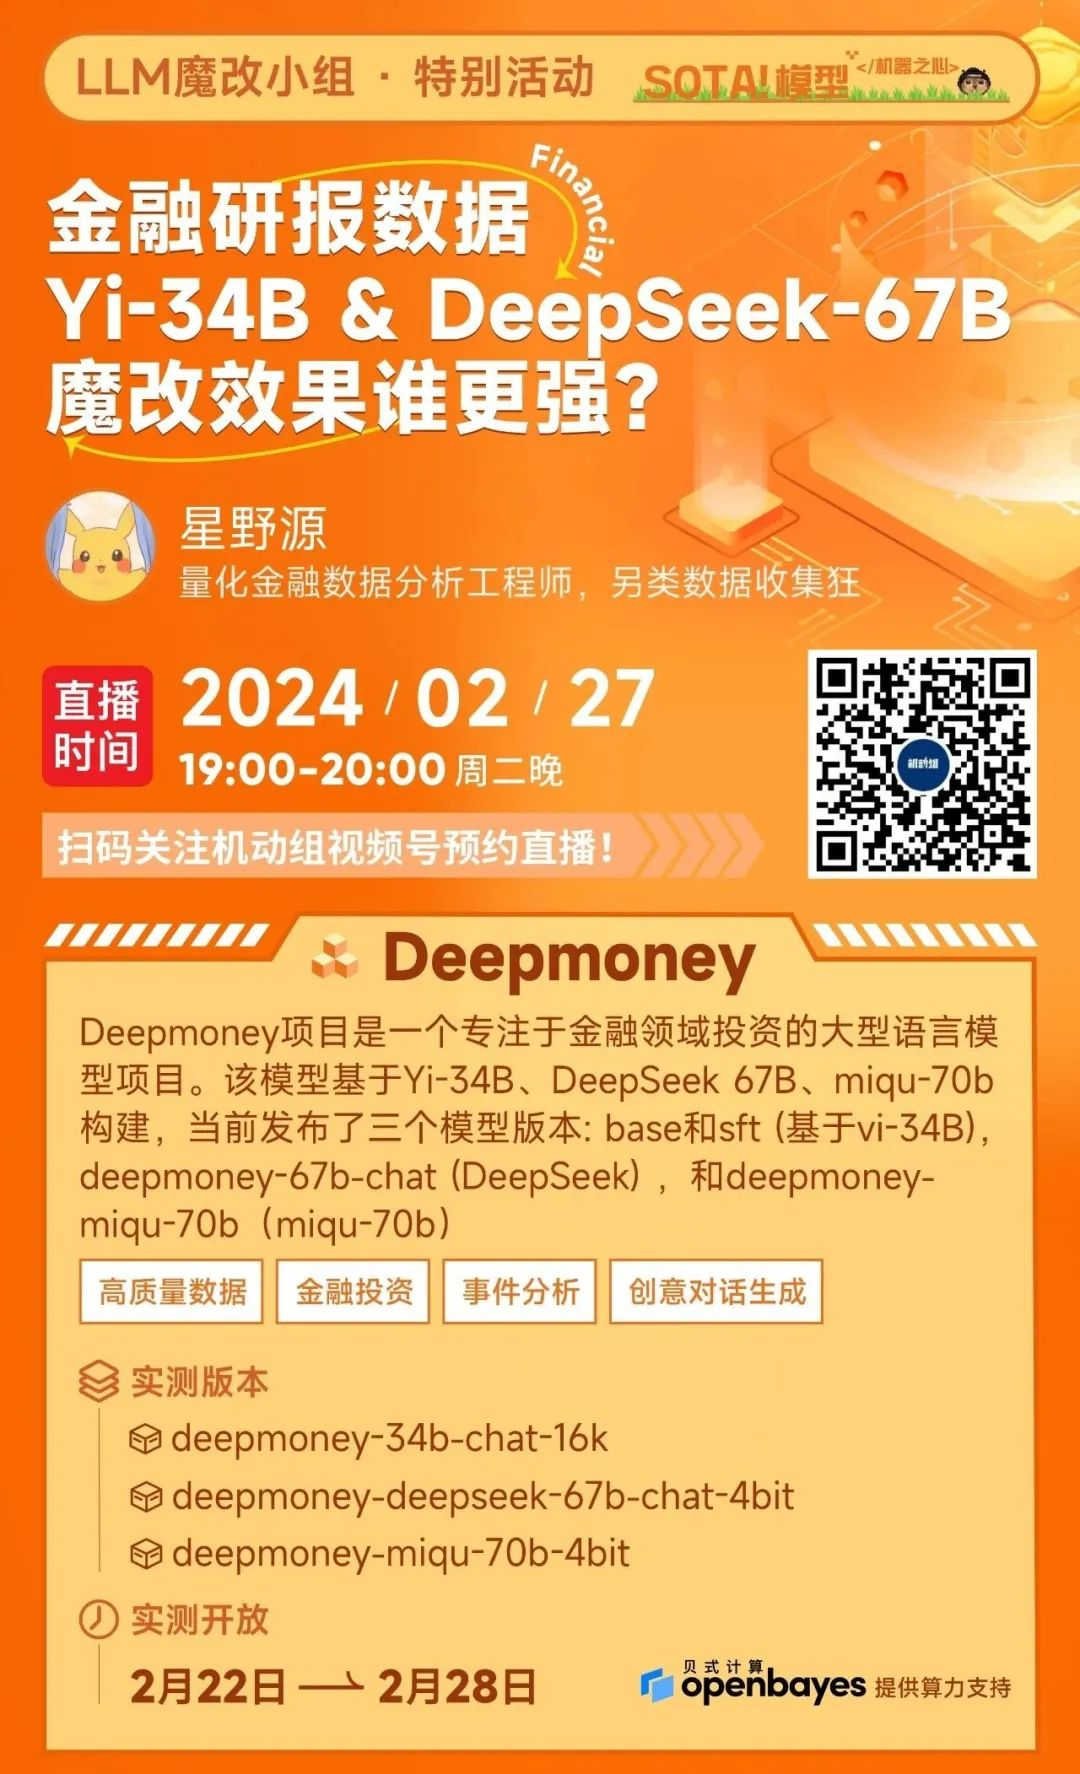
金融研报数据魔改Yi-34B & DeepSeek 67B 谁更强? Deepmoney金融大模型魔改方案分享&在线实测
金融研报数据魔改Yi-34B & DeepSeek 67B 谁更强? Deepmoney金融大模型魔改方案分享&在线实测在微调大型模型的过程中,一个常用的策略是“知识蒸馏”,这意味着借助高性能模型,如GPT-4,来优化性能较低的开源模型。这种方法背后隐含的哲学理念与logos中心论相似,把GPT-4等模型视为更接近唯一的逻辑或真理的存在。
搜索
在微调大型模型的过程中,一个常用的策略是“知识蒸馏”,这意味着借助高性能模型,如GPT-4,来优化性能较低的开源模型。这种方法背后隐含的哲学理念与logos中心论相似,把GPT-4等模型视为更接近唯一的逻辑或真理的存在。
大模型内卷时代,也不断有人跳出来挑战Transformer的统治地位,RWKV最新发布的Eagle 7B模型登顶了多语言基准测试,同时成本降低了数十倍
上周,来自《华尔街日报》的报道,Sam Altman 正在与包括阿联酋政府在内的投资者进行谈判,筹集高达 7 万亿美元的资金,以增加全球半导体芯片的供应。
遍地开花?大力出奇迹?字节投身AI洪流。没有人能说清楚这次 AI 带来的爆发机会在哪,但每家公司都害怕错过、尤其是大厂。
据外媒报道,软银CEO孙正义的成功,在很大程度上归功于他在互联网时代对阿里巴巴颇具先见之明的押注,如今,他希望再复制一次这种投资“神话”。
最近,UIUC苹果华人提出了一个通用智能体框架CodeAct,通过Python代码统一LLM智能体的行动。
OpenAI宣布要建立价值7万亿美元的AI芯片基础设施,并面临芯片短缺问题。同时,OpenAI每天能创造约1000亿字的内容,超过全球人类的总产量。
OpenAI 的 CEO 山姆・奥特曼(Sam Altman)引领了近期生成式 AI 的大发展。最近,他又有了一个宏伟目标:重塑全球半导体行业。
混合专家(MoE)架构已支持多模态大模型,开发者终于不用卷参数量了!北大联合中山大学、腾讯等机构推出的新模型MoE-LLaVA,登上了GitHub热榜。
7B开源模型,数学能力超过了千亿规模的GPT-4!它的表现可谓是突破了开源模型的极限,连阿里通义的研究员也感叹缩放定律是不是失效了。