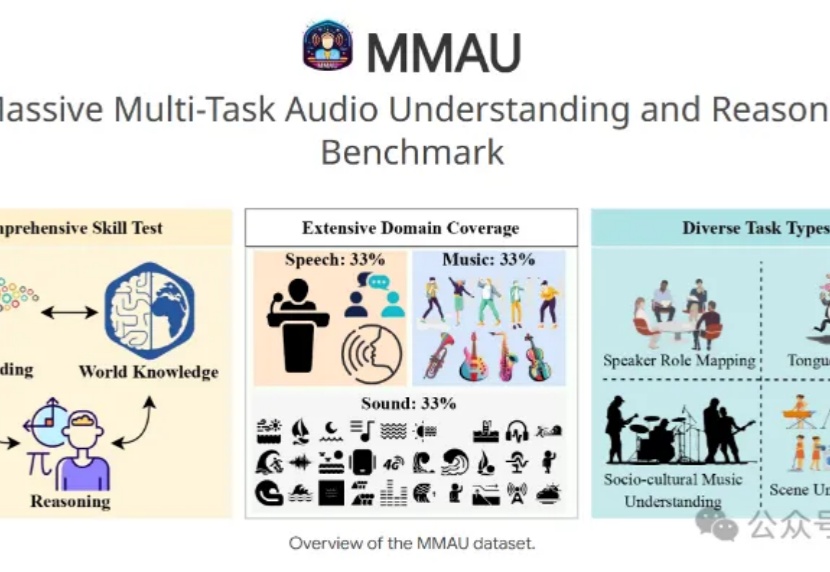
迁移DeepSeek-R1同款算法,小米让7B模型登顶音频理解推断MMAU榜单
迁移DeepSeek-R1同款算法,小米让7B模型登顶音频理解推断MMAU榜单7B小模型+3.8万条训练数据,就能让音频理解和推断评测基准MMAU榜单王座易主?
来自主题: AI技术研报
5172 点击 2025-03-17 10:52

 搜索
7B小模型+3.8万条训练数据,就能让音频理解和推断评测基准MMAU榜单王座易主?
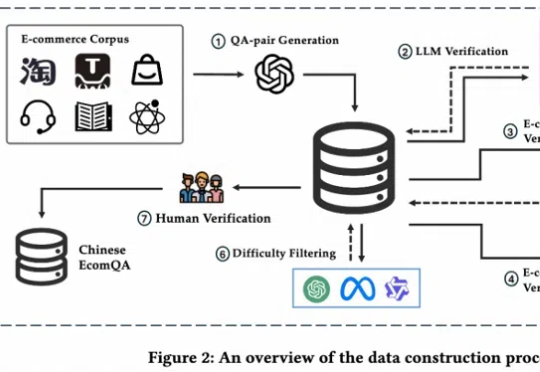
全面评估大模型电商领域能力,首个聚焦电商基础概念的可扩展问答基准来了!
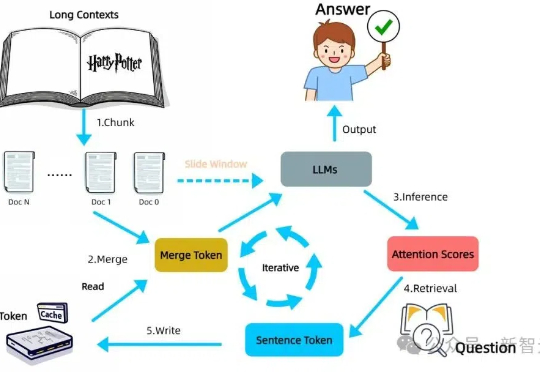
LLM自身有望在无限长token下检索信息!无需训练,在检索任务「大海捞针」(Needle-in-a-Haystack)测试中,新方法InfiniRetri让有效上下文token长度从32K扩展至1000+K,让7B模型比肩72B模型。

今年,CVPR共有13008份有效投稿并进入评审流程,其中2878篇被录用,最终录用率为22.1%。
30天学会编程、7天AI入门、40分钟教会你如何使用DeepSeek!不要998、不要88,现在只要9.8就能轻松入门!对于这些宣传语,相信很多人都不会陌生。每一次有新的技术和商业风口出现时,相关的网络课程就会从四面八方出现,以各种方式完成收割。
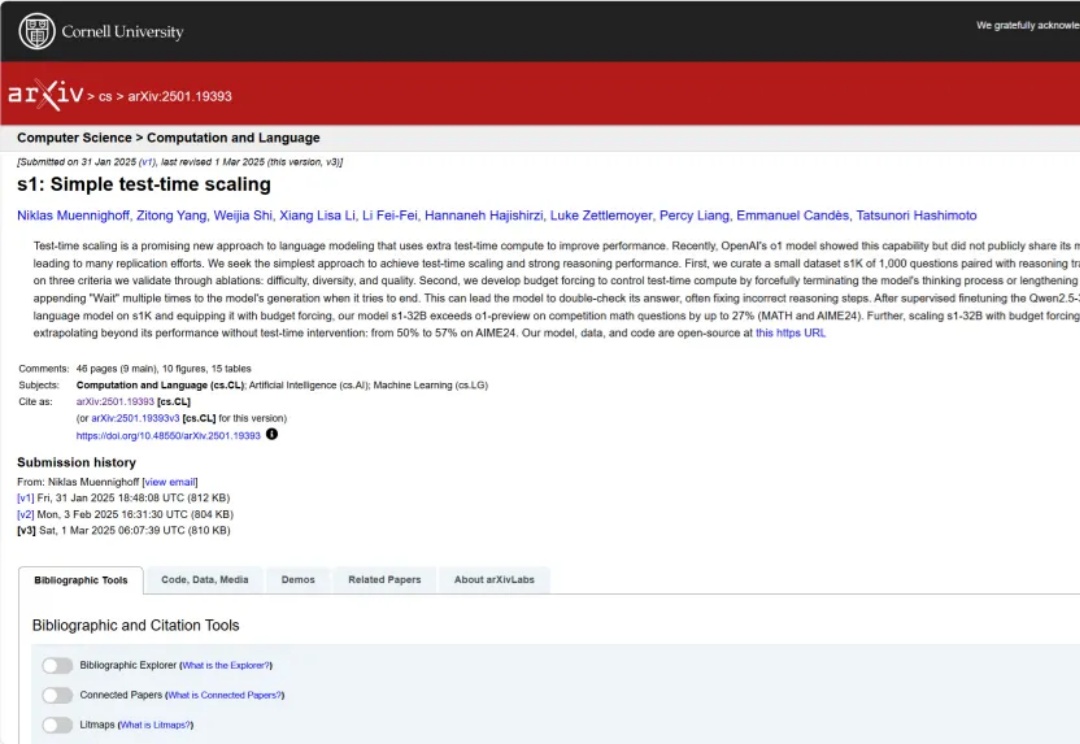
现在是 2025 年,新论文要以博客形式出现。

融资7个月未果,一家AI创企选择卖身。

干掉英特尔之后,苏妈又向英伟达发起猛攻!最新发布的48G两款GPU基准测试,AI性能相较4090飙升7.3倍。看来AMD这次是铁了心,要跟英伟达掰手腕了。
在去年7月11日中午收到那条信息之前,马修·范·安德尔(Matthew Van Andel)的生活一直非常规律且安稳。他就职于一个著名的跨国媒体集团,担任施工经理的工作。
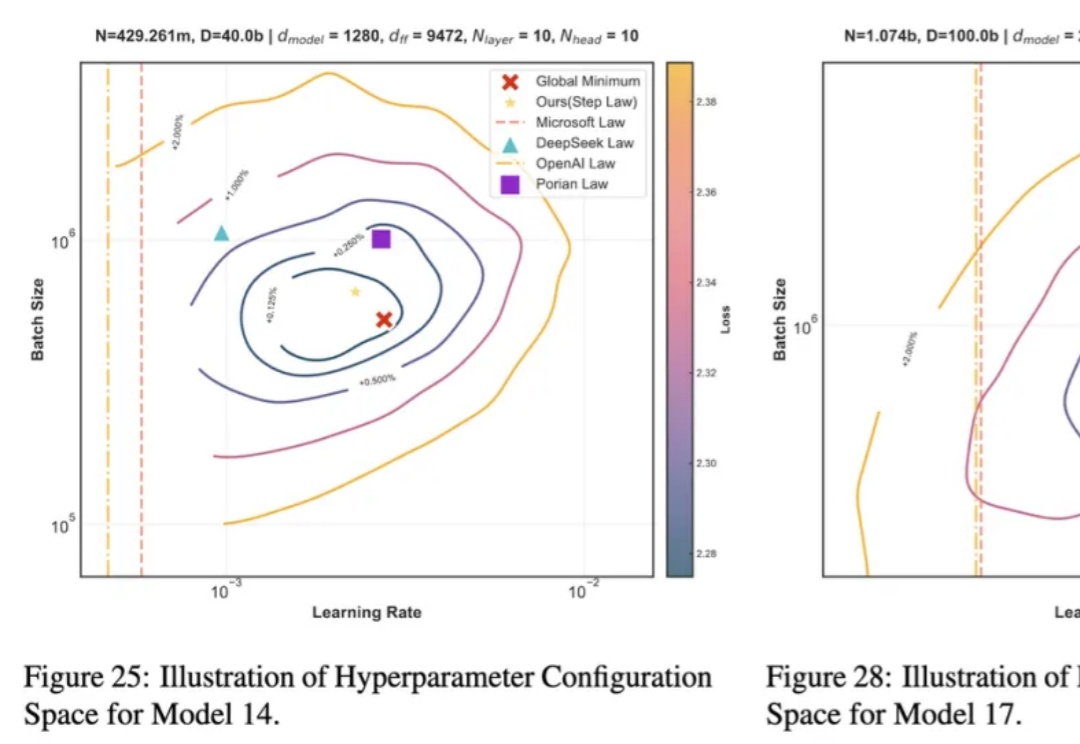
近年来,大语言模型 LLMs 在多种任务上的卓越表现已得到广泛认可。然而,要实现其高效部署,精细的超参数优化至关重要。为了探究最佳超参数的规律,我们开展了大规模的实证研究,通过在不同配置上进行网格搜索,我们揭示了一套通用的最优超参数缩放定律(Optimal Hyperparameter Scaling Law)。