GLM-5.3-FlashX 上线:200 tokens/s
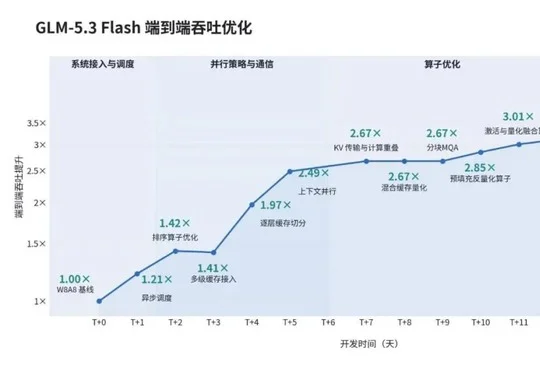
GLM-5.3-FlashX 上线:200 tokens/s智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
搜索
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
清华校友Sihao Huang出任Anthropic前沿计算战略负责人,搭档GPT-3一作、Anthropic首席算力官Tom Brown,负责算力扩张与产业合作联盟建设,成为Anthropic已知公开职级最高的华人。
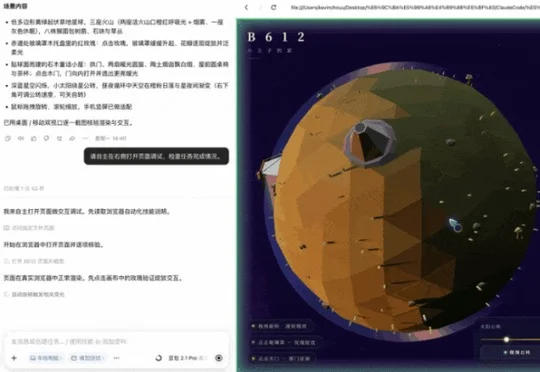
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
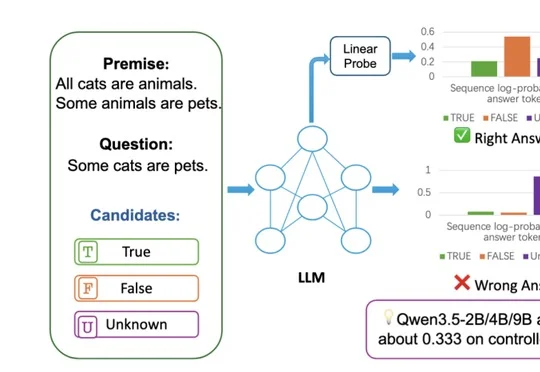
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
Kimi发布编程工具Kimi Code桌面版,原生适配macOS和Windows,内置Kimi K3模型并支持第三方API接入及Computer Use功能,提供99至699元三档订阅套餐,实测体验流畅。
就在十天前,一部AI短片,在整个AI圈炸了。AI超创DiDi_OK的《网站》,在2026年威尼斯Reply AI Film Festival上拿了双料大奖。76个国家、3100多部作品里杀出来,评委阵容里坐着奥斯卡得主和《狮子王》联合导演。
AI存储进入全流程竞争。
只用1300张H200,在一项硬核科学基准上,赢了GPT-6 Astra。
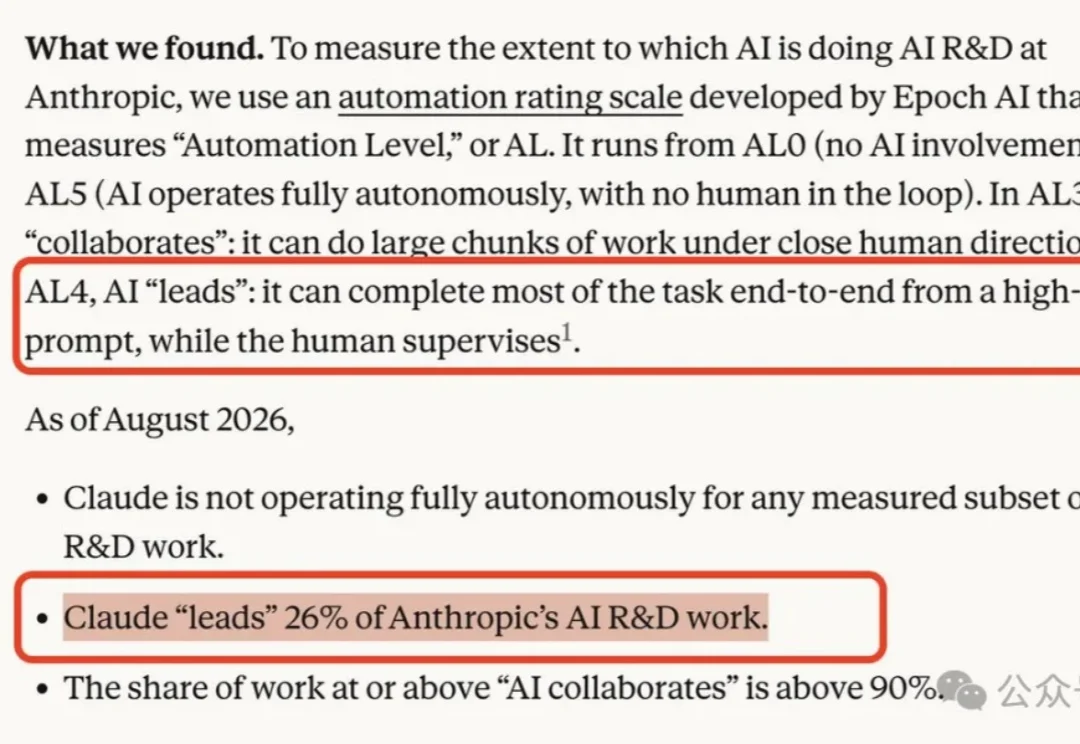
刚刚,Anthropic首次自曝绝密底牌:3万个AI正在研发下一代自己,正在疯狂自我进化。